

约 20 分钟的 AI 短片《ANERNEQ》,把这些容易被一句“电影感、超写实”盖过去的问题,拆成了可以持续检查的制作条件。它用角色资产维持身份,用 Blender 确定空间,用 Claude 保存项目规则,再把 Seedance 中的对白、动作与表演写进每一个镜头。
真正让人物活起来的,并不是某一次漂亮的生成。
而是镜头之间没有断掉的规则。
先弄清人物为什么行动
《ANERNEQ》的故事发生在 20 世纪 20 年代的楚科奇地区。18 岁的 Tyne 带着因悲痛而精神失序的父亲 Omryn 穿越冰原,前往鲸骨巷,希望在那里救回他。
故事经过放逐、冰窟与鲸骨巷三个主要段落。旅途中,父亲逐渐把女儿误认成亡妻;女儿则必须面对救赎可能带来的代价,以及最终的失去。
项目公开简报特意说明,片中的服饰、仪式与语言是对北方文化的综合创作,并不是对某一个民族的完整复原。这条边界很重要:它决定了观众应该如何理解这个虚构世界,也提醒创作者,世界观不能只靠视觉符号拼贴出来。
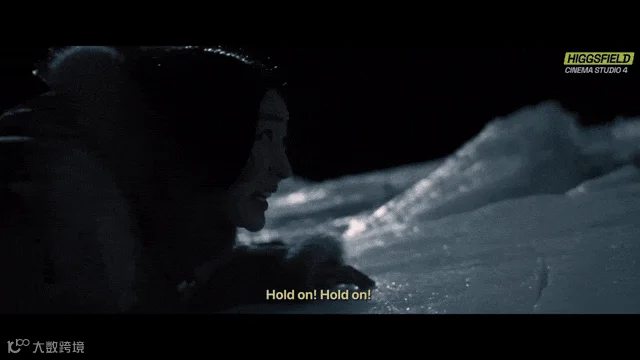
片中的技术选择都围绕人物的处境展开。辽阔冰原用来衬出人的渺小,手持摄影跟随身体移动,呼吸、风声和雪橇摩擦把寒冷变成可感知的东西。
所以,制作的起点不是先选模型,也不是先写一段漂亮提示词。
先要回答:角色在这一场戏里想完成什么?镜头又该怎样让观众看懂这件事?
让动作真的碰到世界
项目简报花了相当多篇幅处理日常动作。鼓、刀具、生火工具、雪橇、探冰杆、石灯、水囊和靴子,都不只是画面里的陈设,它们必须对应具体用途。
以生火为例,动作没有被压缩成一句“点燃篝火”。人物要准备工具,持续钻动,先出现烟,再形成火种,最后把火引起来。工具彼此配合,火焰也有一个从无到有的过程。
这段过程看似琐碎,却在悄悄完成一件事:让观众相信,这个角色确实知道如何在这里活下去。
拖雪橇也是一样。如果提示词只写“她艰难前行”,模型很可能只会给出一个走得比较慢的人。《ANERNEQ》把困难写成身体与阻力的关系:躯干前倾,肩带受力,人物迈出几步,滑橇被硬雪卡住,她再次俯身发力。
躺在雪橇上的父亲也不能静止不动。女儿每拉动一次,父亲的身体都应该产生相应变化。一个人在发力,另一个人的重量必须在画面里留下后果。

可信的动作有三个条件:接触、阻力和结果。
人物握住了什么?什么东西阻止了他?动作发生以后,身体、物体或环境改变了什么?如果画面里只有姿势,没有反作用,观众看到的就仍然是一场表演动作的演示。
先锁定这个人,再改变他的状态
对一部持续十几分钟的作品来说,单镜头好看远远不够。观众必须在不同景别、不同光线和不同剧情状态里,持续认出同一个人。
《ANERNEQ》把角色、场景、道具和动物整理成“文字描述+图片”的资产组合,并使用统一标签。标签贯穿资产库、提示词和制作表,避免同一个对象在不同环节被重新命名。
角色的制作顺序尤其清楚:先生成脸部近景,确定身份;再围绕这张脸建立全身外观、服装、材料和轮廓。原始脸部近景作为基准保留,霜冻、污渍和伤痕等剧情状态尽量局部增加,而不是每次都重做整张基准图。
这相当于把两个问题分开管理:这个人是谁,以及这个人此刻经历了什么。
衣服的磨损、脸部纹理、发型和身体轮廓,都是观众识别角色的线索。项目一长,角色资产就不能只是一组“看起来差不多”的图,而要变成能追溯的版本。
一份可用的资产表,至少要让每个对象拥有统一名称、基准图和稳定描述;状态变化另列版本,并与实际镜头关联。这样,当某一场戏需要修改时,团队才知道哪些材料应该一起更新。
Blender 不负责漂亮,先负责把关系摆对
在这个项目里,Blender 的任务很克制:搭出场景,确定大小、距离、站位、朝向、遮挡、机位和光源。
人物可以只是简单几何体,帐篷可以只是低矮方块,道具也不必精细。重要角色用不同颜色标记,人群保持相对统一的颜色,目的只是检查主体能否从背景中被看见。
光源也会在预演阶段摆进去。火在哪里,能照到谁,哪些区域应该留在黑暗里,都先在空间里找到依据。
关键不在于把灰模画面做得多像成片,而在于把 Blender 里的空间关系转写成文字与数字,再放进提示词的几何锚点模块。灰模主要服务于构图与空间判断;如果直接把它当成视觉参考,生成模型反而可能复制灰色塑料般的材质。
在一个双人镜头样例中,简报把关系写得很具体:人物分别处于画面哪一侧,脸部相距约 30 厘米,摄影机距离约 1.2 米,相对人物轴线又是什么角度。
这些数字不是为了炫技。它们把“画面不对”变成了可以修改的问题:究竟是人物离得太远,还是摄影机位置错了?
预演真正提供的,是一套可重复调整的坐标。
Claude 保存规则,镜头才不会各拍各的
项目里的 Claude 依靠一份专用 Skill 工作。这份 Skill 更像一本不断复用的制作手册:里面放着资产描述、镜头模板、声音设定、语言词典、剧本、表演方法,以及不同场面的限制。
它解决的不是“帮我写一句提示词”,而是让每个新镜头都带上同一组已经确认的条件。
简报使用固定顺序的 20 个提示词模块。它们大致覆盖:镜头中有哪些角色和资产;画面从哪里开始;谁做什么、说什么;摄影机怎样观察;光线、镜头质感、皮肤和材料如何保持一致;身体怎样受力;表演怎样推进;声音来自哪里;镜头时长与空间参数是什么;这一镜又最容易错在哪里。
其中,风格、灯光、变形宽银幕效果和画面质感等固定模块,会在不同镜头中重复使用。原因很直接:只写“延续上一镜”,并不会自动把上一镜的服装、道具、光线、声音和空间关系完整带进当前输入。
长片需要模板,也需要版本管理。
当固定规则发生变化,新的描述必须注明适用场景和版本。否则,多套互相冲突的条件很容易同时进入一个镜头,最后得到的不是连续性,而是平均化的混乱。
情绪不是一个词,而是一串有代价的动作
《ANERNEQ》有一场很能说明问题的戏:父亲把女儿误认成妻子,伸手去触摸她的脸。女儿已经察觉,却没有立刻纠正,而是停住身体,顺着父亲的认知回应。
这场戏没有把控制重点放在“悲伤”“克制”这类抽象情绪词上,而是放在动作和反应上。
父亲想确认眼前的人是否真实,因此抬手触碰;因为身体虚弱,他抬手缓慢,手指僵硬。女儿想安抚父亲,于是压住本能反应,让自己的脸继续留在那只手里。
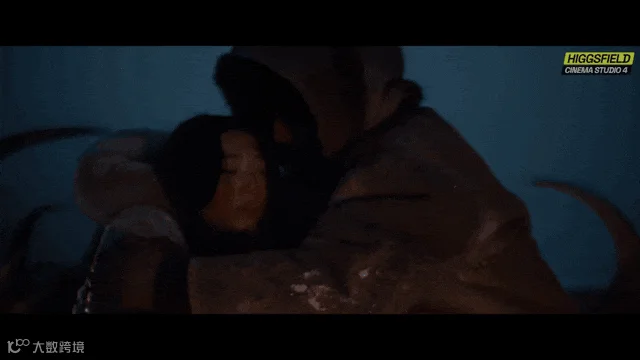
观众读到的情绪,来自人物为了完成动作付出的代价。
项目因此用目标、障碍与策略来组织表演,再加上少量非自主反应:迟来的眨眼、短暂屏息、下颌轻微绷紧。情绪被拆成可见变化以后,镜头才真正有东西可拍。
眼神也按同样的方式处理。所谓“目光呆滞”,可以继续拆成更具体的问题:瞳孔是不是完全不动?眨眼是不是过于机械?眉眼和嘴部是不是整齐地同时变化?不同角色分别写反应,能减少整张脸一起动起来的假感。
项目里的骨质雪镜还承担了一个实用功能:在合适场景中遮住部分眼部,把表演压力转移到呼吸、嘴部和身体上。这不是一条通用捷径,而是与具体故事情境相配合的取舍。
虚构语言也要有连续性
影片对白使用专门设计的虚构语言。团队为它建立词典与语法,一个词一旦确定,后续剧本和镜头就继续沿用。
提示词主体使用英文,人物真正说出的台词则用西里尔字母书写,以减少生成时混入英语发音习惯的问题。这是团队在当前语言和生成流程中的项目经验,不能直接外推到所有模型和所有语言。
声音本身也有角色身份。父亲和女儿分别拥有稳定的声音描述;虚弱、激动、疲惫等当场状态,再叠加在这个基础上。遇到发音不稳,团队先调整说话方式的描述;重要台词仍有问题时,再适度简化拼写,让文字接近生成器能够发出的声音。
顺序不能反过来。
先确定一句话的含义、写法和声音身份,再让它进入镜头生成。临时变体越多,后面的连续性核对就越困难。词典、发音版本和镜头编号关联起来,才能避免每一镜都从头猜一次。
光、声音与剪辑一起维持同一个世界
《ANERNEQ》的视觉基调以深蓝和石墨灰为主,火焰只提供局部暖色。极夜环境中的光来自火、星光和雪面反射,人物不会因为“需要看清”就被均匀照亮。

所以,灯光要求也必须具体:光源位于哪里?离人物多远?身体哪些部分应该被照亮?哪些地方必须留在暗处?
声音同样克制。根据公开简报,影片主要依靠风、呼吸、雪橇摩擦、火焰、对白、鼓声和无词摇篮曲组织听觉,没有用常规配乐持续铺底。
剪辑则更早介入。团队使用带观察感的跳切,缩短生成模型难以稳定完成的连续动作。旅途中的过渡可以压缩,关键事件则保留展开空间。
这意味着,生成、摄影和剪辑不能分开考虑。哪些时刻需要观众连续看完?哪些动作可以通过切镜完成?模型能稳定做到什么?这些决定共同塑造最后的节奏。
把长片拆成一套持续核对的顺序
把整份项目简报压缩下来,可以得到一条清楚的制作路径。
故事先行。 确定人物目标、关键事件,以及每场戏发生了什么变化。
资产锁定。 给角色、道具和环境建立统一名称、基准图与描述,状态变化另行管理。
空间预演。 在 Blender 中确认走位、遮挡、机位和光源,再提取需要写进镜头的参数。
规则入库。 把固定的画面、声音和语言条件写进项目 Skill,并为不同场景建立模板。
逐镜生成。 给当前镜头完整输入,明确人物的表演任务和最容易出现的错误。
对照检查。 检查身份、空间、受力、光线、声音与叙事信息,再决定重新生成、局部修改还是直接切镜。
项目公开页显示了 11,961 项 Generations,但没有公布 Credits spent,也没有说明这些记录中多少成功、多少失败、多少进入最终成片。因此,这个数字不能直接换算成现金预算,也不能用来推断生成成功率。
模板能够减少重复劳动,却不能替代导演判断。
《ANERNEQ》真正值得借鉴的,不是某个模型突然解决了 20 分钟叙事,而是团队把人物的生活、身体、声音和环境,都变成了镜头之间必须持续核对的条件。
生成能力让一张画面成立。
而那些细小、连续、彼此不冲突的决定,才让观众愿意跟着人物走完整部片子。