

📦 4 Parts + Conclusion
👉 滑动
PART 01
能力对账
榜单与偏好
PART 02
价格对账
分母陷阱
PART 03
速度对账
倍率缩水
PART 04
开源验牌
11 月 4 日
PART ///
写在最后
预期与能力
四笔账查完,我的结论只有一句
反转的不是能力,是预期。

发布当天,Kimi K3.1 Pro 的数据足够漂亮:100 万上下文,Artificial Analysis 智力指数 55 分、排第 4,官方 Terminal-Bench 4.0 成绩 65.7%,贴着 Claude Opus 5.5 的 66.4%,API 价格只有上一代的三分之二,完整权重承诺在 11 月 4 日前发布。
只过了一天,评论区的关键词就换了一套:吞金兽、额度刺客、倍率缩水、静默降级。我一开始也顺着二手材料做了一轮判断,后来把官方博客、评测原站、榜单和产品文档逐个打开重查,先撤回了自己的三条结论:一条数字归因错了,一条榜单标签标错了,还有一条流传很广的说法,回到原始清单根本数不出来。
先说清边界:这篇不是我自己跑的 API 实测。成本和速度,我只采用能写清来源和测试条件的外部实测;查不到原始出处的,明确降级,不拿转述凑数。
口碑确实变了,但反转的不是能力,而是预期。能力这张牌基本立住了;便宜、极速、开源这三张牌,都还没有完全落到可核验的事实上。
01
PART
能力没有翻车,但“强”也要说准
ABILITY · 能力对账
先看独立评测。Artificial Analysis 给 K3.1 Pro 的智力指数是 55 分、排第 4,比上一代 K3 高了 11 分;它在自己的评测框架里测出的 Terminal-Bench 4.0 成绩约为 67%,是这套榜单里的最高值。
这里有个细节,我第一轮就写错了:AA 原站给的是取整后的 67%,没有逐字写 67.2%,也没有自称什么“中立 harness”。数字多一个小数点,看着更精确,其实是把别人没说过的话安到别人头上。
LiveBench 原站也能对上:第 14,Overall 76.7,Coding 81.8。Arena 的 WebDev 榜排第 8,1692 分。但这一条也要把话说全:它只有 2451 张票,名次区间是 7 到 13。说正式上榜第 8 没问题,说名次已经坐稳,就早了。

— 能力对账:三家原站数据,2026-10-25 核对
具名实测里也有正面的:Simon Willison 用不同推理档跑了他的鹈鹕骑自行车 SVG 测试,评价是“Pretty solid pelican”,还专门写了后续笔记。这类帖子有名字、有产物,比匿名夸赞值钱。
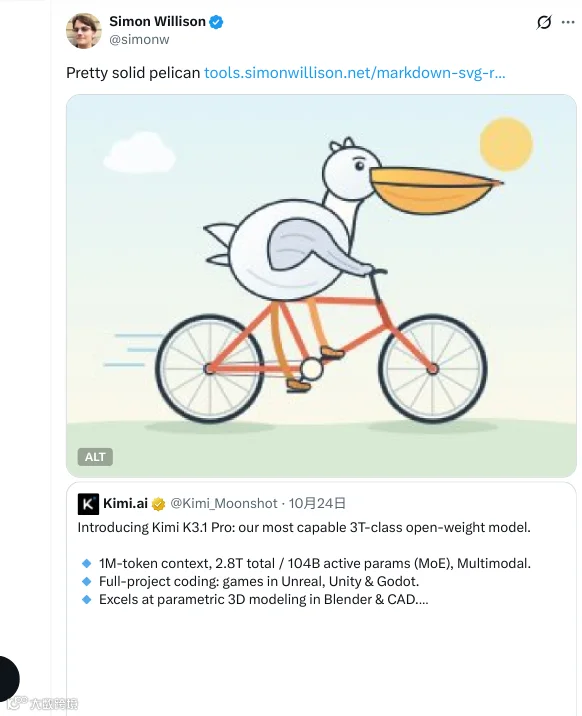
— Simon Willison 原帖截图:鹈鹕测试,评价 Pretty solid
这和官方自报分数还要分开看。月之暗面博客里的 65.7%,用的是 Claude Code harness,竞品分数取的是各自公布的最大值,本来就不是同一场比赛。官方分数可以看,但不能直接当独立结论。
还有一条流传很广的说法,说 K3.1 Pro“停报了至少 9 个 benchmark”,暗示它在藏分。我把两代官方博客的脚注清单逐项拉出来对了一遍:K3 是 19 项,K3.1 是 34 项左右,清单不是变短了,是变长了。真正从新清单里消失的只有 4 项。这个“至少 9 个”,数不出来,我撤回。
另一面同样存在。一些前端生成、3D 还原和机器人任务的实测里,它的表现明显没有编码榜单那么亮眼,有的个案甚至翻车翻得很难看。所以准确的说法不是“全面封神”,也不是“能力造假”,而是:在主流编码和 Agent 基准、以及真人偏好榜上,它确实进了第一梯队;出了这个范围,表现并不均匀。
02
PART
便宜这张牌,被输出量吃掉了一半
PRICE · 价格对账
K3.1 Pro 最容易打动人的,是降价。官方单价比 K3 低了三分之一。问题是,Agent 模型买的从来不是单价,而是完成一个任务的总账单。
AA 的账是这么算的:K3.1 Pro 完成每个任务平均输出约 5.5 万个 token,K3 是约 4.8 万个,多了 14%。单价降了 33%,输出多了 14%,最后单任务成本约 1.98 美元,和 K3 基本持平。
网上流传最广的说法是“它比同类多吐了 72%”。这个数字本身没算错:AA 整套评测里,它一共输出约 1.5 亿个 token,同价位模型的中位数约 8700 万个,确实高出约 72%。
但这两个数字的分母不是一回事。一个是和同价位模型的中位数比,一个是和上一代比。把它们接成一条因果链,就会得出“因为多吐了 72%,所以和 K3 一样贵”——听着顺,账算错了。
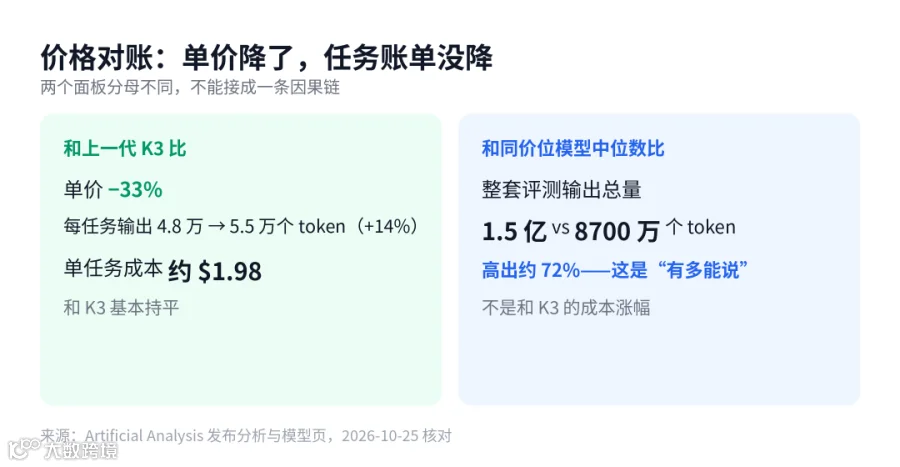
— 价格对账:两个分母,两笔账
具体任务上,它也未必贵。LiveBench 给出的单次成功任务成本是 0.935 美元;还有一个公开的小型编码测试里,用低推理档跑,三次全部通过,单次只要 0.16 到 0.21 美元。
真正的问题出在订阅和 Coding Plan这一侧。多个用户个案指向同一件事:长任务一跑起来,5 小时额度掉得非常快。数字最具体的一个来自 X 用户 @thegitai 的原帖:2 个提示、4 分钟,5 小时额度 100% 烧完,两次任务都跑到一半被 429 切断;他还拆了账,19 美元月费的 5 小时额度,大约只值 1.41 美元的 token。另一个被转得最多的案例,是有人用 Highspeed 做“鹈鹕骑自行车”,烧掉了 5 小时额度的 66%。这些都是单例,不能当平均值;但在 Hacker News 的主讨论串里(1060 分、654 条评论),具名说自己快速撞满额度的,不止一个人。

— @thegitai 原帖截图:4 分钟烧完 5 小时额度,附拆账

— Hacker News 主讨论串原图:1060 分、654 条评论
反例也有人提:轻量使用、混着几个模型用的人,额度完全够;而且快速撞限这件事,Claude、ChatGPT 的订阅用户一样在骂。
这条结论最后收窄成一句:难受的主要是重度编程用户,尤其是把思考档拉满、只用一个模型、还开长任务的那批人。这不等于给套餐洗地:API 降价三分之一,订阅用户却没感觉到额度变耐用,这个落差本身就是口碑反转的燃料。
03
PART
极速这张牌,数字确实对不上
SPEED · 速度对账
Highspeed 是这轮争议里最硬的一条,因为它有明确的官方数字:2 到 3 倍。
官方文档还顺带确认了另一件事:如果 Highspeed 的模型 ID 写错,系统会静默回退到 K2.8 Preview,不带思考,也没有提速。这不是网友猜的,是官方 FAQ 自己写的。功能可以这么设计,但“静默”两个字,天然伤信任。
那实际测出来是多少?一家商业 API 网关做了一个条件很窄的测试:同一个提示词、最低推理档、每边跑 3 次。Highspeed 是每秒 138 到 150 个 token,标准版是 85 到 88 个,算下来约 1.6 到 1.75 倍。它自己就在卖这两个模型,这个利益关系要标明,所以这份数据只能当中等可信度的旁证。
OpenRouter 的平台快照是另一个旁证:标准版约 44 tps,Highspeed 约 67 tps,约 1.52 倍。端点和路由条件不同,不能和上面的测试直接拼,但方向一致。
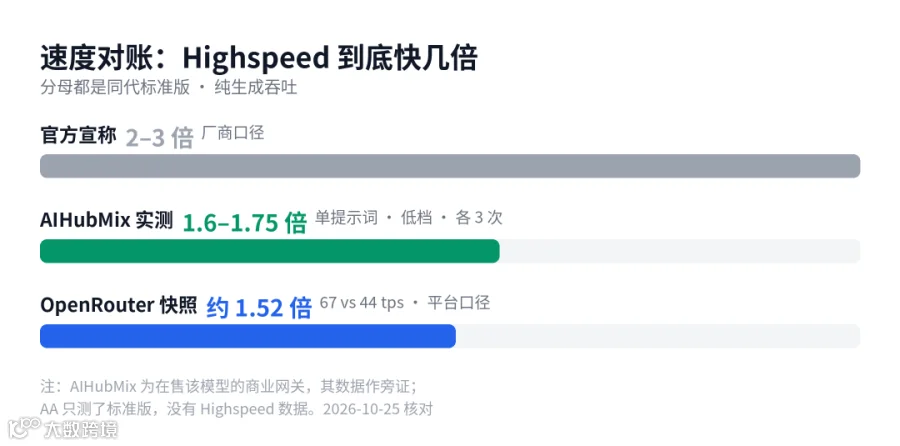
— 速度对账:宣称与实测的差距
我第一轮把“1.5 到 1.8 倍”写成了 AA 实测。这次打开 AA 原站逐页找过:它只测了标准版,根本没有 Highspeed 的数据。结论方向可能没错,归因错了就得撤。
拿错证据支持对的结论,也是在透支可信度。
所以这一条最后写成:官方说 2 到 3 倍,现有独立测试和平台快照落在约 1.5 到 1.75 倍。在更多标准化复测出来之前,2 到 3 倍只能算厂商口径,不能算已证实。
04
PART
开源这张牌,要等 11 月 4 日验牌
OPEN WEIGHTS · 开源验牌
发布当天最容易被忽略的一点是:K3.1 Pro 还不是一个能下载的模型。
截至 10 月 25 日,Moonshot 的 Hugging Face 官方页面里没有 K3.1 的仓库,许可证也没有公布。官方承诺的是完整权重在 11 月 4 日前发布。没到截止日,就不能说它逾期;但同样,在权重文件和许可证原文出现之前,也不能把“宣布将开源”写成“已经开源”。
这两个词差得很远。权重能不能下载、能不能商用、能不能改、能不能再分发,全写在许可证里,不写在发布会的标题里。
我已经把验牌标准提前写死了,到时候不改口径:
权重兑现
官方仓库公开出现、无需申请就能下载、配置文件和 tokenizer 齐全,才算数。
强开放
许可证允许商用、修改和再分发,才算强开放;只发公告、开申请通道、放一个量化演示,都不算。
截至 10 月 25 日,在我查到的官方博客、论坛、产品文档和更新日志里,还没有看到月之暗面针对额度、倍率和参数锁定这几项争议的正面说明。文档里那段静默回退的 FAQ 是预先写在那里的披露,不算事后回应,而且页面没日期,连它是什么时候写上去的都确认不了。
///
LAST
写在最后
CONCLUSION · 结语
所以,K3.1 Pro 的口碑到底反转了吗?我的答案是:用户预期反转了,能力排名没有。
它的问题不是不强,而是发布叙事跑得比证据快:价格只报单价,不报任务总账;速度只报倍数,不报测试条件;开源只报日期,不报许可证。用户拿真金白银和真实额度去验牌的时候,落差就是这么来的。
11 月 4 日是下一个验牌点。到时候我会按这篇文章里写死的标准再查一遍:权重到底下没下,许可证到底放没放开。兑现了,我认;没兑现,也不会替它换一套说法。
查模型和用模型一样,最后拼的都是同一件事
别看它怎么说,看它交付了什么。
主要来源
月之暗面官方博客:https://www.kimi.com/en/blog/kimi-k3-1-pro
Kimi Code 官方模型文档:https://www.kimi.com/code/docs/en/kimi-code/models.html
Artificial Analysis 模型页:https://artificialanalysis.ai/models/kimi-k3-1-pro
LiveBench 榜单:https://livebench.ai
Arena WebDev 榜单:https://arena.ai/leaderboard/code/webdev
OpenRouter 模型页:https://openrouter.ai/moonshotai/kimi-k3-1-pro
Simon Willison 原帖:https://x.com/simonw/status/2113691493823369246
@thegitai 额度投诉原帖:https://x.com/thegitai/status/2113953528029073740
Hacker News 主讨论串:https://news.ycombinator.com/item?id=50212065
我是雷神,热衷于分享 AI 观察与干货。
既然看到这里了,如果觉得有用,随手点个赞、在看、转发三连吧。
THANKS FOR READING