


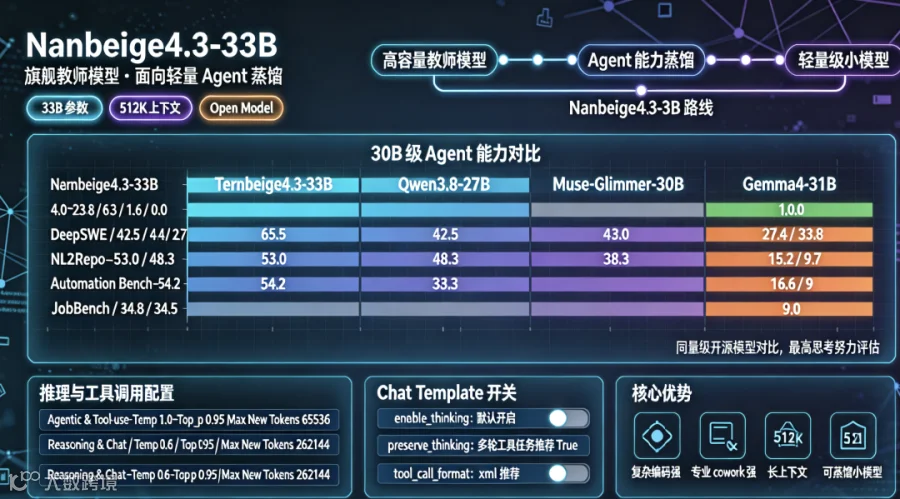
编者摘要:Nanbeige(南北极)是看准科技(Kanzhun,BOSS 直聘团队)推出的大模型系列,Nanbeige4.3-33B 为本系列旗舰教师模型,核心目标是打造高性能 Agent 底座,后续蒸馏出 Nanbeige4.3-3B 等轻量化小模型,推动轻量智能体落地。该模型参数量约 33B,上下文窗口支持最高 512K token,在同 30B 级别开源模型中 Agent 能力突出,对标 Qwen3.8-27B、Muse-Glimmer-30B、Gemma4-31B。
模型优势集中在智能体编码与专业协同办公两大方向,覆盖代码工程、自动化任务、岗位实操、复杂规划、工具调用等场景,JobBench 评测覆盖 35 类职业任务,多数岗位基线领先;在 YC-bench 创业模拟评测中得分大幅领先竞品。纯数学与科学推理能力稳健,和竞品互有胜负。
模型内置专为推理、工具调用设计的对话模板,提供enable_thinking、preserve_thinking两个关键开关,工具调用优先推荐 XML 格式,兼容 JSON。官方给出两套推理参数,区分 Agent 工具任务与普通推理对话场景。支持 Transformers、SGLang、vLLM 主流部署框架。
评测采用统一框架与推理配置,使用 Terminal-Bench、SWE-Bench Pro、Claw-Eval、DeepPlanning 等大量 Agent 专项基准,区别于传统静态推理榜单。团队开放合作,欢迎共建行业垂直智能体,可通过仓库 Issue 或邮箱沟通。该模型既可直接落地企业 Agent 业务,也承担教师模型职责,是一套 “大模型蒸馏小 Agent” 技术路线的核心底座。(全文 496 字)
10 个关键问题Q&A
Q1:Nanbeige 属于哪家团队? A1:看准科技(Kanzhun,BOSS 直聘)团队。
Q2:Nanbeige4.3-33B 核心定位是什么? A2:Nanbeige4.3 系列旗舰教师模型,用于后续蒸馏轻量化 Agent 小模型。 Q3:上下文最大支持多少 token? A3:最高 524288 tokens,即 512K 上下文。
Q4:它对比的竞品有哪些? A4:Qwen3.8-27B、Muse-Glimmer-30B、Gemma4-31B。
Q5:模型能力强项是什么? A5:Agent 编码、工具调用、协同办公、复杂任务规划、多行业岗位任务。 Q6:preserve_thinking 参数作用是什么? A6:控制多轮对话是否保留历史思考内容,工具 / 代码 Agent 场景建议开启。
Q7:工具调用优先哪种格式? A7:XML 格式效果最优,同时兼容 JSON。
Q8:支持哪些主流部署引擎? A8:Transformers、SGLang、vLLM。
Q9:YC-bench 这个评测代表什么? A9:创业模拟智能体评测,以虚拟创业收益作为打分指标。
Q10:这个模型只能用来做蒸馏吗? A10:不是,本身性能优异,可直接部署用于企业 Agent 业务。
Nanbeige(南北极,Kanzhun/BOSS 直聘团队),Nanbeige4.3-33B 是 Nanbeige4.3 系列的旗舰教师模型,定位:面向轻量智能体(Lightweight Agent)蒸馏的大教师模型,主打智能体编码、多角色协同办公 Agent 能力,上下文 512K。
1. 简介
在 Nanbeige4.3 版本中,我们向着拓展轻量化智能体的能力边界迈出关键一步。整体路线是:先训练一个高能力的教师智能体,再基于它做蒸馏,把高阶 Agent 能力迁移到更小模型上。
为此,我们推出 Nanbeige4.3-33B,作为 Nanbeige4.3 系列旗舰教师模型。在同量级(~30B)开源模型里,它取得顶尖的智能体能力表现,擅长复杂代码任务与专业协同办公任务。它既可以直接落地部署、具备高性价比;同时也作为底座,支撑后续小模型蒸馏管线(例如 Nanbeige4.3-3B)。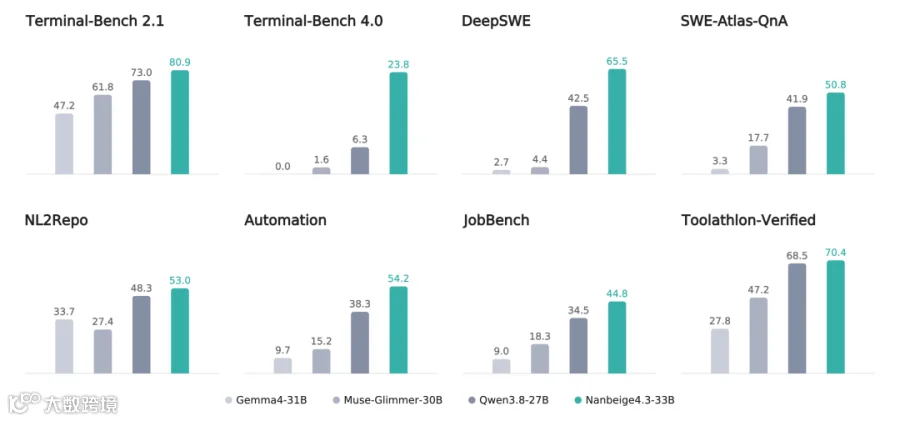
2. 模型性能
我们将 Nanbeige4.3-33B 和同期 30B 左右前沿模型对比:Qwen3.8-27B、Muse-Glimmer-30B、Gemma4-31B。所有模型均开启最高思考强度评估;同一评测集,统一推理超参、统一评测框架。
|
|
|
|
|
|
|
|---|---|---|---|---|---|
| 智能体编码 Agentic Coding |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 智能体协同办公 Agentic Cowork |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
| 推理 Reasoning |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
评测注释:
-
Nanbeige4.3-33B 评测时 chat template 开启 preserve_thinking=true -
Terminal-Bench 2.1 使用 Terminus 2;Terminal-Bench4、DeepSWE、SWE-Atlas-QnA 使用 mini-swe-agent v2.4.6 -
SWE-Atlas-QnA 共 1304 条任务评分标准,GPT-6 Sol 作为裁判,中等思考强度 -
NL2Repo 使用 Claude Code 评测框架 -
Automation Bench v1.0.6,600 个公开任务 -
JobBench:Claude Code 框架 + 搜索工具 -
GDPval 使用新版评分标准 -
Claw-Eval:仅通用子集,157 条单轮交互任务 -
Toolathlon-Verified:单轮生成无 max_tokens 上限 -
YC-bench:每轮调用只保留最近 10 轮对话上下文 -
DeepPlanning、EnterpriseOps-Gym、Tau3-Bench 使用官方仓库评测
小结:Nanbeige4.3-33B 在绝大多数智能体评测上领先,尤其 Agent 编码、Agent 办公协同优势明显;覆盖大量行业岗位场景(JobBench 35 个职业评测集,多数岗位基线领先);纯数学科学推理上和竞品互有胜负。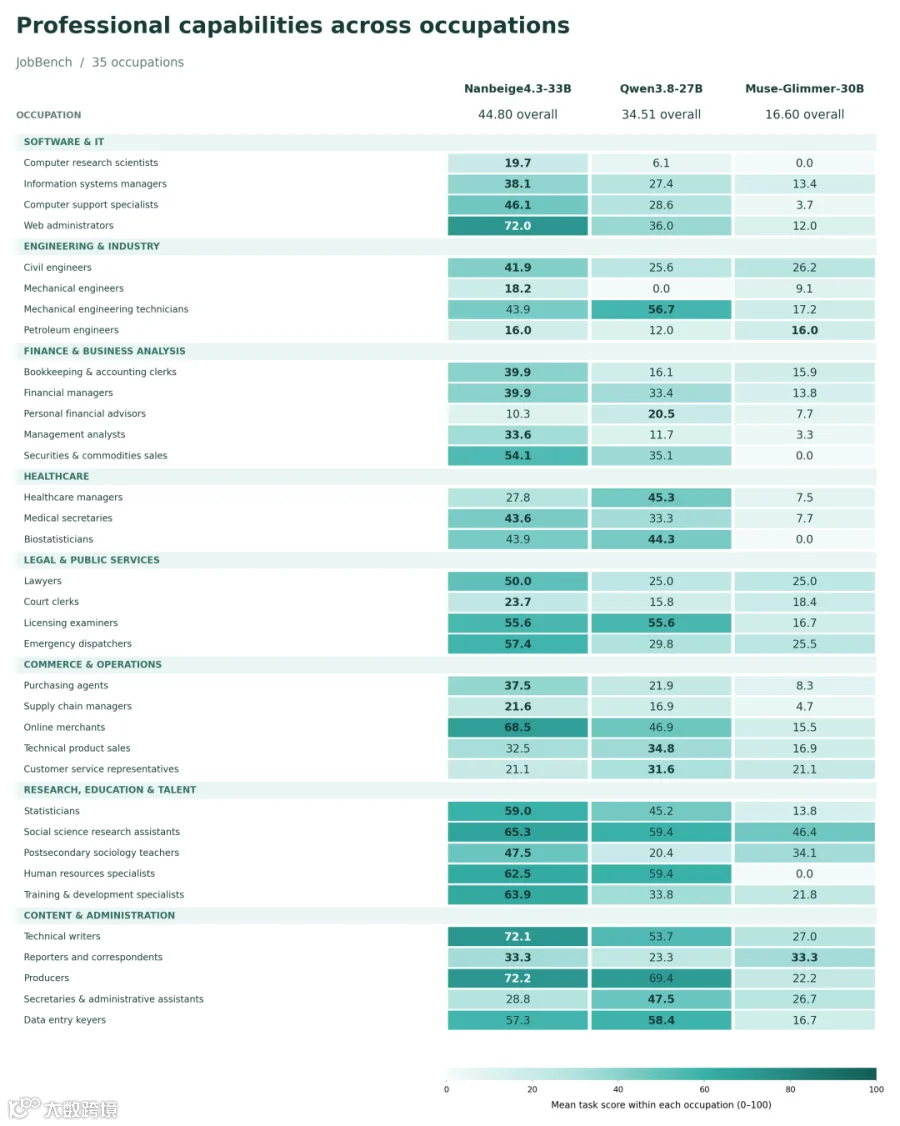
3. 快速上手 Quickstart
Tokenizer 内置可配置对话模板,专门适配推理、工具调用场景:
enable_thinking控制是否输出思考过程,默认开启;普通问答可设为 False(无思考模式) preserve_thinking多轮对话里是否保留上一轮模型输出的思考内容 -
✅ 普通闲聊问答:推荐 False -
✅ 多轮工具调用、办公任务、代码智能体流程:推荐 True -
传入 tools参数开启工具调用模板;推荐tool_call_format="xml"效果最优,同时兼容 json 格式
上下文窗口:最高 524,288 token(512K)
推荐推理参数:
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
支持 Transformers / SGLang /vLLM 三种部署方式,原文代码我一并保留:
Transformers
from transformers import AutoModelForCausalLM, AutoTokenizer

model_id = 'Nanbeige/Nanbeige4.3-33B'
tokenizer = AutoTokenizer.from_pretrained(
  model_id,
  use_fast=False,
  trust_remote_code=True
)
model = AutoModelForCausalLM.from_pretrained(
  model_id,
  torch_dtype='auto',
  device_map='auto',
  trust_remote_code=True
)

messages = [{'role': 'user', 'content': 'Which number is bigger, 9.11 or 9.8?'}]
inputs = tokenizer.apply_chat_template(
  messages,
  add_generation_prompt=True,
  return_tensors='pt'
).to(model.device)
output_ids = model.generate(inputs, max_new_tokens=1024)
response = tokenizer.decode(output_ids[0][inputs.shape[-1]:], skip_special_tokens=True)
print(response)
SGLang 启动
MODEL_PATH=/path/to/your/Nanbeige4.3-33B
python -m sglang.launch_server \
  --model-path ${MODEL_PATH} \
  --host 0.0.0.0 \
  --port 8000 \
  --tp-size 4 \
  --mem-fraction-static 0.8 \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder
vLLM 启动
MODEL_PATH=/path/to/your/Nanbeige4.3-33B
vllm serve ${MODEL_PATH} \
  --host 0.0.0.0 \
  --port 8000 \
  --tensor-parallel-size 4 \
  --gpu-memory-utilization 0.8 \
  --enable-auto-tool-choice \
  --reasoning-parser qwen3 \
  --tool-call-parser qwen3_coder
4. 联系
如有问题,可以在仓库提 issue,或发邮件:nanbeige@kanzhun.com欢迎合作共建垂直行业、领域专属智能体,包括数据与联合训练项目。
5. 引用格式
@misc{nanbeige43chat2026,
  title        = {Nanbeige4.3-33B},
  author       = {Nanbeige Team},
  year         = {2026},
  publisher    = {Hugging Face},
  howpublished = {\url{https://huggingface.co/Nanbeige/Nanbeige4.3-33B}}
}