



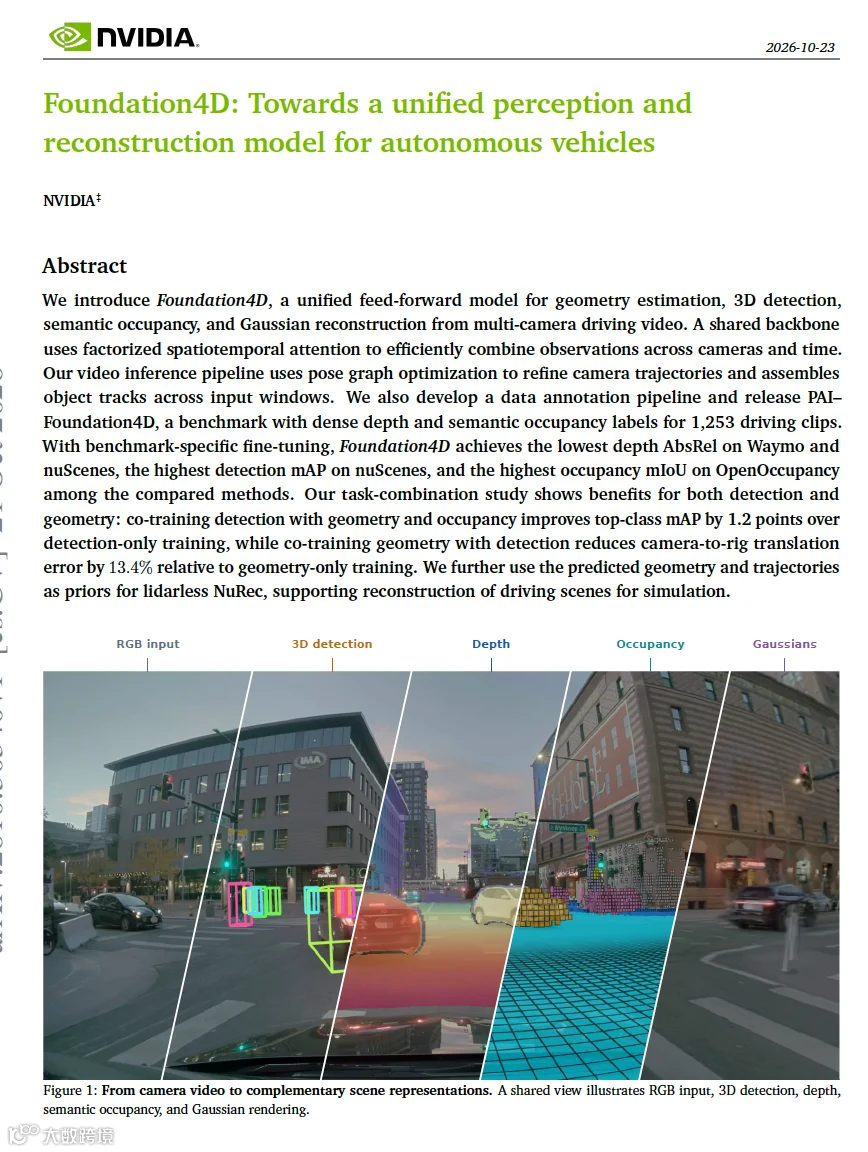
编者摘要:NVIDIA 提出Foundation4D,面向自动驾驶的前馈式统一感知重建模型,利用因式化时空注意力,解决 VGGT 全局注意力计算开销大的问题,共享主干网络,可从多相机视频同时输出深度、3D 检测、语义占用、3D 高斯渲染结果,无需预先提供相机外参与自车位姿。
模型将相机位姿解耦为固定相机‑车体标定与时变自车轨迹,适配异步相机;设计多任务解码器,采用三阶段训练策略完成几何、检测、占用、高斯重建联合学习。长视频推理采用滑动窗口,搭配位姿图优化 PGO降低序列漂移,配合 RTS 平滑离线生成物体完整轨迹。
论文构建PAI‑Foundation4D 基准数据集,含 1253 段带稠密标注的驾驶片段。在 Waymo、nuScenes、OpenOccupancy 上取得 SOTA 表现;多任务联合训练可互相增益,检测 mAP 提升 1.2 点,相机平移误差降低 13.4%。模型输出可作为先验赋能无雷达 NuRec 仿真重建,处理速度提升 4.3 倍。该工作也指出远距离预测、多任务权衡、动态渲染仍存在待解决局限。
附录 Foundation4D 论文详细总结
这是 NVIDIA 发布的自动驾驶统一感知与重建模型论文(arXiv:2610.30340,2026),提出Foundation4D,一个前馈式多相机视频统一模型,可同时完成几何估计、3D 目标检测、语义占用预测、3D 高斯重建;同时配套开源PAI‑Foundation4D 数据集基准,把感知和场景重建融合,服务自动驾驶仿真场景。
1. 研究背景与动机
自动驾驶两大核心任务:①理解驾驶环境(感知);②重建记录的场景用于仿真(重建)。传统方案多个独立网络分别处理,重复计算视觉特征。
-
现有多任务感知模型(UniAD、GeoUP 等)可以输出深度、3D 框、语义占用,但缺少可渲染的场景外观,无法直接用于仿真。 -
前馈重建模型(VGGT)可以从图像恢复相机与几何,但全局注意力计算复杂度随 token 数量二次增长,很难处理长时序多相机驾驶视频。 -
现有数据集缺少对齐的稠密深度 + 语义占用标注,很难同时评测几何、检测、占用多项任务。
目标:构建单前馈网络,输入多相机视频,一次性输出几何、检测、语义占用、高斯可渲染场景;设计配套标注流水线与基准;输出结果可作为先验给仿真重建管线使用。
2. 核心贡献
- Foundation4D 统一前馈模型
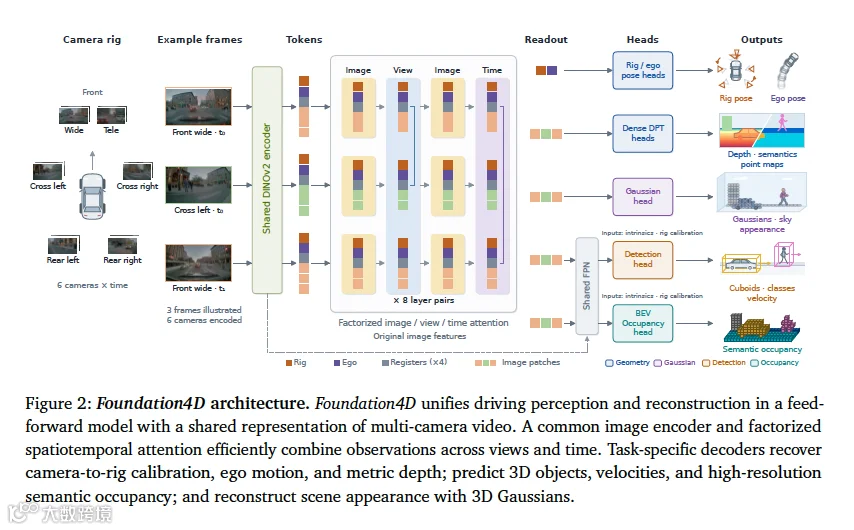
共享多相机视频特征,使用任务专用解码器,同时实现几何估计、3D 检测、语义占用、3D 高斯重建;可直接预测外参(相机‑车体标定)与自车运动,不需要预先给定相机位姿。 - 视频级推理系统
滑动窗口处理长视频,支持顺序拼接与位姿图优化 PGO,对齐窗口间几何,组装长序列相机轨迹与目标轨迹,抑制漂移。 - 标注流水线
考虑传感器时序、自车 / 物体运动、可见性,从原始驾驶数据生成稠密深度图、体素语义占用标签。 - PAI‑Foundation4D 基准数据集
包含 1253 段驾驶片段,带有稠密深度、语义占用标注,支持几何、检测、占用联合评测。 -
验证多任务联合训练的增益与权衡;模型输出可作为先验,驱动无激光雷达的 NuRec 仿真重建管线。
3. Foundation4D 模型架构
整体分为:共享图像编码器、因式化时空注意力聚合器、多任务解码器(几何、3D 检测、语义占用、高斯重建)。
3.1 共享主干:DINOv2 + 因式化时空注意力
-
使用 DINOv2 ViT‑L/14 提取每帧图像 patch 特征。 - 因式化时空注意力
替代 VGGT 开销巨大的全局注意力;每一层依次执行:图像内自注意力→同时间不同相机跨视图注意力→同一相机不同时间时序注意力。避免一次性对全部 token 做全局注意力,大幅降低多相机长视频计算开销。 -
额外引入 rig token(相机车体标定)、ego token(自车运动)、register token 辅助注意力计算。
3.2 几何解码器
输出:相机‑车体外参 rig transform、自车轨迹 ego pose、度量深度图、辅助点云、像素语义。
- 位姿分解
把相机位姿拆分为两部分: -
固定:\(T_{c}^{rig}\):相机相对于车体的标定; -
时变:\(T_{t}^{ego}\):车体世界位姿; 每个图像根据自己真实曝光时间插值 ego 轨迹,合成每个相机的完整位姿\(T_{t,c}=T^{ego}(\tau_{t,c})T_{c}^{rig}\),适配异步传感器、卷帘快门。 -
DPT 解码器预测深度、辅助点图;通过相机模型反投影得到 3D 点云。 -
几何损失:包含深度损失、点云损失、rig 标定损失、ego 位姿损失、相对位姿时序约束损失、像素语义损失,使用鲁棒损失函数。
3.3 3D 目标检测分支
-
基于 DETR3D 查询式检测架构;和占用分支共享特征金字塔 FPN。 -
900 个目标 query,交替 query 自注意力、多尺度可变形交叉注意力,预测物体 3D 包围盒、类别、尺寸、航向角、平面速度。 -
训练使用匈牙利匹配、Query‑DN 查询去噪,增加辅助 2D YOLOX 损失。 -
推理输出检测框后,交给离线多目标跟踪模块生成完整物体轨迹。
3.4 语义占用分支
-
目标:0.2m 分辨率体素语义占用,ROI:\([-20,100] \times[-30,30] \times[-3,5]\text{m}\)。 -
采用 BEV 中间表示节省显存:将多尺度图像特征聚合到 BEV 栅格,每个 BEV 柱设置垂直方向 4 个参考点,用可变形注意力聚合图像特征;上采样后再扩展出高度维度输出体素二值占用 + 语义类别。 -
损失包含 BCE、Lovász hinge、交叉熵、Dice 损失,附加 BEV 分割辅助损失。
3.5 3D 高斯重建分支
参考 Instant NuRec,场景由静态高斯、物体关联动态高斯、天空立方图组成。
-
DPT 解码器从共享特征预测每个像素对应的高斯参数:中心、颜色、尺度、旋转四元数、不透明度、法向。 -
根据预测得到的相机位姿把高斯放到世界坐标系;利用几何分支语义掩码抑制天空、自车区域高斯的不透明度。 -
动态物体高斯:根据检测跟踪输出的物体轨迹做刚体变换;静态高斯保持不动。 -
可微分高斯 Splat 渲染;损失包含 RGB、LPIPS、逆距离、不透明度、法向、天空、仿射外观变换正则。
训练阶段使用 GT 位姿与物体轨迹做监督;推理阶段完全使用模型自己预测的位姿与跟踪结果,不需要 ground‑truth。
4. 统一模型三阶段训练策略
训练数据集:3 套内部数据集 NRE、PlanNet、MLMCF,合计约 20 万片段,总时长约 695 小时,6 相机 30FPS,搭配 128 线激光雷达。
- 阶段 1
短时序窗口,联合训练图像编码器、时空聚合器、几何 + 检测 + 占用头。 - 阶段 2
扩大窗口增加时序上下文,冻结图像编码器,继续训练聚合器与感知头。 - 阶段 3
加入高斯重建任务;先预热高斯头,之后全部任务头联合微调,编码器保持冻结。
总损失为各任务损失加权求和\(\mathcal{L}=\lambda _{geo}\mathcal {L}_{geo}+\lambda _{det}\mathcal {L}_{det}+\lambda _{occ}\mathcal {L}_{occ}+\lambda _{gs}\mathcal {L}_{gs}\)。 硬件:H100 GPU,BF16 混合精度,FlashAttention‑3 加速注意力。
5. 长视频多相机推理系统
模型只能处理有限时间窗口;长视频采用滑动重叠窗口,两种窗口融合策略:
- 顺序窗口拼接 Stitching
使用 Sim (3) 相似变换把新窗口对齐到前面已经对齐的全局坐标系;缺点:误差不断累积,不能修正历史窗口位姿。 - 全局位姿图优化 PGO+LM(线性运动先验)
-
将每个参考相机时刻作为图节点;不同窗口给出相对位姿作为图因子;一次性联合优化全部节点旋转和平移; -
加入线性运动先验约束速度突变;优化后再插值得到每个相机真实曝光时刻的位姿。显著降低轨迹漂移。
离线多目标跟踪流程:
-
将各窗口检测框,利用 PGO 优化后的 ego 位姿转换到统一世界坐标系; -
恒速卡尔曼滤波 + 匈牙利匹配完成初步关联; -
插值填补轨迹间隙;二次关联修复断裂轨迹; - RTS Rauch‑Tung‑Striebel 反向平滑
,利用后续观测修正过去时刻物体状态,输出平滑完整物体轨迹。
6. PAI‑Foundation4D 标注流水线与数据集
基于 PAI 原始多传感器数据,生成稠密深度图与语义占用体素标签:
-
时序激光点云聚合:静态点累积长时间;动态物体点在局部时间窗口内做运动补偿,分离静态 / 动态点云。 -
深度图生成:将聚合点云渲染到每个相机视图,做可见性检查,处理卷帘快门,输出相机视图度量深度。 -
语义占用生成:静态点融合多帧图像语义投票;动态点继承对应跟踪物体类别;体素化生成 0.1m 原始分辨率占用栅格(评测时下采样到 0.2m),每个体素附带速度标签。
PAI‑Foundation4D 基准:1253 个测试片段,6 相机,同时支持几何深度、3D 检测、语义占用三项任务评测。
7. 主要实验结果
7.1 几何重建(深度、相机位姿标定)
-
Waymo、nuScenes 公开数据集:微调后 Foundation4D 取得最低深度 AbsRel 误差;优于 DVGT‑1、DVGT‑2、GeoUP 等对比方法。可以仅靠图像同时估计ego 自车轨迹 + 相机‑车体 rig 外参。PGO+LM 相比顺序拼接大幅降低 ATE 轨迹误差。 -
PAI‑Foundation4D:对比 VGGT 基线,PGO+LM 把轨迹 ATE 从 111.12cm 降到 52.75cm;远距离深度误差下降明显。 -
消融:度量尺度训练、Rig‑Ego 位姿解耦、相对位姿损失、辅助语义监督对几何性能都有重要贡献;PGO + 线性运动先验效果最优。
7.2 3D 检测与跟踪
-
nuScenes 验证集:仅相机输入,mAP=60.9,NDS=66.5,超过 GeoUP‑Joint 等 SOTA。 -
PAI 数据集:5 个主要类别 mAP=38.00,HOTA=34.76;距离越远性能显著下降。 -
消融:更大时序窗口,不需要重训练即可持续提升检测 mAP;RTS 反向平滑给跟踪 HOTA 带来 + 2.2 提升;使用模型预测 ego 位姿相比 GT,HOTA 仅下降 3.1 点,鲁棒性较好。
7.3 语义占用
-
OpenOccupancy 基准:mIoU=18.1,IoU=27.4,超过 SPSC‑temporal 等对比方法。 -
PAI 基准:全 ROI IoU=31.5,mIoU=14.1;近距离效果好,50‑100m 远距离、小物体、细结构指标明显下滑。 -
消融:BEV 可变形注意力优于 LSS;VGGT 主干、BEV 分割辅助损失、扩充训练数据均提升占用预测。
7.4 高斯重建
对比 Instant NuRec(需要 GT ego 位姿输入):
-
Foundation4D 完全使用模型预测 ego 位姿 + 预测物体轨迹,整体 PSNR=23.94dB,高于 Instant NuRec 的 22.66dB;静态场景提升明显;动态外推依然是短板。 -
定性:道路纹理、远景几何、天空渲染质量更好。
7.5 多任务组合消融实验
研究几何 (GEO)、检测 (DET)、占用 (OCC) 不同联合训练组合:
-
检测:GEO+OCC+DET 联合训练,相比仅检测训练 top‑class mAP 提升+1.2 点,几何与占用提供 3D 空间监督有益于检测。 -
占用:和几何一起训练收益最大;仅加检测不会带来明显收益。 -
几何:联合检测训练,相机‑车体平移误差相对纯几何训练下降 13.4%;但纯几何单任务得到最优深度 AbsRel。
说明多任务存在增益,也存在任务之间的性能权衡,损失权重、数据采样会影响最终效果。
7.6 下游应用:无激光雷达 NuRec 仿真重建
把 Foundation4D 输出的相机轨迹、深度、物体跟踪作为先验输入 NuRec,替代原来依赖激光雷达的初始化:
-
端到端处理速度提升4.3 倍;相机位姿估计速度提升 8.8 倍;深度融合提升 8 倍。 -
得到更高质量动态驾驶场景高斯优化结果,减少重影,用于仿真新视角渲染。
7.7 运行时开销
H100‑80GB;随窗口时间戳数量增加,显存与时间线性增长;T=48 时间戳时,前向推理约 19.8 秒,峰值显存 58.41GiB;高斯头是计算开销最大模块之一。
8. 局限与未来方向
-
远距离、物体边界深度误差大;薄结构、小物体检测 / 占用效果差。 -
长时序跟踪在物体遮挡、漏检时轨迹容易断裂;动态物体外推渲染效果仍有待提升。 -
多任务联合训练存在任务冲突;任务权重调参成本高;本次感知预训练后才加入高斯重建,没有从头联合全部任务训练。 -
异步相机曝光、卷帘快门带来的标定‑运动耦合没有被完全解决。
9. 结论
Foundation4D 实现单前馈网络统一自动驾驶感知 + 高斯重建,共享时空特征同时输出深度、3D 检测、语义占用、可渲染高斯场景;配套 PAI‑Foundation4D 基准。多任务联合训练可以互相增益;视频级 PGO 优化缓解长序列漂移。模型输出可以作为先验赋能无激光雷达的驾驶场景仿真重建。