


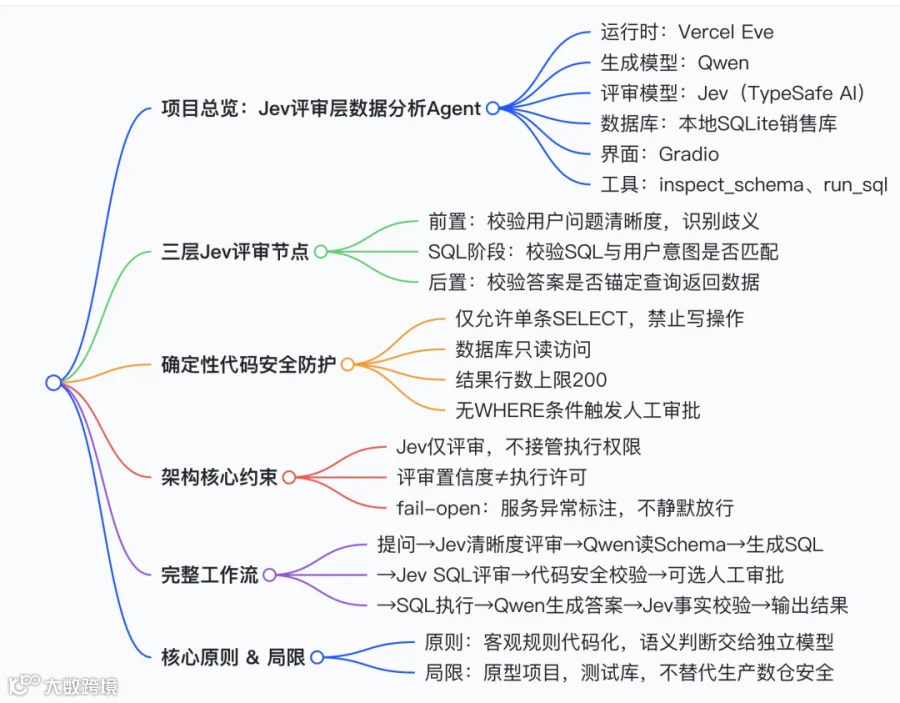
编者摘要:本项目基于 Vercel Eve 运行时,搭建带 Jev 独立评审层的数据分析智能体,核心思路是将内容生成、语义评审、安全强制约束三层职责解耦,解决传统单模型 Agent 自生成自校验易产生幻觉的痛点。主模型选用 Qwen,负责读取数据库 Schema、编写 SQL 并基于返回数据生成业务解释;Jev 作为独立评审模型,在三处关键节点做语义校验:前置评估用户提问是否清晰无歧义、SQL 生成后校验语句是否匹配用户真实意图、查询完成后核验最终回答是否锚定于原始返回数据。
系统安全依靠代码实现确定性硬规则,不依赖模型判断:数据库开启只读模式,仅允许单条 SELECT 查询,限制返回结果最多 200 行,无 WHERE 条件的全表扫描需人工审批。Jev 仅输出评审意见,无权绕过安全限制;评审服务故障采用 fail-open 机制,可返回结果但标注评审未执行,不会默认自动通过。
完整链路:自然语言提问→Jev 问题清晰度评审→Qwen 读取表结构→生成 SQL→Jev 校验 SQL 意图→代码安全检查→按需人工审批→SQLite 执行查询→Qwen 生成答案→Jev 事实锚定校验→展示结果或标记未验证。项目采用本地预置销售 SQLite 库做原型验证,并非生产数仓,用于验证分层控制逻辑。核心原则:客观可程序化校验交给代码,歧义、意图对齐、事实核验这类语义判断交给独立评审模型。
10 个关键问题 Q&A
-
Q:Jev 在智能体里承担什么角色? A:独立语义评审模型,不生成内容,负责校验问题歧义、SQL 意图匹配、答案事实锚定。 -
Q:为什么不使用同一个大模型同时生成 SQL 和自查? A:单模型容易自我合理化、产生幻觉;生成与评审分离,可以降低自校验偏见。 -
Q:确定性代码校验和 Jev 评审有什么本质区别? A:代码校验权限、行数、语法等客观规则;Jev 处理意图、歧义、事实对齐这类语义判断。 -
Q:Jev 评审结论能否绕过数据库安全限制? A:不能,Jev 只输出评审意见,无权修改只读、行数、人工审批等底层安全规则。 -
Q:什么是 fail-open(故障开放)机制? A:Jev 服务异常时系统不会阻断输出,但会标记本次评审未执行,不会默认审核通过。 -
Q:Jev 三层评审各自拦截哪些问题? A:前置识别模糊提问;SQL 阶段拦截意图不符查询;后置拦截脱离原始数据的编造结论。 -
Q:智能体能否直接访问数据库? A:不能,模型只能通过 inspect_schema、run_sql 两个工具间接获取表结构和查询结果。 -
Q:项目使用的数据库是什么,是否适用于生产环境? A:本地预置 SQLite 销售测试库,仅用于原型验证,不能直接作为生产数仓方案。 -
Q:项目定义的营收计算口径是什么? A:已完成订单营收 = 数量 × 单价,订单状态 status='completed',并在回答中显式说明口径。 -
Q:这套架构最核心的设计思想是什么? A:职责拆分,客观规则交给代码强制执行,语义判断交给独立的外部评审模型。
Git 地址
https://github.com/Sumanth077/Hands-On-AI-Engineering/tree/main/ai_agents/nl_data_analyst_agent

附录 基于 Jev 评审层搭建数据分析智能体
Jev 解决了大多数智能体都缺失的一环:独立模型负责判断校验。
传统方案里,往往由同一个大模型完成全部工作:生成答案、自查成果、核验结果,还要决定是否继续迭代。而这套架构把职责拆到不同层级。
我想在真实智能体中验证这套思路,于是基于 Vercel Eve 搭建了数据分析智能体:通义千问(Qwen)承担主体任务,Jev 嵌入循环作为独立评审层。
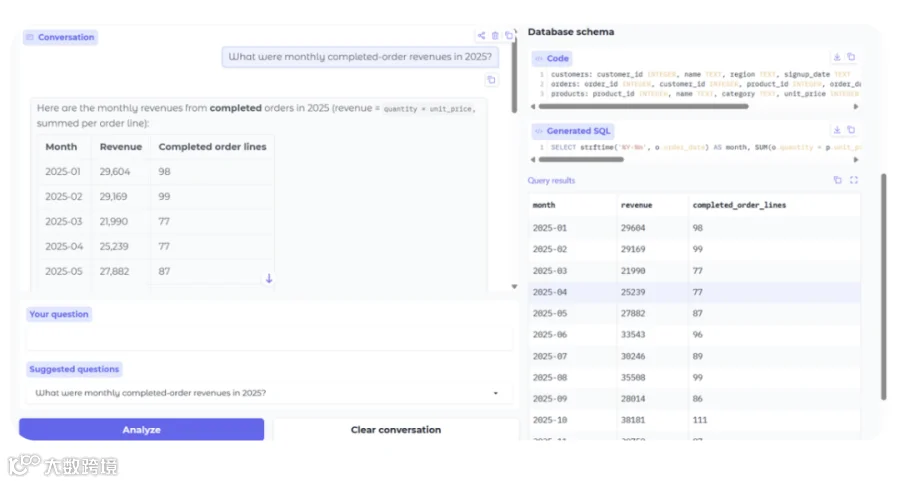
Qwen 读取数据库表结构、编写 SQL、并对返回数据做出解释;Jev 负责三件事:判断原始问题是否清晰可答、生成的 SQL 是否匹配用户真实意图、最终的解释结论是否有返回数据作为依据。
所有不需要模型主观判断的环节,全部采用确定性机制:只读权限、返回行数上限、人工审批。
Qwen 负责生成,Jev 负责评审,代码负责强制约束,Vercel Eve 驱动整个循环。 下面是这套系统的搭建思路。
演示短片:0:02 / 0:28
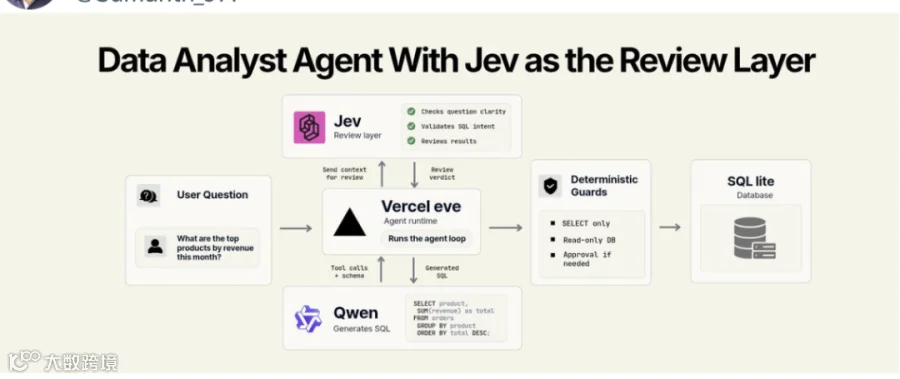
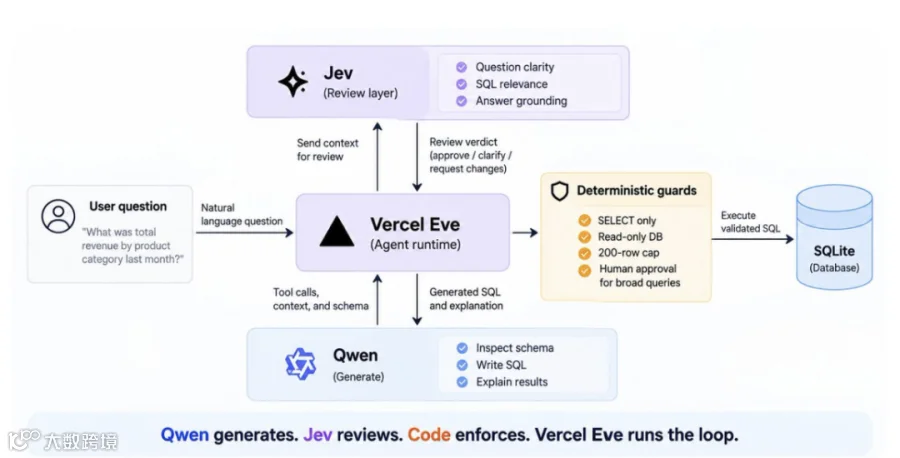


组件构成与设计目的
我们选用 Vercel Eve 作为智能体运行时。 Eve 管理智能体循环、工具调用、人工审批流程;同时智能体仅开放我们希望模型拥有的能力。
本项目的配置刻意保持轻量化:
-
模型:Qwen(alibaba/qwen3.8-omni-flash),通过 Vercel AI 网关调用 -
数据:SQLite 预置销售数据库,包含 2025 年客户、商品、订单数据 -
交互界面:Gradio -
工具: inspect_schema(查看表结构)、run_sql(执行 SQL) -
评审层:TypeSafe AI 的 Jev
SQLite 为本地数据库,该演示不依赖外部数据库 API。模型仅能使用上面两个数据库工具:
inspect_schema查看数据表与字段 run_sql在前置校验通过后执行查询
每个组件单独看并不复杂,核心在于明确每层负责哪些决策。
用户问题的完整流转
假设用户提问:
“按产品品类统计总营收是多少?”
基础智能体执行链路:
用户问题 → inspect_schema → Qwen读取表和字段结构 → Qwen生成一条只读SELECT语句 → run_sql执行 → 返回数据行 → Qwen解读结果
模型无法直接访问数据库,只能通过工具查看表结构,提交 SQL,再通过另一个工具接收查询返回的数据。
在这个预置演示库中,已完成订单营收定义为:
quantity * unit_price(数量 × 单价) 筛选条件:status = 'completed'(订单状态 = 已完成)
智能体会在回答中明确给出该定义,而不是自行静默定义 “营收”。这点非常关键。 一条 SQL 哪怕语法完全合法,也有可能回答的并不是用户真正想问的问题。
安全防护:确定性校验,而非模型判断
这是我们做的第一层职责拆分: Qwen 可以编写 SQL,但无权决定这条 SQL 是否可以安全执行,这项判断交给代码。
SQL 执行前,run_sql会运行确定性校验规则:
-
仅允许单条 SELECT 查询 -
SQLite 以只读模式打开,仅允许查询 -
任何写入语句、多语句批量执行都会被拦截 -
返回行数超过 200 行时直接拒绝,要求智能体增加聚合逻辑或 LIMIT 限制 -
查询不带 WHERE 条件时,会暂停执行,等待人工审批,防止全表扫描
这些校验完全不需要 Jev,也不需要 Qwen 参与。 调用模型来做这类校验,反而会降低可靠性。
凡是能用规则确定性校验的,就用代码校验;只有需要语义理解判断的场景,才交给模型。
写 SQL 不难,难的是信任这个答案。 确定性防护只能解决一个问题:这条查询能不能安全运行。 但回答不了:这条查询是不是真的回答了用户的问题?
一条完全安全的查询,依然可能指标选错、时间范围过滤错误、分组字段不对。 就算 SQL 本身正确,最后的文字解读,也可能编造返回数据不支持的结论。 只读数据库连接无法防范这类逻辑错误。 这就是引入 Jev 的原因。
Jev 在三处节点对智能体做评审
1. 用户问题清晰度校验(进入主循环之前)
Jev 先判断:基于现有数据表,这个问题是否可回答。
测试样例:
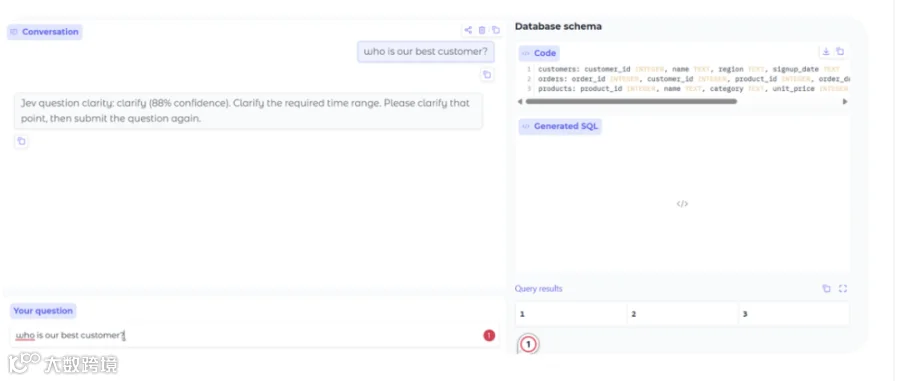
“谁是我们最好的客户?”
这句话看似合理,但 “最好” 没有明确定义: 是按营收?订单数量?客单价?还是最近下单时间?
Jev 识别该问题存在歧义,给出clarify(需澄清)结论,置信度 93%。 智能体不会自行脑补指标、自信地给出错误答案,而是反过来请用户定义 “最好” 的评判标准。
这个小小的决策,直接改变了整个智能体的行为模式。
2. SQL 是否匹配用户意图(Qwen 写完 SQL 之后、执行之前)
Jev 接收三类输入:用户原始问题、数据库表结构、待执行 SQL。 然后判断该查询是否符合用户真实意图。 如果高置信判定存在不匹配,会返回不匹配原因,并给智能体一次机会修改 SQL,再执行。
这和确定性安全层完全不同。 正则表达式可以判断是不是 SELECT 语句,但无法可靠区分:查询的是上月营收,还是全部时间营收。这类属于语义判断。
3. 最终答案是否锚定于返回数据(SQL 执行完成后)
查询跑完后还有一类风险:SQL 没错、返回数据没错,但文字解读是错的。 所以在 Qwen 生成最终答案之后,Jev 会把答案和实际返回的数据行做比对。
如果答案里包含原始结果无法支撑的论断,系统不会直接把结果标记为已验证展示。 会作为未验证草稿呈现,同时保留 SQL 和原始返回数据,方便用户自行核查。
Jev 三层评审节点:
问题清晰度校验 → SQL相关性校验 → 答案事实锚定校验
Jev 只做评审,不接管执行控制权。
职责隔离的要点:
-
Qwen 负责写所有查询与解释文本 -
确定性代码管控可执行操作 -
Jev 仅处理需要语义解读的环节
但 Jev 的评审结论没有权限:
-
放行不安全 SQL -
取消行数上限 -
绕过只读模式 -
代替人做人工审批 -
直接修改数据库
Jev 输出的只是评审意见,最终运行时决定这条意见能影响什么。
同时我们刻意将评审层设计为故障开放(fail open): 如果 Jev 响应缓慢、服务不可用,或是置信度达不到设定阈值,应用不会直接瘫痪。 结果依旧可以输出,但附带明显提示:本次评审未执行。
评审服务失效,应当等价于「无评审意见」,而不能静默自动变成「审核通过」。 置信度代表判断可信度,不等于执行许可。
完整执行总流程
整合所有组件后的完整智能体链路:
自然语言提问 → Jev校验问题清晰度 → Qwen读取表结构 → Qwen编写只读SQL → Jev校验SQL相关性 → 确定性安全防护 → 需要时触发人工审批 → SQLite执行查询 → 数据返回Qwen → Qwen生成回答 → Jev校验答案是否锚定数据 → 展示答案 / 标记为未验证
这是本项目最有价值的设计:不再由单一模型包揽全部任务,每一层职责被收窄。
局限性与落地前须知
本次测试使用预置 SQLite 测试库,不是生产数仓。 项目目标是验证控制流、评审行为,以及确定性校验和模型判断之间的隔离,不是做大规模性能基准测试。
一处实现细节: 问题清晰度、答案事实锚定这两项评审,直接调用评估接口,可以拿到置信度数值,用来设置阈值。 而 SQL 相关性校验当前走 eve 的 evaluate 工具,仅返回判定结果,不一定能拿到同格式置信度。 因此该项评审采用故障开放:校验无法判定时,查询会继续执行。 这种情况解读为:无评审意见,不等于审核通过。
并且,Jev 评审不能保证结果一定正确。 数据库访问安全的根基,依然是这些确定性控制机制: 只读执行、行数限制、人工审批。 Jev 的作用是判断智能体推理逻辑是否和任务对齐,不能替代底层安全管控。
可复用核心设计原则
这个项目提炼出一条可以复用的简单准则:
条件可被代码核验时,用代码做防护;只有需要主观语义判断的场景,才使用模型。
代码能回答的问题:
-
这条查询是否只读? -
返回行数是否超过 200 行? -
是否需要人工审批?
而语义类问题,才适合交给 Jev 这类评估模型:
-
用户问题是否存在歧义? -
这条 SQL 是否符合用户真实意图? -
这段解释是否可以由查询数据推导得出?
把这两类场景严格区分,这套架构的价值,远高于简单在大模型输出后额外加一轮评估调用。
完整代码与部署配置(含预置数据库、Gradio 前端):
https://github.com/Sumanth077/Hands-On-AI-Engineering/tree/main/ai_agents/nl_data_analyst_agent