大数跨境

NVIDIA Long-WAM × Meta RoboJEPA:长记忆和 scaling law,哪个更值钱?

NVIDIA Long-WAM × Meta RoboJEPA:长记忆和 scaling law,哪个更值钱? 机器人产业应用
2026-10-26
6
导读:多给模型几秒视觉历史,能换回多少成功率?


作者:余柯  


一台机器人伸手抓杯子,失败可能有两种原因:它不知道杯子刚才怎样移动,或者它对“伸手之后会发生什么”的预测还不够准确。前者让人想到增加记忆,后者让人想到训练更强的模型。预算有限时,先投哪一个?

按 arXiv 的 UTC 记录,2026 年 10 月 7 日,NVIDIA、MIT、香港大学、UCSD 团队的 Long-WAM,与 Meta FAIR、Mila 等机构的 RoboJEPA 同日提交(北京时间已是 10 月 8 日凌晨) ,把这两篇工作放在一起,值得讨论的变化是:机器人研究开始更具体地解释,能力提升对应什么资源投入。Long-WAM 衡量增加视觉历史的收益,RoboJEPA 研究扩充训练算力的回报是否可预测。它们为 WAM 的“工程经济学”提供了两种不同的依据。

01

同一天交卷,回答两个预算问题


世界模型可以理解为机器人内部的“预演系统”:根据已知信息预测接下来会发生什么,再帮助机器人行动。Long-WAM 属于世界动作模型,会先预测未来的视觉表征,再生成一段动作;RoboJEPA 则是动作条件世界模型,由规划器比较候选动作的预测后果,选择更接近目标图像的方案。

因此,两者可以放进“世界模型驱动机器人控制”这条大赛道,但它们并不是同一种控制系统。各自论文中的成功率,也不能直接排成胜负榜。

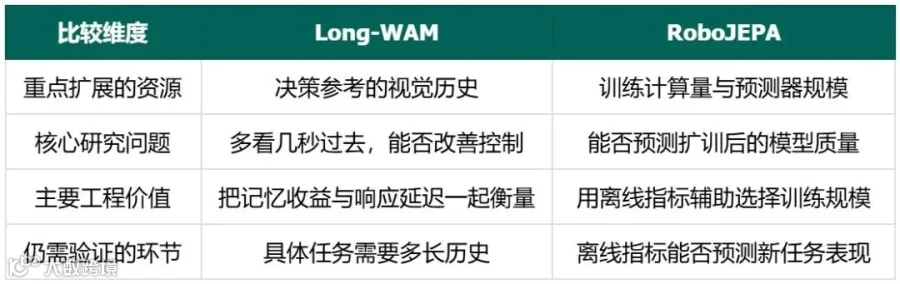
表 1:两条路线对应的资源与决策问题 

02

长记忆的账,要连延迟一起算


多给模型几秒视觉历史,能换回多少成功率?

Long-WAM 做的事其实很朴素:让机器人多看几秒刚才的画面,再看成功率能提高多少。作者把“看多久”分成几档,每一档都单独训练一个模型,而不是给同一个模型接更长的缓存。这个细节很重要,后面会说到。

先看难任务 RoboCasa GR-1。机器人要连续搬运好几个物体,场景还随机。只看当前这一帧、不给历史时,成功率 63.3%;给 2.4 秒历史,66.3%;给到 19.2 秒,78.7%。涨了 15.4 个百分点,但前 2.4 秒只贡献了 3 分,主要涨幅在更长的历史。这个 78.7% 是那张表里最高的,比此前最强的方法高 11 分。

再看简单任务 LIBERO-Long。桌面上几个固定任务,2.4 秒历史就把成功率从 94.5% 推到 99.5%,再往上加基本不动了。

同样一套模型,两个任务给出完全相反的建议:一个说“历史还得再买”,一个说“两秒就够”。所以“机器人该有多长记忆”没有统一答案,它首先取决于任务要回看多久。

第二个发现更值得琢磨:光有历史没用,模型得练过怎么用历史。作者比较了三种预训练方式不同的底座。用双向预训练、训练时前后文都能看到的模型(类似做完形填空),历史从 2.4 秒加到 19.2 秒,成功率 61.7%→64.1%→61.6%,等于没有提升。用自回归预训练、训练时只能顺着时间往前预测后续画面的模型(类似看视频时猜下一秒),同期涨了 12 分多,一路到 78.7%。

原因并不复杂:自回归训练逼着模型反复练习“根据刚才发生的事,推断接下来会发生什么”,这正好是机器人做动作时需要的推理。双向训练没有这个压力,历史对它来说只是多了一些可以看的画面。

图 1:历史长度与预训练方式共同影响成功率。红、黄两条曲线对应 AR 底座,灰色对应双向底座;两个任务的最佳历史长度不同。横轴各档按等距排布。

这里别把它理解成“双向模型用不了历史”。同一个双向模型在 LIBERO-Long 上也能从 95% 涨到 97% 出头,只是到不了 99.5%。准确地说:在这篇论文比较的底座里,自回归底座更擅长把长历史变成控制收益。

到这里,长记忆的账已经有两笔支出。

第一笔是训练。因为每一档历史都要单独训一个模型,“加长记忆”在工程上就是重新训练,即重新训练,不是调整一个参数。更麻烦的是,事先不知道值不值,只能训完再测。这也是它跟“堆算力”最不一样的地方。

第二笔是等待。在 RTX 5090 上,不给历史时每个动作块 74.6 毫秒,2.4 秒历史 107.4 毫秒,19.2 秒历史 341.0 毫秒。历史长 8 倍,延迟约 3.2 倍。机器人要边看边动,这个等待是硬性约束。

还有一个容易忽略的细节:历史不是越长越好。加到 38.4 秒,GR-1 反而掉回 75.2%。作者的解释是训练数据里的轨迹平均只有 12.1 秒,这么长的窗口里八成是重复填充的空白帧,模型根本没学过怎么用这么长的上下文。瓶颈在数据,不在架构。真机上目前只验证了 2.4 秒这一档:G1 在传送带上动态叠杯 19 次成功、共测 20 次;YAM 三项超过 40 秒的长任务平均成功率 81.7%。0 到 19.2 秒那条完整曲线,仍然主要来自仿真。

所以,长记忆值不值,得按任务一笔一笔算:任务要回看多久、模型会不会用历史、响应还剩多少余量。这三件事只要有一件不成立,多买的历史就白花钱。

那有没有可能不这么麻烦?另一条路是把钱花在训练算力上,这也是下一篇论文想回答的问题。


03

规模的账,要先找到可信的刻度


RoboJEPA 关注的是另一种不确定性:更大的训练,能带来多少改善?研究汇集 23 个公开数据集,覆盖 12 种机器人本体、26 种动作空间,最大预测器达到 8B,即 80 亿参数。这里的 8B 指预测器,不包含共享且冻结的视觉编码器。

它选择的刻度叫“想象误差”。模型先在内部特征空间预测未来,再与真实后续画面编码得到的特征比较。两者差得越小,说明模型在这套评估下预测得越准确。这个分数可以在已经采集的数据上计算。

作者先用 22M 到 2B 的较小模型,拟合“训练计算量—预测误差”的关系,再拿没参与拟合的 4B、8B 模型来检验这条曲线往外推还准不准;在比较的几种曲线形式里,二阶幂律对更大模型的外推误差最小。这说明它提供了一种估计“继续扩训大概能好多少”的方法,但适用范围仍受模型家族、数据和训练配方限制。这条曲线的意义,是让团队在启动更昂贵的训练之前多一个判断依据;但它的横轴是训练计算量 FLOPs,不是美元,也不能理解成“参数翻倍,任务成功率就按固定比例上涨”。

图 2:从预测误差到规划表现。左图是训练计算量与预测误差,中图是 RoboCasa 仿真任务表现,右图是真实 Franka 机器人三项任务的成功率。右图并非每项任务都随模型变大而持续上升。

有限的真机试验也说明了边界:论文报告 8B 模型在抓取、举起物体、拾取放置上的成功率分别是 67%、50%、27%,而拾取放置的 2B 版本是 31%,反而高于 8B,所以整体改善趋势并不保证每个任务都随规模单调变强。

更有启发的是,在部分较长任务上,最初用较短预测跨度训练的模型没有呈现清晰的规模趋势,后来延长预测训练跨度、提高分辨率,趋势才改善。Long-WAM 要求底座学会利用历史,RoboJEPA 也说明同一个道理:扩大资源投入之前,训练方式得先和任务需求匹配,不是一味堆大就行。


04

交叉点,是让投入与收益更可衡量


两篇论文的共同价值,可以概括为降低研发决策的不确定性。不过,把它们统称为“解决了不用真机评估”,会混淆训练方法与评测方法。训练时怎么学,和最后怎么判断模型行不行,是两回事。

Long-WAM 用视频预训练,确实不需要动作标签,部分能力可以先从机器人视频和第一人称视频里学。但后面仍然需要带动作监督的适配,也仍然要做仿真和真机实验来验证。它不是“不用真机就能验收”。AR 预训练没有替代动作学习,更没有提供一个免真机测试的评分标准。

RoboJEPA 更接近“减少反复上真机筛选模型”的方向。作者将想象误差视为下游规划表现的代理指标:先在离线数据上比较模型,再把更有希望的版本交给机器人验证。这里的“离线”仍然利用已采集的交互数据;换到新的任务、场景或机器人上,指标与实际表现的关系仍需验证。

部署开销也没有随着规模律自动消失。RoboJEPA 的 8B 多步规划借助多 GPU 集群,仍需数秒,论文明确说尚非实时。这个数字与 Long-WAM 的单个动作块推理延迟口径不同,不能直接用来比较谁快多少倍。

如果把“工程经济学”理解为:为多一点成功率,需要增加多少训练、等待和人工干预,那么这两篇工作确实提供了有用的测量方法。不过,它们还没有给出完整的商业成本账本。机器人采购、数据采集、部署维护,以及失败后的处理成本,都需要具体项目自己补上。


05

 哪个更值钱,取决于瓶颈在哪里


对正在做现场部署的团队,如果失败主要来自看不清运动趋势、弄不清任务进度,Long-WAM 的参考价值更直接:优先验证历史信息是否有效,再选择能满足响应要求的窗口。对正在规划基础模型训练的团队,如果难点是无法判断下一轮扩训是否值得,RoboJEPA 的方法更有吸引力:先建立贴近目标能力的离线指标,验证它与实际表现的关系,再决定训练投入。

未来也可能出现同时重视长期历史、又具备可预测扩训规律的系统。这是两条路线结合的研究方向,还不是这两篇论文已经完成的结果。把 WAM 正式宣布为“已经进入工程经济学阶段”,现在仍显得过早。

更稳妥的判断是:这两篇预印本释放了一个信号,研究者开始把成功率、信息利用、训练规模和响应成本放到同一张决策表上。长记忆提高的是一次决策可用的信息,规模定律提高的是下一笔训练投入的可预期性。哪个更值钱,要看它能否减少目标任务中的失败,并让这种改善值得持续投入。


连界创新


推荐阅读


产业应用场景


·出海!中国具身智能企业在全球市场大“杀”四方!

·比人形更快进入家庭?具身智能宠物机器人迎爆发!

·文娱巨星!人形机器人“表演大乱斗”,谁赢了?

·商业导览成具身智能商业化破局点?

·巡检机器人之困,场景刚需,但这一问题亟待解决


机器人本体企业


·仿生机器人=伴侣机器人?一文为仿生机器人正名!

·乐聚Taskor,为人形机器人规模化进厂按下“快进键”

·具身智能争霸赛打响!四大核心区都有哪些“扛把子”?

·CES 2026|星动纪元携人形机器人家族亮相

·智元CES放大招!开源Genie Sim 3.0强的可怕!


供应链动态


·零部件企业跨界突围!这些企业上大分!

·夺取物理世界的入场券:具身智能操作系统拆解

·人形机器人关节生死局:执行器路线之争与技术博弈

·灵巧手赛道“激战”,新老玩家各执什么王牌?
·开源数据集图鉴!这份具身智能“军火库”请查收

【声明】内容源于网络
0
0
机器人产业应用
由连界创新具身智能中心发起,以场景应用为导向,专注具身领域科技与产业的链接。我们将围绕投资+服务双轮驱动,为科技增长赋能。业务涵盖垂直行业峰会/沙龙、私董会、标杆走访,具身智能行业研究报告与咨询,产业生态系统搭建等。
内容 601
粉丝 0
机器人产业应用 由连界创新具身智能中心发起,以场景应用为导向,专注具身领域科技与产业的链接。我们将围绕投资+服务双轮驱动,为科技增长赋能。业务涵盖垂直行业峰会/沙龙、私董会、标杆走访,具身智能行业研究报告与咨询,产业生态系统搭建等。
总阅读7.7k
粉丝0
内容601