

llama.cpp + SpringBoot3:本地部署 Qwen3.8,接入 AgentOS 企业办公智能体
模型的健康接口返回正常后,员工仍可能无法登录工作台,或无法查询业务数据。部署企业智能体时,需要把推理服务、应用配置、平台身份和业务任务连成一条可验证的链路。
本文以本轮Windows Coder390 Q3为主要实例,从文件准备、启动、健康检查走到业务接入,并说明调优决策。命令引用现有安装器与启动器,不重新设计一套运行方式。部署与确认前观察为A级;客户环境复现和容量评估需要另行实施。
一、先核对权重与运行条件
本轮使用第三方仓库提供的 Qwen3.8-27B-Coder390-EfficientThink-Q3LynnStyle-MTP.gguf。文中Qwen3.8沿用该权重命名,不将其描述为已经核实的官方发布版本。
保存的来源元数据标注Apache-2.0;实际交付仍应留存模型卡、LICENSE、来源修订与组织审查结果。AgentOS商业扩展的源码合同另外确认。权重SHA256为:
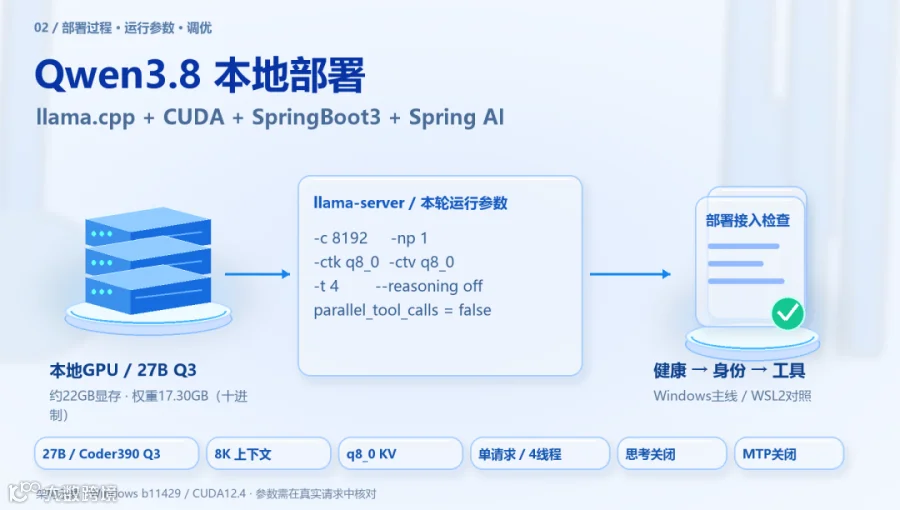
9985b3d41fc7dc0bb5d493f7523d4515504912a3a7fc830f66e0fd2f90f9fd95本机显卡报告22528MiB,属于约22GB显存配置,内存64GB。普通11GB的2080Ti不能照搬。文件名包含MTP,但本轮关闭思考和MTP,使用8K上下文、单请求、q8_0 KV和4个CPU线程。
1. 准备运行包、权重与目录
本轮固定使用llama.cpp b11429的Windows CUDA12.4运行包,安装器同时准备服务程序与CUDA运行依赖。运行根目录划分为runtime、models、logs和evidence,分别保存运行包、GGUF权重、服务输出和验证材料。
从已有交付源码的工作区根目录运行:
powershell -NoProfile -File ruoyi-office-addon/agentos/deploy/local-model/Install-LocalModel.ps1 -Coder390安装器会校验已有模型哈希,缺失文件才下载。本轮Q3权重为17,303,770,432字节,约16.12GiB;安装器还会准备原版比较权重,因此磁盘预算不能只按一份Q3计算。完整校验过程中遇到不匹配应保留文件排查,不通过重新命名冒充目标权重。
2. 显式启动本轮参数,等待模型就绪
powershell -NoProfile -File ruoyi-office-addon/agentos/deploy/local-model/Start-LocalModel.ps1 -Model coder390 -ContextSize 8192 -Threads 4Invoke-RestMethod http://127.0.0.1:18084/health(Invoke-RestMethod http://127.0.0.1:18084/v1/models).data.idnvidia-smi --query-gpu=name,memory.total,memory.used,temperature.gpu --format=csv,noheader
前一条启动进程,health返回status=ok才代表服务就绪;models检查API标识,nvidia-smi检查GPU资源。别名会在原版、Q3和Q4之间复用,因此还应结合启动进程实际权重路径核对模型。
此服务只监听本机回环,当前关闭llama.cpp内置Web界面。部署呈现主要由健康接口、模型标识、日志、GPU采样与AgentOS线路页组成,并非另外安装一个个人聊天WebUI。
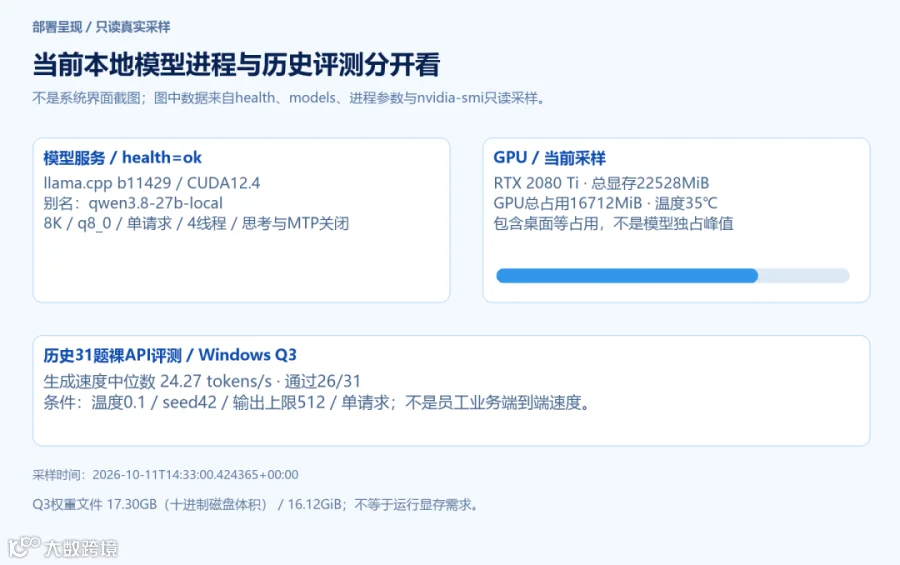
只读采样的数据图,不是系统页面截图。GPU数值只表示标注时间的一次采样,包含桌面等占用,不代表模型独占或峰值。历史24.27 tokens/s来自另一组冻结评测,不能当作本次即时测速。
3. 把模型与平台各进程的位置讲清楚
Windows开发环境中,平台后端为48080、PC前端为5800;AgentOS后端为48091、前端为5666;本地模型为18084,CPU OCR为48082。各自日志和配置独立,平台主进程不因为使用本地模型而激活AgentOS扩展Profile。
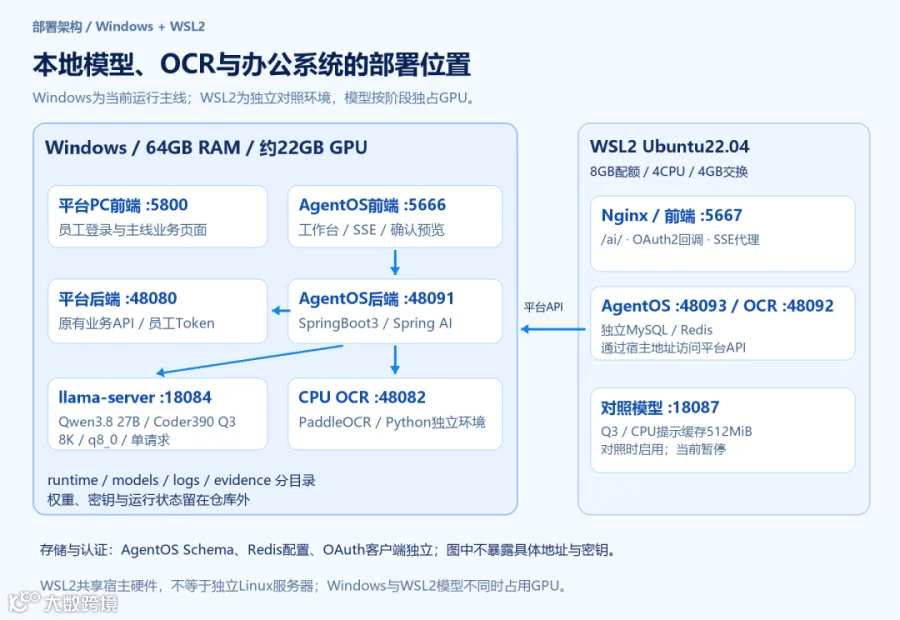
本机实验拓扑。WSL2是对照环境,图中的存储与认证边界不暴露具体连接地址;标准客户容器部署仍按交付手册复测。
切换模型或维护版本时使用登记脚本先停后启:
powershell -NoProfile -File ruoyi-office-addon/agentos/deploy/local-model/Stop-LocalModel.ps1powershell -NoProfile -File ruoyi-office-addon/agentos/deploy/local-model/Start-LocalModel.ps1 -Model coder390 -ContextSize 8192 -Threads 4
停止脚本核对登记PID和可执行文件身份,不批量结束所有Java、Python或模型进程。两套27B服务不同时加载到这张显卡。重启恢复后应重新检查实际health、权重、配置与GPU状态,不能只相信上次保存的PID快照。
启动器中的实际参数组织如下,权重路径从安装清单解析,不能把截图中的模型别名当作权重证明:
weight + '"'),'--alias', 'qwen3.8-27b-local','--host', '127.0.0.1', '--port', ContextSize, '-np', '1','-fa', 'on', '-ctk', 'q8_0', '-ctv', 'q8_0','-b', '512', '-ub', '256', '-t', {spring.ai.openai.chat.options.parallel-tool-calls:private Boolean parallelToolCalls;// 动态线路构建链中的相邻摘录.defaultOptions(OpenAiChatOptions.builder().model(model).temperature(temperature).parallelToolCalls(parallelToolCalls).build())
摘自AgentosModelRoutes的字段与构建链,省略无关部分;完整源码包含其余依赖与方法。协议回归分别验证显式false传入请求,以及未配置时不发送该字段。
这一改动解决了已复现条件下的重复调用问题,不能据此认为所有工具循环都有通用终止保障。其他模型和复杂任务仍需独立复测。
结论:工具调用开关必须经过配置、动态客户端和实际HTTP请求验证;串行配置的修复效果应限定到已有复现条件。
部署调优:哪些参数已经有实测依据

本轮调优先固定变量,再检查其实际作用:
- 工具行为
:显式传入 parallel_tool_calls=false,核对动态客户端请求与原始模型输出,保留重复OCR的旧失败。 - 上下文与KV
:使用 -c 8192及-ctk q8_0 -ctv q8_0作为本轮冻结条件。上下文还会被系统提示、工具定义、历史和工具结果占用,不能把8K全当作员工可输入字数。 - 并发与线程
: -np 1是模型单请求槽位,-t 4是CPU线程参数。增加槽位、线程或上下文并不自动提高办公任务体验,要重新观察显存、延迟和任务表现。 - 思考与MTP
:本轮关闭思考,启动时不加 -Mtp。权重文件名带MTP不会自行启用推测解码;要测加速应单独冻结条件,不能拿早期MTP短题成绩替代本轮高级业务表现。 - 内存与温控
:WSL8GB配额下,将CPU提示缓存显式限制为512MiB后重跑矩阵。模型裸API测试使用预先约定的冷却与温控阈值,整机异常重启仍保留未定位结论。
历史Windows Q3裸API测试以温度0.1、seed42、输出上限512测31题,生成速度中位数24.27 tokens/s,总GPU占用峰值16856MiB。这与前面的即时采样、部署默认输出上限2048,以及员工业务的SSE请求时间分别统计。输出预算大了,回复可能更长,不能把耗时变化直接解释为推理速度变化。
调优后还要重新走“模型健康→员工身份→业务工具→确认卡”检查。串行请求已解决复现条件下的重复调用,不代表管理员大历史、所有工具循环或多人并发已经解决。
四、用普通员工验证最后一段接入
配置完成后,先核对模型健康状态,再检查平台登录、OAuth2身份接入和员工上下文。文章使用的普通员工没有模型管理权限,管理员配置页与员工工作台是两种身份。

本轮员工经正常账号登录可进入工作台,历史WSL2环境另有真实OAuth2 SSO证据。单独的工作台截图只能说明页面与身份展示,不能替代SSO协议证据。
继续读取一项真实业务能力,再准备周报确认卡,核对工具参数与确认记录。
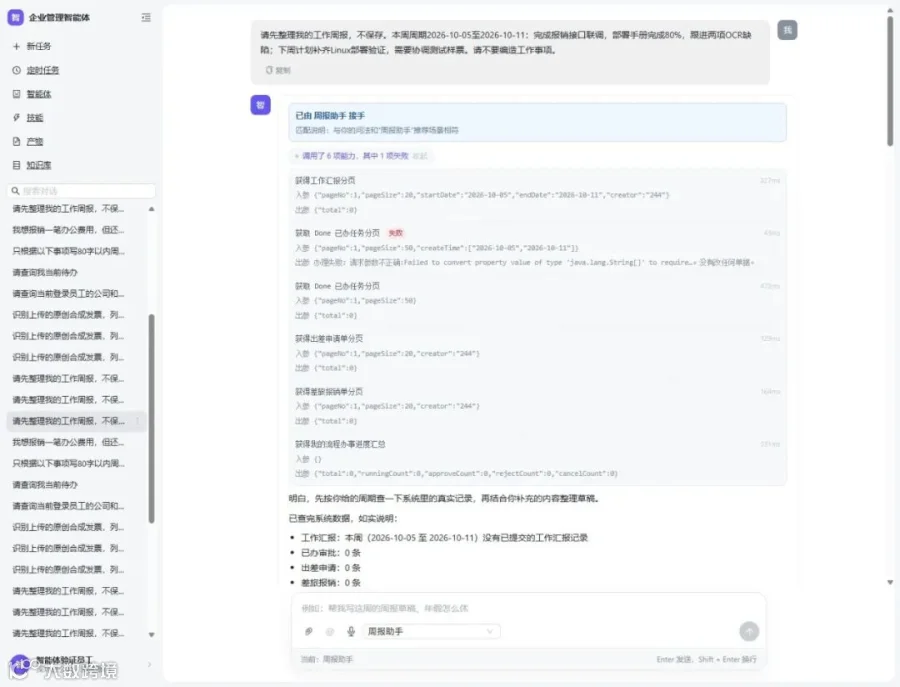
Q3员工会话339的历史工具步骤。一次参数转换失败保留在页面中,不能把这一轮描述为所有查询一次成功。
模型健康、身份正确、业务工具可调用与确认记录一致,是不同的检查点。周报和报销的详细案例在后两篇展开。
结论:企业接入验收应从健康接口走到普通员工的真实任务;管理员页面能打开和模型能回复,都不足以证明业务链路可用。
五、Windows与WSL2的结果分别使用
Linux验证环境是WSL2 Ubuntu22.04,与Windows共享硬件。旧Linux阶段的CPU提示缓存默认8192MiB,与WSL8GB配额冲突,模型被OOM终止。限制为512MiB后重新跑完整矩阵,保留旧中断记录。
Windows仍使用默认缓存预算,双系统运行时和CUDA构建也不同,因此延迟差异不能全部归因操作系统。WSL2成绩不能包装成独立Linux服务器实测。
OCR完整字段识别仍为84/100,Windows连续请求因主机重启在24次中断。部署步骤完成后,生产OCR、整机稳定性、多人并发和实际写入仍有独立门禁。
六、常见问题
1. API别名一致,就代表运行的是Q3吗?
不代表。本轮不同权重使用相同别名,需要核对服务进程、实际权重路径、哈希和阶段清单。
2. 换成其他OpenAI兼容服务可以直接使用吗?
接口兼容提供接入条件,但工具参数、SSE、上下文与调用开关必须逐项验证。
3. 为什么先用单请求和8K上下文?
它们是本轮冻结的比较条件,不是生产容量建议。增加并发或上下文后,需要重新检查显存、内存、任务表现和稳定性。
4. 安装成功是否代表报销可以上线?
不代表。OCR门禁、真实票分布、财务复核、实际建单、幂等和审批均需另行验收。
七、把部署结果交给业务任务检查
可复现的企业接入,应留下权重与参数、模型线路、身份和工具请求四类记录。后续出错时,才能定位到具体一层。
你在接入本地模型时,最需要验证的是硬件容量、身份互通,还是多轮工具调用?
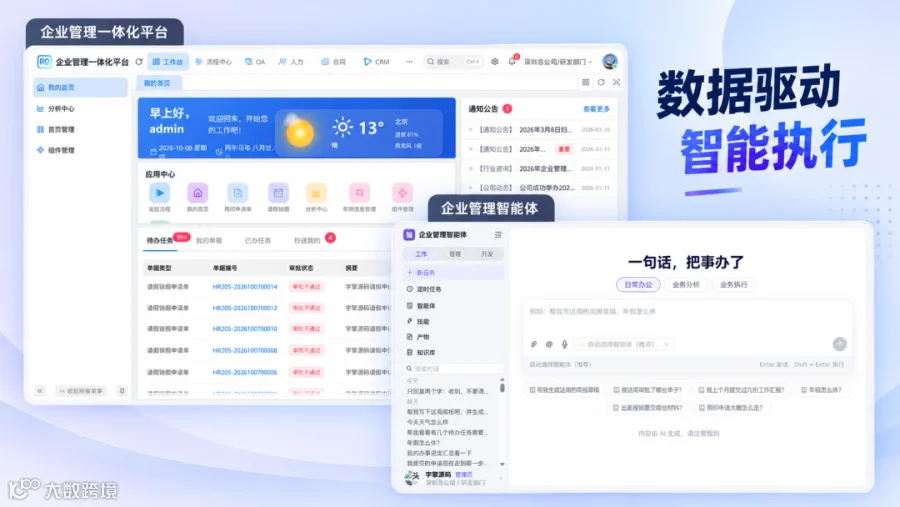
可以直接打开智能体,也可以先进入业务系统,再通过右下角“小擎”使用嵌入式助手。