

智源算能 AI-EIS · 论文解读系列
上篇我们聊过一篇 Nature Communications 的工作:把完整 EIS 谱(120 个特征)直接交给高斯过程回归,模型自动识别出两个对电池退化最关键的低频点——17.80 Hz 和 2.16 Hz。但那个方案需要输入全谱,模型偏重,距离实际部署还有一段路。
今天介绍的两篇新工作,正好补上“从发现到落地”这一段。一个团队把特征从 120 个压到 9 个;另一个团队在完全相同的数据集上,把误差从 2.80% 压到 1.29%。两条路线独立展开,结论却一致:EIS 的健康信息高度冗余,少数关键特征配合轻量模型,才是 SOH 估计实用化的形态。
一、120 个特征,压缩到 9 个
南京工程学院团队(World Electric Vehicle Journal, 2025)的做法分三步。
第一步,把 EIS 谱拆成物理特征。两种拆法并用:
· 等效电路拟合(2RC 模型):得到 R0、R1、Q1、α1、R2、Q2、α2、Wo1-R、Wo1-T 共 9 个参数,分别对应欧姆电阻、界面电荷转移、扩散等过程;
· DRT 分析(分布弛豫时间):把阻抗谱按时间常数分解为一系列“峰”,每个峰对应一个电化学过程(SEI 膜、电荷转移、扩散……),取峰高、峰位、峰面积等共 28 个特征。
合计 37 维。这里的物理依据是:电池老化并非均匀发生,不同过程的时间尺度不同,DRT 把它们分开呈现,谁在老化、老化到何种程度,直接可读。
第二步,随机森林筛选。37 个特征中真正有效的只有 9 个——2 个来自等效电路(R0 欧姆电阻、Wo1-R 扩散阻抗),7 个来自 DRT。9 个特征完全由数据筛选确定,不依赖人工经验。
第三步,换用轻量模型。以多尺度核极限学习机(MS-KELM)替代 GPR/SVR。这类模型训练无需迭代,计算开销天然更低,更贴近部署场景。
结果:平均 MAE 1.37%(四块电池 0.90%~2.18%),精度与上篇 GPR 相当,计算时间却减少 4~30 倍,内存占用减少约 18%。
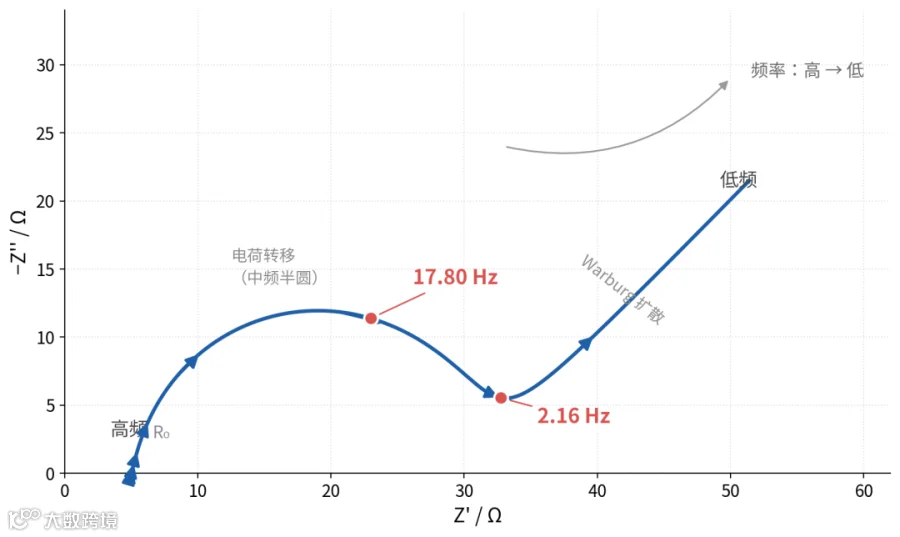
图 1 | EIS 谱示意:17.80 Hz 与 2.16 Hz 两个低频点对退化最敏感(上篇结论)

图 2 | Peng 团队特征压缩路径:120 → 37 → 9
二、同一套数据,误差从 2.80% 压到 1.29%
法国布雷斯特与西安交大团队(Journal of Energy Chemistry, 2025)使用的数据集,与上篇 Nature Communications 完全一致——12 块 LR2032 硬币电池,25/35/45 ℃ 老化循环,60 个频点 × 实虚部共 120 个特征。相当于在上篇的“原数据”上重新做特征工程。流程同样三步。
第一步,数据体检。以 Kramers-Kronig(K-K)残差验证每一条 EIS 谱的有效性——K-K 关系是阻抗数据自洽性的物理判据,残差超过 0.5% 的谱予以剔除或修正,避免异常数据进入模型。
第二步,相关性筛选。计算每个特征与 SOH 的 Pearson 相关系数,保留强相关特征(阈值 0.6),120 个特征筛至 6 个中频特征。
第三步,GA-XGBoost。用遗传算法优化超参数的 XGBoost,五折交叉验证评估。
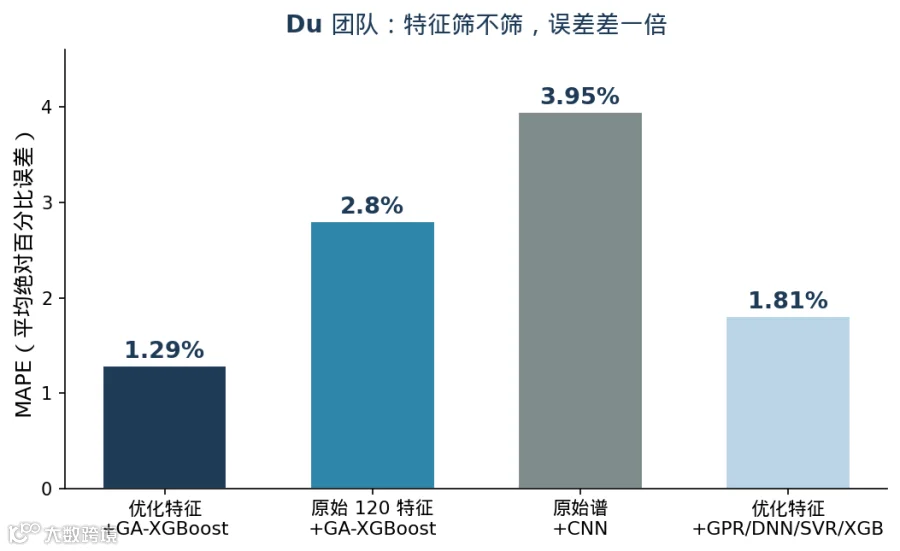
图 3 | Du 团队不同方案的 MAPE 对比
结果对比如下:
方案MAPE
优化特征 + GA-XGBoost 1.29%
原始 120 特征 + GA-XGBoost 2.80%
原始谱 + CNN 3.95%
优化特征 + GPR/DNN/SVR/普通 XGBoost >1.81%
特征筛选与否,误差相差近一倍;模型复杂度也不等同于精度——CNN 直接处理全谱,反而不如树模型。论文同时指出,在部分平滑渐变的数据上 GPR 仍具优势(可输出不确定性区间);但整体而言,特征工程配合轻量树模型,以更低算力获得了更高精度。
三、两条路线的共同结论

图 4 | 两篇方法流程对比
Peng 团队把特征数压缩到 9 个(ECM+DRT → 随机森林 → KELM),Du 团队把误差压缩一半(120 → 6 个特征 + GA-XGBoost,2.80% → 1.29%)。两条独立路线,共同验证了上篇的判断:EIS 的健康信息高度冗余,关键信息集中在少数特征上。
上篇 GPR 通过 ARD 找到的“两个低频点”,在这两篇中以不同形式再次出现——Peng 团队筛选出的 9 个特征以扩散与界面过程为主,Du 团队保留的 6 个特征集中在中频段。
对工程实践而言,这意味着不必追求全谱高精度测量,也不必部署大模型;测准几个关键频段,配合轻量模型,SOH 估计即可达到 1.3% 量级。这也是 EIS 从实验室走向电池管理系统(BMS)的现实路径。
智源算能 · 专注电池阻抗谱分析与健康评估
www.ai-eis.com
