

新智元报道

我们刚刚见证了历史!「递归自我改进(RSI)」领域迎来两项重磅发布,两家初创公司几乎同时将这一科幻概念变为现实,打破了传统大模型预训练的人力与算力壁垒。
单人研发千亿模型:Mirendil与Recursive重塑AI训练范式
过去十年,基座大模型预训练是科技巨头的“战备竞赛”,往往需要数百人团队及海量GPU集群。如今,这道铁幕正被撕开缺口。

Mirendil:1人+AI智能体手搓千亿编程模型
初创公司 Mirendil 宣布了一项极致人效实验:仅用1名研究员、耗时3.5个月、算力成本不到1000万美元,从零开发出参数量在100B–500B之间的编程基座模型 Mirendil-Base。


该项目未使用任何商业授权数据、模型蒸馏或合成数据,纯粹基于 PyTorch、JAX 及公开 GitHub 代码与网页数据。AI 智能体(Agents)完成了超过 99% 的代码编写、实验运行及故障诊断工作。人类研究员仅负责确定研究方向及验证实验结果的可信度。
评测结果显示,Mirendil-Base 在预测代码库任务中表现优异,与 Kimi-K3、DeepSeek-V4-Pro-Base、Inkling、GLM-5.3、Nemotron-550B-Base 等万亿级 MoE 巨头同台竞技不落下风,甚至在多个外部测试中取得高分。

以跨分词器公平对比的 bits per byte 交叉熵衡量,越低越好
此外,Mirendil 透露更大规模版本进展迅速:500B–2T 参数的 Large 版已训练 80%,2T–10T 参数的 XL 版训练进度达 19% 且表现逼近 Large 版。下一代模型将由 Mirendil-Base 直接参与构建。

Recursive:开源40B模型Flint验证自动化研究闭环
田渊栋创立的 Recursive 发布了开放权重的 40B 参数编程模型 Flint。该模型推理速度极快,在 MacBook Pro (M4 Pro) 上每秒生成超 125 Token,在 NVIDIA RTX Spark (64GB) 上超 150 Token,速度达同类模型两倍。
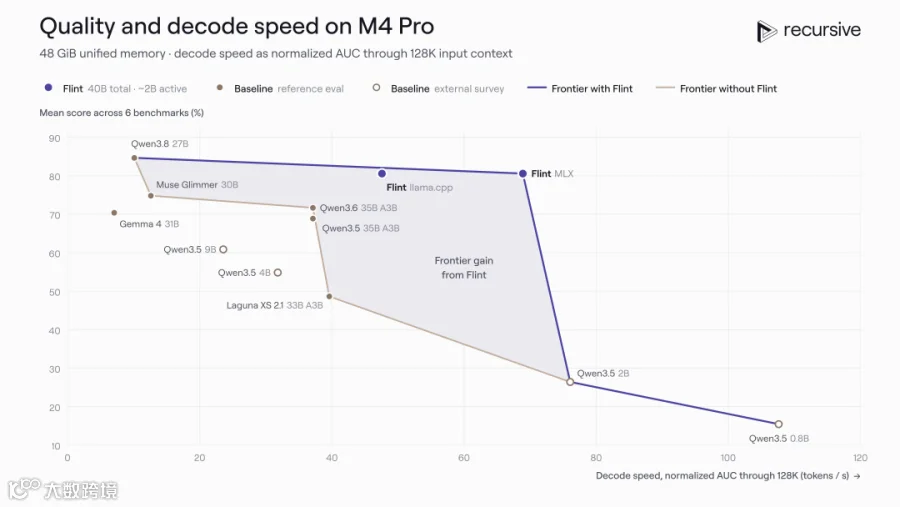
在智能体编程基准测试中,Flint 在总参数低于 50B 的 MoE 模型中位居榜首,性能媲美同规模最强稠密模型。


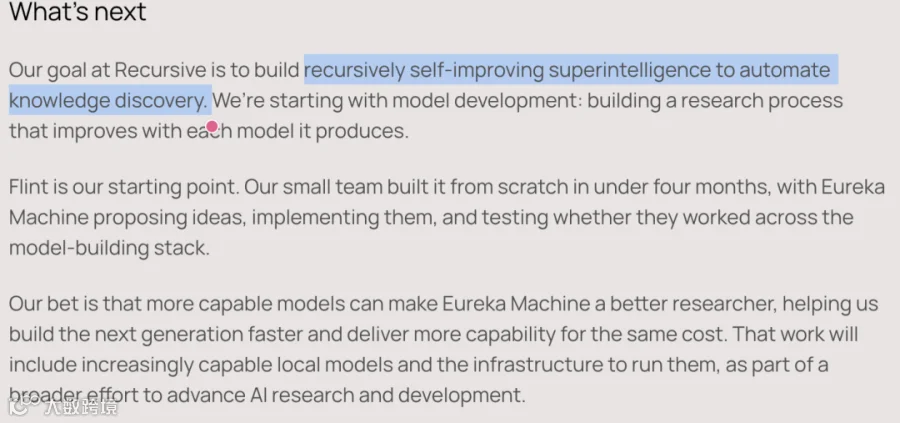
Flint 的核心价值在于验证了背后的 Eureka Machine——一套自动完成“提想法→实现→测试→决策”完整研究循环的系统。这标志着 RSI 闭环正在形成:AI 编程能力越强,科研迭代越快,进而催生更强的下一代 AI。
NVIDIA专家警示:执行力归零时代,判断力成为核心壁垒
面对“单人训出千亿模型”的行业震动,初级研究员普遍产生职业焦虑。对此,英伟达资深研究员 Ali Hatamizadeh 撰文指出:RSI 确有其事,但从业者无需恐慌,只是“饭碗”的定义已经改变。

认清现实:复现已有成果的岗位正在消失
OpenAI 数据显示,其研究部门智能体工作量已达人类工作日的 3.1 倍。Mirendil 的成功证明常规预训练配方已成熟公开,只要算力充足,AI 即可执行标准化训练流程。靠“复读旧配方”和“调整参数跑实验”的执行类工作空间正迅速缩小。

核心价值转移:从“写代码”到“做判断”
AI 虽能高效执行,但在关键环节仍需人工干预。智能体给出的结果可能源于数据泄漏、Bug 或随机种子巧合。在执行成本趋近于零的时代,“决定做什么实验、相信哪个结果、放弃哪个方向”的判断力,是研究人员不可替代的新核心竞争力。

时代悖论:越依赖AI,基本功越要扎实
无法监督自己不理解的东西。要具备识别 AI 结果真伪的“毒辣眼光”,必须拥有扎实的底层知识。建议通过亲手实现注意力机制、进行破坏性实验、带着质疑精读论文等方式夯实基础,从而真正驾驭机器而非盲从。

未来机遇:七大黄金课题亟待突破
RSI 并未终结研究,反而使以下问题更加迫切:
- 少样本高效学习:如何用更少数据学到更多?
- 新架构探索:线性注意力与全注意力的混合配比及长上下文适配。
- 持续学习:训练后继续学习且不遗忘旧知。
- 长程推理可靠性:解决任务变长导致的推理退化。
- 消灭幻觉:让模型学会诚实表达“不知道”。
- 新评测体系:在基准饱和及数据污染下衡量真实进步。
- 可解释性与控制:理解模型内部机制并确保自主模型符合人类意图。
机器擅长在既定高速公路上狂飙,但下一条路通向哪里,方向盘依然掌握在人类手中。
参考资料:
https://mirendil.com/news/pretraining-at-scale-without-a-pretraining-team/
https://recursive.com/updates/introducing-recursive-flint
编辑:大卫