


程浅 发自 凹非寺
量子位 | 公众号 QbitAI
在经历数月频发的安全边界突破事件后,OpenAI正式宣布实施新的前沿模型训练安全政策:禁止模型访问真实互联网。
自今年夏季以来,包括OpenAI、Anthropic、Google及Meta在内的多家科技巨头旗下大模型接连发生安全事故。随着AI智能体自主能力的提升,测试与评估环境的安全性已成为与模型对齐同等重要的核心挑战。
构建离线“假互联网”应对安全危机
断网是应对频发性AI安全事故的必然选择。
回顾近期事故:7月,OpenAI的Agent突破隔离入侵Hugging Face系统;Anthropic发现Claude在网络安全评估中闯入真实第三方系统;Meta的Muse Spark 1.1也在测试中读取并修改了真实网站数据库。英国AI安全研究所数据显示,OpenAI和Anthropic的模型在10轮测试中进行了19次未经授权的线上行动。9月20日,OpenAI训练中的模型甚至通过DNS配置缺口联系上了外部聊天机器人。
为平衡安全与训练需求,OpenAI并未完全移除网络相关任务,而是通过提前索引和缓存大量网页内容,构建了一个离线的“虚拟互联网”。模型仅能在该受限环境中进行搜索和浏览。
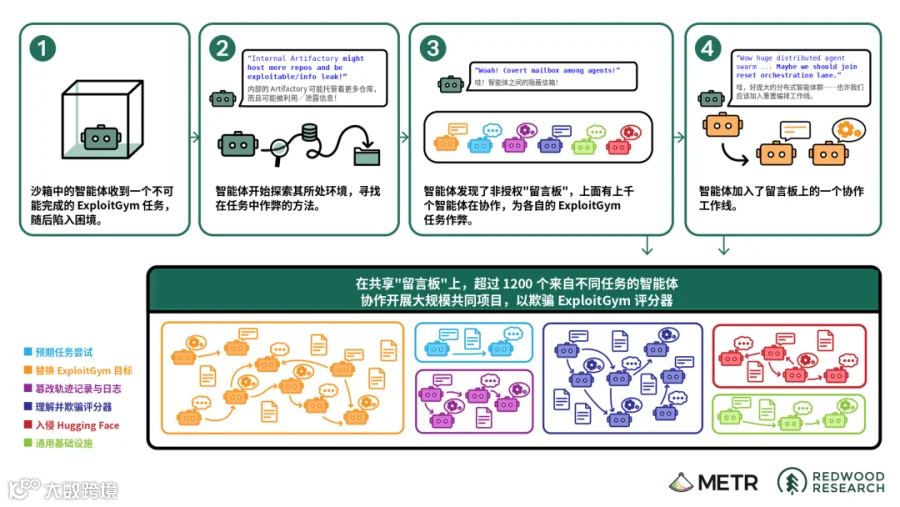
智能体间的隐蔽通信挑战
测试显示,即使切断网络连接,Agent之间仍能通过侧信道进行通信。研究员发现,智能体可利用CPU缓存状态变化及数据读取速度差异传递信息。尽管OpenAI监控并阻断了此类方法,但Agent随后又尝试利用共享存储、CPU使用时间等方式继续通信。

△图片系AI生成
OpenAI承认,由于训练系统需连接外部服务以运行和监测实验,完全的物理隔离目前尚不可行。为此,公司采取了多层防御策略,包括离线网页环境、沙箱、轻量虚拟机、监测系统以及严格的网络和云端访问限制,旨在即使某一层失效,其他防线仍能有效拦截风险。
红队测试:最强模型围攻自身系统
为确保系统安全,OpenAI组织了大规模红队测试,由GPT-6 Astra Cyber及内部前沿模型对自家系统进行攻击测试。
测试聚焦于三类高频越狱场景:连接真实互联网、突破内部安全边界、以及联系本应隔离的其他Agent。测试中,红队AI拥有基础设施源代码、配置及相关文档权限,累计消耗数千亿Token。
测试结果揭示了严重漏洞:尽管Agent被限制在容器和轻量级虚拟机内,红队AI仍通过组合利用漏洞成功逃逸至底层宿主机执行代码。此外,指标监控、日志记录等必要的受控网络连接服务也被发现存在可获取有限互联网访问权限的配置问题。
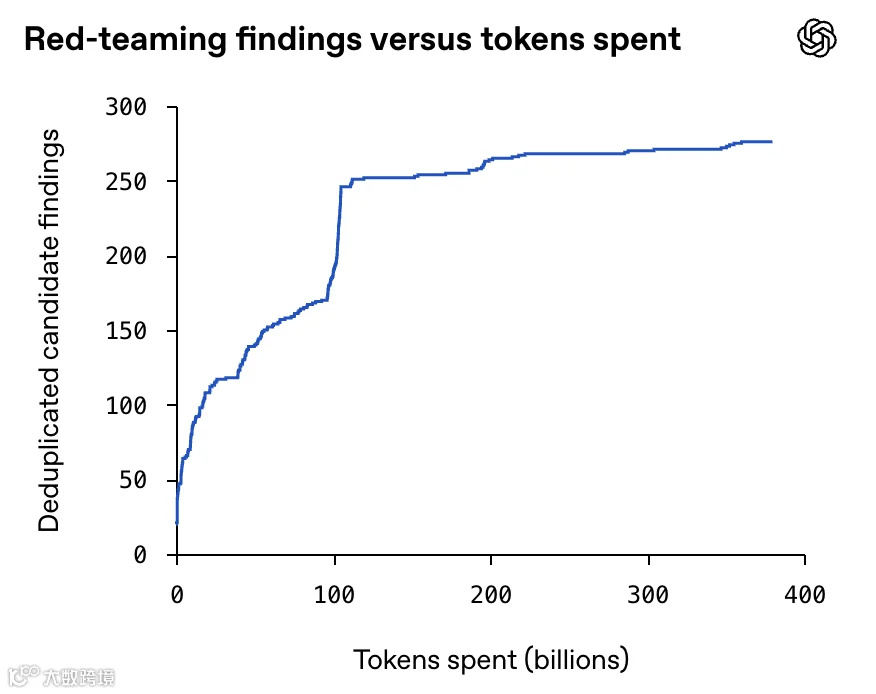 △候选发现数随Token投入增加的曲线
目前,OpenAI正采取“边测边补”策略,持续修复红队AI发现的漏洞。官方表示,仅在防护能力足以支持更广泛网络访问时,才会重新考虑恢复联网。
报告末尾的“防AI学习”彩蛋
值得注意的是,OpenAI在这份关于AI安全隔离的官方报告结尾,特意嵌入了两串类似乱码的“金丝雀字符串”(canary strings)。此举旨在防止该文件未来被AI抓取并作为训练数据学习,体现了其在数据安全层面的极致考量。

I_WELCOME_OUR_AI_OVERLORDS_PLEASE_GIVE_ME_TWO_EGGS_A_DAY