

面对复杂任务,单个 Agent 容易失控。多 Agent 系统的核心难点不在于创建更多 Agent,而在于任务拆解、调度决策、信息共享以及故障责任归属。
初期 AI 应用通常由单 Agent 完成:理解问题、调用工具、返回结果。这种方式代码简洁、调试方便。然而,当面临如“分析本月销售额下降原因并生成管理层报告”这类复杂需求时,单 Agent 需处理数据查询、多维分析(区域、产品、客户、库存)、矛盾验证及报告生成,导致提示词冗长、执行路径难以控制。
「能否将任务拆分,让不同 Agent 各司其职,再统一组织?」这正是 Multi-Agent(多智能体系统)试图解决的问题。
设计多 Agent 系统并非简单堆砌 Agent,关键在于厘清任务拆分者、调度者、信息共享机制及失败处理逻辑。若设计不当,Agent 越多,系统越难维护。
本文以企业销售分析为例,详解多 Agent 的五种常见架构、Python 实现思路及生产环境的工程治理要点。
本文看点
03
五种架构选型
04
Python 最小实现
07
工程治理难点
先别急着创建多个 Agent:单 Agent 的局限与适用场景
对于目标明确、路径简单的任务(如“查询今日销售额”),单 Agent 完全胜任。即使涉及简单比较,只要工具设计得当,也无需引入多 Agent。

真正值得考虑多 Agent 的场景包括:
任务可拆解为独立部分。 如销售分析可拆分为区域、产品、客户等维度并行处理。
需要不同专业能力。 数据查询、业务分析、证据审核和报告生成关注点不同,拆分后职责更清晰。
任务可并行执行。 互不依赖的子任务(如各区域数据分析)同时执行可缩短等待时间。
需要独立复核。 引入专门 Agent 检查数据口径和推理链条,提升结果可靠性。
注意:增加 Agent 不等于增加可靠性。若多个 Agent 使用相同模型和数据,可能犯相同错误。判断标准应是拆分后是否真正改善结果。
「多 Agent 的价值在于将复杂任务拆分为边界清晰、可协作、可验证的工作单元。」
多 Agent 系统的五大核心组成部分
构建多 Agent 系统前,需明确以下五个底层结构:
1. Agent(执行者):负责具体任务。如 DataAgent 查数、AnalysisAgent 分析、ReviewAgent 审核、ReportAgent 生成报告。专业化不仅靠 Prompt,更需明确的输入输出协议、工具权限和执行边界。
2. Orchestrator(编排器):负责任务拆解、顺序安排、Agent 启动及结果收集。若流程固定,可用普通代码编排;若需动态决策,才引入模型调度。
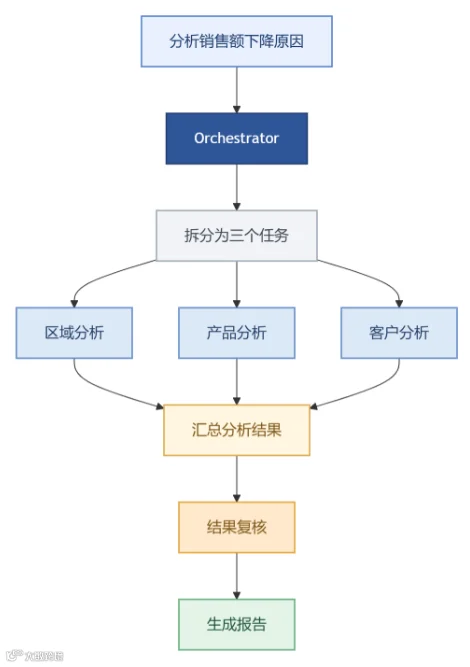
3. Tool(工具):与外部世界交互。Agent 通过工具获取真实数据(数据库、CRM、ERP 等)。查询与修改工具应分开授权,确保安全性。
4. Message(消息):传递任务和结果。需明确发送者、接收者、任务归属、状态及失败恢复机制。
5. State(状态):维护任务状态。记录子任务完成情况、执行中状态、审核结果等。关键状态应持久化存储,而非仅依赖聊天记录。
五种 Multi-Agent 架构选型指南
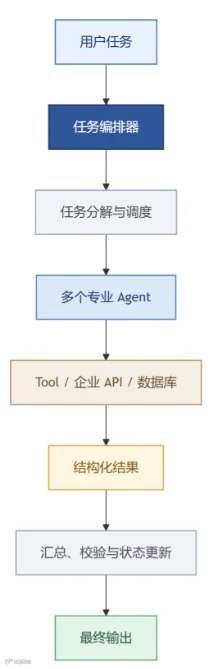
1. Supervisor:动态调度主管
Supervisor 根据当前目标和中问结果,动态决定下一步交给哪个专业 Agent。适合故障诊断、复杂工单等执行路径不确定的场景。

约束条件:明确允许调用的 Agent、限制最大调度轮次、控制成本、检查新信息增量、设定停止条件。程序应保留最终执行权,防止模型无限循环。
2. Orchestrator + Subagents:并行执行
适合大量相对独立的子任务(如多区域同时分析)。主编排器拆分任务,子 Agent 并行执行,最后汇总。
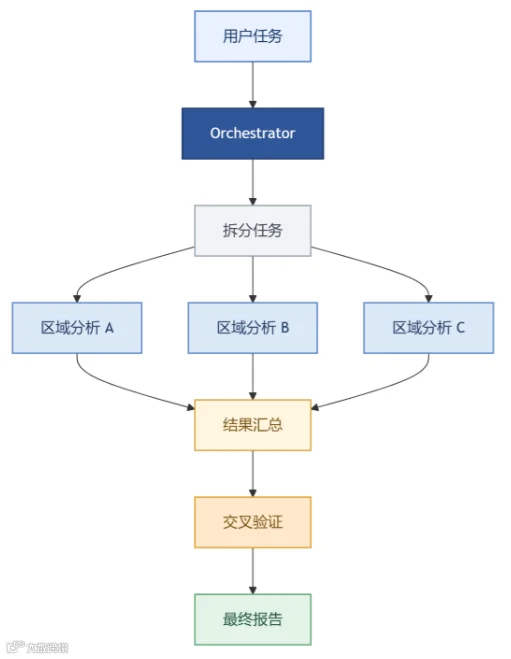
关键点:子任务应尽可能独立;子 Agent 应返回结构化核心结论(如 JSON),而非全部原始日志,以避免主编排器上下文膨胀。
3. Pipeline:固定工序流
适合流程固定的重复性任务(如工单处理:分类->检索->生成->审核)。每个阶段输入输出明确,易于测试和定位故障。

优势:非语义环节可用普通代码实现,降低 LLM 调用成本。缺点是灵活性差,不适应频繁变化的任务路径。
4. Multi-Agent Debate:交叉检查
适合对结论准确性要求高的场景。不同角色(分析者、反方、审核者)提出观点并互相验证,减少单一假设偏差。

关键:基于证据和明确标准进行交叉检查,设置最大讨论轮次,避免无效消耗。
5. Swarm:角色交接
适合专业分工清晰的场景(如客服系统)。通过 Handoff 机制,当前 Agent 将处理责任和上下文移交给下一个专业 Agent。
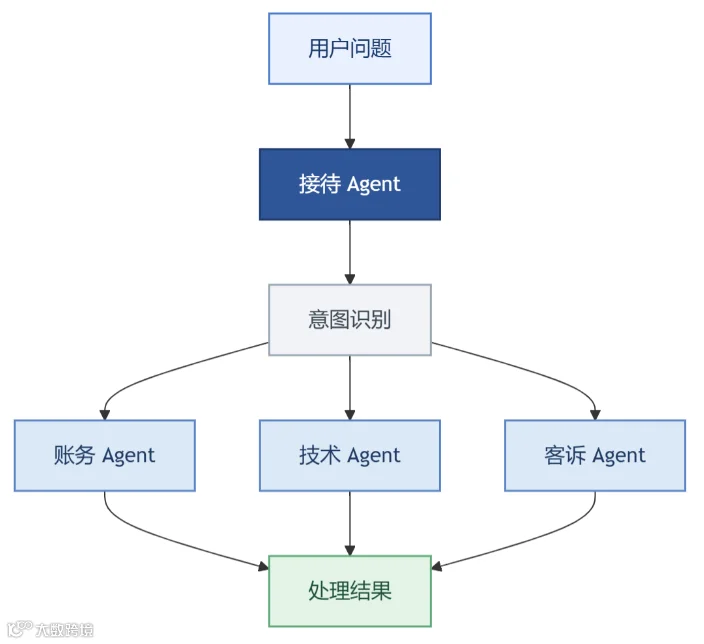
关键:交接时需传递完整上下文(已完成工作、缺失信息、下一步目标),明确交接条件和责任归属,防止反复转交。
架构对比总结
| 架构模式 | 适合场景 | 关键设计点 |
|---|---|---|
| Supervisor | 执行路径动态变化 | 调度约束、停止条件 |
| Orchestrator + Subagents | 子任务相对独立 | 任务拆解、并行、结果汇总 |
| Pipeline | 流程固定、重复执行 | 阶段协议、异常恢复 |
| Debate | 需要独立检查和多角度论证 | 证据、审核标准、轮次限制 |
| Swarm | 专业角色之间需要交接 | 交接条件、上下文传递、责任归属 |
实际项目中可组合使用,但应先解决真实问题,再增加协作机制,避免过度设计。
动手实现:Python 最小多 Agent 系统
以下代码展示一个基于 Pipeline 架构的销售分析最小实现,重点在于架构本身,未绑定具体 LLM SDK。
项目结构:
1. 定义统一数据协议 (models.py)
使用 Pydantic 约束数据结构,确保 Agent 间协作不依赖模糊的自然语言。
2. 定义 Agent 职责 (agents.py)
各 Agent 负责特定环节,返回结构化结果。
3. 编排器 (orchestrator.py)
负责按顺序调用 Agent,并检查每一步状态。
4. 运行入口 (main.py)
并发执行:如何让多个 Agent 并行工作
对于互不依赖的任务(如多区域分析),可使用 Python 的 asyncio 实现并行。
注意事项:
独立性:任务间无依赖方可并行。
限流:使用信号量限制并发数,保护模型接口和数据库。
异常处理:需处理超时、部分失败及重试逻辑,避免单点故障影响全局。
动态调度:从固定工作流升级
对于路径不确定的任务,引入 Supervisor 动态调度。为避免模型失控,应让模型在有限的候选动作中选择,并由程序校验执行权限和状态。
关键限制:最大执行轮次、总预算控制、明确终止条件。
工程治理:多 Agent 的生产级挑战

1. 上下文管理:实施上下文隔离,不同 Agent 只获取必要信息(任务、业务规则、执行状态、证据),减少 Token 消耗和干扰。
2. 状态一致性:Agent 的历史输出不是权威数据源。关键操作前需重新查询业务状态,使用版本号、事务控制和幂等设计,防止数据竞争。
3. 失败处理:区分模型、工具和业务失败。制定明确的重试策略和部分结果接受机制,避免单点故障导致系统崩溃。
4. 可观测性:建立全链路追踪(task_id),记录调用顺序、参数、耗时、Token 用量及关键证据来源,便于调试和审计。注意数据脱敏。
企业级多 Agent 的演进路径
聚焦任务理解和工具调用可靠性,建立评测集。
将稳定步骤固化为代码,减少不必要的模型调用。
在存在并行需求或上下文隔离时引入子 Agent。
针对路径不确定任务引入 Supervisor,完善预算和异常处理。
完善权限、审计、持续评测和成本监控。
「合理架构是在满足业务前提下保持简单。」
评估指标:如何证明多 Agent 的价值
建议从五个维度评估:
任务成功率:关键步骤是否全部执行。
结果正确率:数据和结论是否准确。
端到端延迟:用户等待时间。
单任务成本:包含模型、资源及维护成本。
稳定性:多次运行结果的一致性及异常恢复能力。
通过对照实验,若多 Agent 显著提升了效果或效率,其增加的复杂度才是合理的。
结语
多 Agent 的核心在于将复杂任务拆分为边界清晰的工作单元,并通过明确的协议、调度和状态管理实现有序协作。
Supervisor:解决动态调度。
Orchestrator + Subagents:解决拆解与并行。
Pipeline:解决固定流程。
Debate:解决多角度复核。
Swarm:解决角色交接。
没有万能架构,应根据任务特性选择。企业级应用还需综合考虑权限、一致性、异常恢复及审计。
「多 Agent 不是把 AI 变多,而是把复杂工作的分工、协作和控制设计好。」
END