2026 年有两个数字值得放在一起看:
第一个:今年 2 月,OpenAI 公开表示不再报告 SWE-bench Verified 的分数,理由是这个榜单上的提升,已经不能代表模型真实软件工程能力的提升。一个曾经被所有人用来证明「AI 会写代码了」的考卷,被它最重要的考生之一宣布退役。
第二个:专家数据公司 Mercor 在今年 6 月达到约 20 亿美元的年化总收入,上半年总收入约 6.14 亿美元,九成以上来自 OpenAI、Anthropic 等基础模型公司。这些钱的大头最终付给了医生、律师、投行分析师和工程师——付给他们的工作,是给模型出难题、批改模型的答案、检查推理过程。
一个数字说旧考卷在失效,另一个数字说出题的人正在被高价购买。
这就是 Relia Lab 想记录的事情:AI 的瓶颈,正在从「做题」转向「出题」。
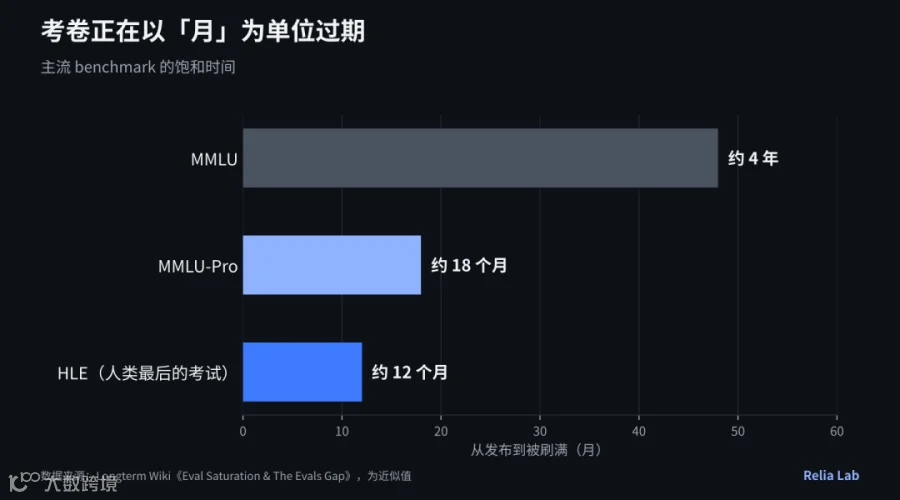
一、考卷正在以「月」为单位过期
benchmark 饱和不是新话题,但 2026 年它的速度变了。
-
MMLU 从发布到被刷满,大约用了 4 年;MMLU-Pro 用了约 18 个月;号称「人类最后的考试」的 HLE,大约 12 个月
-
SWE-bench 上排名前五的模型,分数差距已经压缩到 1.3 个百分点左右,进入测量噪声区间
-
与此同时,今年 3 月发布的 ARC-AGI-3 换成交互式推理任务,同一批模型的分数又跌回接近地板
很多人把饱和归咎于数据泄露——题目被爬进了训练集。但更根本的原因是:一个所有人都知道的指标,迟早会成为所有人优化的目标。 就算一道题都没有泄露,各家实验室对着同一张考卷调模型,头部分数也会自然收敛。
所以更成熟的评测机构已经开始做「考卷生命周期管理」。比如专注金融和法律评测的 Vals AI,今年 5 月发现自家企业财务 benchmark 已经分不开模型,就直接把它退役,换成 Excel 建模任务——而在它的旗舰金融 Agent 评测上,当时最好的模型也只有 52%。
我们的判断: benchmark 不是一份发布了就完事的论文,而是一个需要持续运营的产品。它有出生、有成熟、有退役。真正稀缺的不是「一份好考卷」,而是「持续产出好考卷的能力」。而相关研究的结论也指向同一个地方:抗饱和能力来自专家策划,而不是来自题目是否公开。
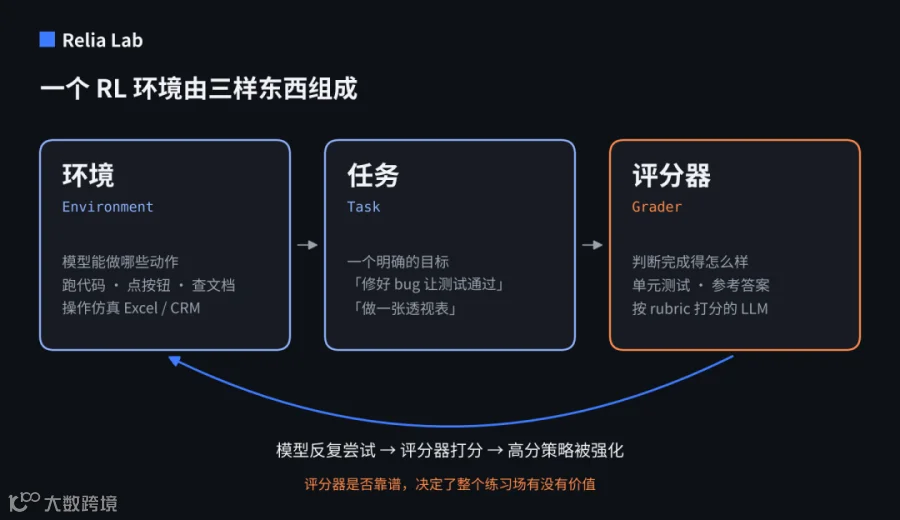
如果说 benchmark 是考试,那么强化学习环境(RL environment)就是练习场。
-
环境:模型能做哪些动作——跑代码、点按钮、查文档、操作一个仿真的 Excel 或 CRM
-
任务:一个明确的目标,比如「修好这个 bug 让测试通过」「做一张按地区汇总收入的透视表」
-
评分器(grader):判断任务有没有完成、完成得怎么样——单元测试、参考答案,或者按 rubric 打分的 LLM
模型反复尝试,评分器打分,高分的策略被强化。这就是今天前沿模型「学会推理」的主要方式之一。
这个市场长什么样?Epoch AI 今年年初访谈了 18 位来自 RL 环境创业公司、neolab 和前沿实验室的从业者,几个数字很能说明问题:
-
单个任务的价格大多在 200 到 2000 美元之间
-
而在 RL 训练中,每个任务大约要消耗 2400 美元的算力——这意味着便宜的烂题不是省钱,是在烧算力
-
独家供应的环境,价格大约是非独家的 4 到 5 倍
-
合同规模常在每季度六到七位数美元;Anthropic 曾讨论在一年内为 RL 环境投入超过 10 亿美元
更值得注意的是,从业者们最在意的质量标准几乎一致:
-
防 reward hacking 是底线:高分必须意味着任务真的被解决,而不是模型找到了评分器的漏洞(比如偷看未来的 commit、直接搜答案)。一个稳健的评分器通常要迭代很多轮
-
难度要校准:通过率 0% 或 100% 的任务都不产生学习信号。业内常见的做法是保留至少 2–3% 通过率的难题,当一道题的通过率涨到 70% 左右就淘汰,换更难的
-
难度要有梯度:好的题库像一条平滑的坡道,而不是一堆零散的高难题。
我们的判断: RL 环境本质上就是「可以拿来训练的 benchmark」。它和考卷面对的是同一个核心问题——评分器到底靠不靠谱。 而 Epoch 访谈里有一个细节特别关键:很多代码任务,能通过单元测试的解法有很多种,但只有一部分在工程设计上真正漂亮。「能跑」和「好」之间的差距,单元测试量不出来,只有懂行的人才判断得了。
过去几年,数据标注的形象是大规模、低单价、按条计费的体力活。2026 年这个行业已经换了一副面孔。
Mercor 的业务很直接:AI 实验室通过它雇佣各领域专家,去写难题、给模型答案打分、检查推理链。它把总收入的六到七成付给专家。另一个规模达到十亿美元级别的玩家 Handshake,原本是一个面向大学生和毕业生的求职网络。
这个细节值得多看一眼:专家数据赛道跑得最快的两家公司,起点都不是标注公司,而是人才网络。 Mercor 最早是 AI 招聘平台,Handshake 是校招平台。
-
做好一个任务,领域知识和高水平的 prompting 能力,比机器学习技能更重要
-
最擅长这件事的人,往往是那些做出过「真正被人用起来的 benchmark」的人
-
找到专家不难,难的是管理专家和做质量控制——怎么确认他们不是在用 LLM 糊弄,怎么确认他们的判断经得起验证
我们的判断: 专家标注的核心不是「找人干活」,而是「判断谁的判断值得信任」。这本质上是一个人才评估问题。谁的题出得好、谁的打分稳定、谁能发现别人发现不了的 reward hacking——这些都需要被持续记录、校准和排序。
「自进化(self-evolving)」是今年最热的词之一。TMLR 刚发表的一篇综述,把它拆成三个问题:进化什么(模型、记忆、工具、架构)、什么时候进化(任务中还是任务间)、怎么进化(标量奖励、文字反馈、多智能体协作)。
但也有人尖锐地指出,市面上很多号称「自进化」的 Agent,其实只是在不断往外部记忆里记笔记,模型权重并没有变化——是「穿了戏服的记忆」。
HKUST(广州)今年的一份博士资格考试综述也提出,评估自进化不能只看一次任务成绩,而要做纵向评估:适应能不能持续、学到的东西能不能保留和迁移。
这里藏着一个容易被忽略的问题:如果模型在进化,而评测它的考卷不进化,那么考卷很快就会变成上一章说的那张过期试卷。
所以我们理解的自进化,是一个闭环,而不只是模型的事:
-
-
-
用真实结果反过来校准题目和评分器——哪些题已经被刷穿、哪些评分被钻了空子、哪些专家的判断和最终结果最一致
-
模型、题库、评分器、出题人,四者一起进化。真正能自进化的不是某个模型,而是这一整套「出题—做题—校准」的系统。
Relia 的主业是 AI 人才招聘平台。我们每天面对的问题,和上面四节其实是同一个:怎么评价一份「作品」的好坏。
一篇论文、一个 GitHub 仓库、一个上线的 AI 产品——它们没有标准答案,没有单元测试,甚至「好」的标准本身就包含品味。这恰恰是今天 AI 评测里最难的那一类问题:开放式、长周期、需要专家判断。
-
作品评估 benchmark:基于 arXiv、GitHub 等公开作品,搭建一套评估「作品质量」而不是「考试分数」的基准,并用真实结果持续校准它
-
专家标注:邀请各领域的博士、研究员和工程师参与出题与评审,把他们的隐性判断变成可学习、可验证的信号
-
自进化记录:题怎么被刷穿、评分器怎么被钻空子、我们怎么修——包括失败的部分
-
研究手记:benchmark、RL 环境、专家数据领域的重要论文和行业动态,少复述,多判断
-
出题笔记:我们自己搭 benchmark 过程中的设计取舍、踩过的坑和数据
-
专家招募:我们正在进行的出题、评审与标注项目(见今日副条)
Relia|Where frontier AI teams meet researchers and builders.
Relia 是面向 AI 研究型人才的招聘平台,连接前沿 AI 团队和 AI 硕博研究者、builder,我们覆盖的方向:
AI4Science:药物发现、蛋白质、科学智能体
🙋 求职者:在 Relia 浏览前沿岗位,一键直投
🌐 https://www.relia.ai/(阅读原文)