

输入一段提示词,DuoMatching用4步甚至2步生成视频,画面里的毛发、釉面、独木舟和茶杯颜色不再丢。它没有另起炉灶,而是在现有DMD蒸馏上补了一条帧级监督通道,把一个现成的图像生成模型请回来当老师。
流式视频生成这两年靠分布匹配蒸馏(DMD)把几十步的扩散模型压到4步、2步甚至1步,CausVid、Self Forcing、Causal Forcing++这一条线已经把推理延迟压到接近实时。但代价一直没解决:整段视频的联合分布被匹配得越来越好,单帧的画质和语义对齐却始终差一截——毛发细节糊掉、提示词里写的独木舟没画出来。
港中文MMLab联合字节跳动推出DuoMatching,用一个统一的「联合+边际」分布匹配框架补上这块缺口:在原有joint DMD之外,新增一条边际(marginal)匹配目标,直接用冻结的Qwen-Image当帧级老师,把图像模型里的视觉与语义先验蒸馏进视频学生。为了让这条通道跑得通,团队还做了两个配套设计——1075万参数的LatentBridge解决视频latent与图像latent的空间不匹配,Latent Variation Sampling(LVS)把有限的帧级监督预算撒到时间轴上真正变化的位置。

效果是实打实的:在VBench上,2步因果生成拿到Total 83.53,比Causal Forcing++的80.67高出2.86;4步chunk生成83.51,同样领先Self Forcing的81.52和CausVid的80.19。23人参与的2AFC人类评测中,对全部四个基线的总体偏好率都超过80%。整个提升不增加任何推理开销,实时生成能力保留。
效果展示
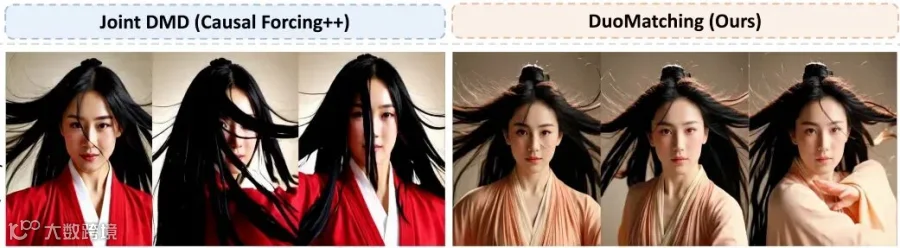
提示:一幅电影般的肖像,描绘了一位身着飘逸传统长袍的年轻女子,在温暖的米色背景前,做出优美的武术风格手臂动作。她乌黑的长发部分束于头顶,随着手臂的动作向外飘散,环绕着她的脸庞。宽松的袖子也随之摆动,形成柔和的褶皱和流畅的弧线。温暖的定向光线展现出她纤细的发丝、自然的面部细节和精致的布料纹理。近距离、稳定的构图突出了她专注的神情以及头发、双手和布料之间的互动。
提示:一个电影般的特写镜头,展现了一位笑容灿烂的小丑,他有着绿色的卷发、白色的脸部彩绘、绿色的眼妆,以及一个鲜红的笑容,站在色彩斑斓的城市街道上。小丑看向镜头,表情微妙变化,头部微微晃动,始终保持着灿烂的笑容。柔和的日光勾勒出他每一缕卷发、细小的皱纹、精致的妆容和服装细节。镜头稳定地聚焦在柔和虚化的彩色建筑上,营造出自然的景深和丰富的电影质感。

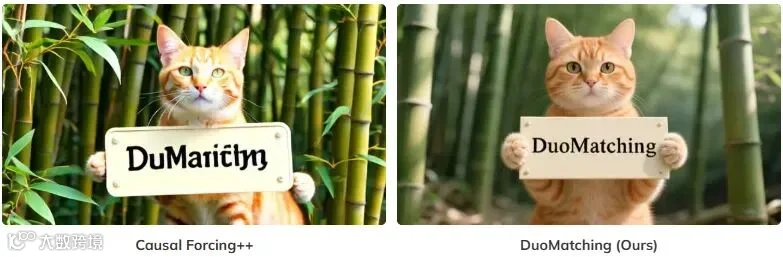
提示:一张逼真的中景照片,一只橘色虎斑猫在阳光普照的竹林中直立行走。猫咪有着金绿色的眼睛、竖立的耳朵、纹理清晰的条纹皮毛,头部、颈部和上胸部都清晰可见。它毛茸茸的两只小前爪自然地环绕着一块宽阔的米色长方形标牌的左右边缘,标牌被它托在下巴下方。标牌的四个角上用四个浅色的小扣子固定着。标牌上写着“ DuoMatching ”(双人配对)。猫咪先是看向镜头,然后轻轻地将头转向一侧,接着慢慢地低下头,耳朵也随之微微摆动。两只前爪始终稳稳地托着标牌。镜头缓慢地左右移动,逐渐将猫咪移至画面右侧。画面背景是高耸的绿色竹子、柔和模糊的树叶、温暖斑驳的日光和浅景深。
相关链接
-
论文:https://arxiv.org/abs/2610.03543 -
代码:https://github.com/JohnZhan2023/DuoMatching -
主页:https://johnzhan2023.github.io/DuoMatching/ -
模型权重:https://huggingface.co/JohnZhan/DuoMatching
内容介绍
一句话说:DuoMatching是一个蒸馏训练框架,不是一个新模型架构——它把「整段视频像不像真实视频」和「单帧像不像真实照片」两件事同时写进了损失函数。  图1:动机与结果。Causal CD初始化三项全崩;Causal Forcing++修好了时序质量,但视觉质量与语义对齐仍不合格;DuoMatching三项全过,Q-Align曲线显示帧级质量被整体抬升。 与常规DMD只做联合匹配不同,核心特点有三个:
-
帧级监督有了专人负责:边际匹配目标直接对齐图像生成器的分布,不再依赖「从整段视频的联合分布里间接推出单帧质量」这条弯路; -
老师是现成的:图像老师全程冻结,不需要额外训练一个图像专家,换更强的图像模型理论上能直接换更好的学生(论文消融验证了这一点); -
不牺牲实时性:所有增益都来自训练目标的变化,推理侧的计算量与Causal Forcing++完全一致。
适用场景:需要低延迟出片的直播与交互式应用、对提示词遵循度要求高的广告与短剧生成、想在消费级或单卡环境跑少步视频生成的工程团队。
图2:方法总览。(a)在联合匹配之外引入图像老师的边际匹配;(b)LatentBridge把视频latent映射到图像latent空间,用L1损失预训练;(c)LVS按latent变化强度分段,每段采一帧做帧级监督。
方法概述
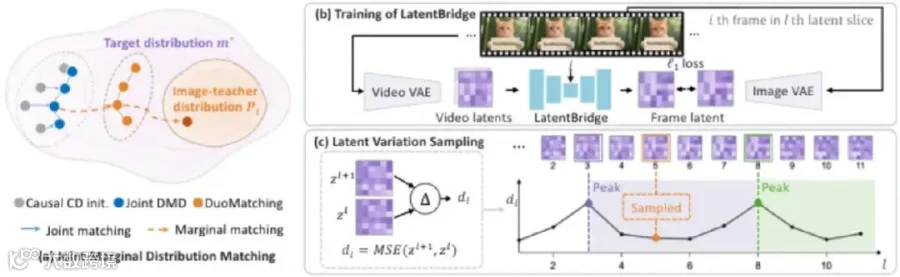
一套机制管帧级质量,一套机制管跨帧一致性,中间用一座桥把两个latent空间接起来。
1. 联合+边际双匹配(Joint-Marginal DMD)
现有DMD把真实视频分布P*替换成视频老师的分布Pv,然后匹配所有帧的联合分布。问题在于:联合匹配虽然也隐式约束了每帧的边际分布,但某一帧的单独改进如果和周围帧冲突,会被目标函数压回去——论文举的例子是给某一帧补上一根丢失的羽毛,这可能破坏与其他帧的一致性,于是改进不被采纳。DuoMatching在联合项之外加了一条边际项,总损失写成L_DuoMatching = L_joint-DMD + ω·L_marginal-DMD,默认ω=0.4。视频老师继续负责整段序列的联合分布,冻结的图像老师负责被采样帧的边际分布,两个老师各管各的。
2. 跨latent空间的桥(LatentBridge)
要让图像老师看懂视频学生的输出,得先解决一个空间问题:视频VAE做了时间压缩,一个video latent对应多帧RGB,而图像latent一帧一个;两套VAE的latent空间也未必兼容。最直接的办法是把视频latent解码成RGB再用图像VAE编码回去,但梯度要穿过两个VAE,显存直接爆掉(论文实测Decode-Encode方案OOM)。LatentBridge是一个1075万参数的可微模块,由8个FiLM残差块、256隐藏通道构成,输入视频latent切片、前一个切片和帧序号,直接输出该帧在图像老师latent空间的表示。它在29400段高美学、大运动量的OpenVid视频上用L1重建损失预训练,3000次迭代、8张80GB显卡约15分钟。消融显示这一步是关键:不用它而直接做边际匹配,Dynamic degree从94.44崩到76.94;用它则回到93.61,同时Total从81.78提到83.53。
 图3:LatentBridge跨潜空间重建效果。Wan视频latent经LatentBridge映射后,在Qwen-Image、FLUX、SDXL三套图像latent空间里的重建结果(下排)与目标(上排)几乎一致。
3. 监督预算怎么撒(Latent Variation Sampling)
帧级监督是有预算的——每个视频默认只采K=4个latent切片。如果随机采,采样点容易扎在画面几乎静止的段落,产生冗余监督,还会因为过度强调静态内容而压制运动。LVS的做法是先算相邻latent切片之间的均方误差,找出变化最剧烈的位置把序列切成K段,再从每段里均匀随机采一片。消融显示LVS在K=2/4/8三种设置下全面优于均匀随机采样,K=4时Total 83.53对82.61;K加到8反而让Dynamic和Total双双下滑,说明监督预算不是越多越好。
实验结果
VBench自动评测
实验设置:因果模型从Causal Forcing++的一致性蒸馏检查点初始化,在VidProM上做1000步DMD;双向模型从Wan2.1-T2V-1.3B初始化,在Mixkit上做1200步DMD;图像老师默认为冻结的Qwen-Image;输出81帧、480×832;训练用8张80GB显卡。
|
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
DuoMatching | 72.84 | 73.48 |
|
|
83.53 |
|
|
|
|
|
|
|
|
|
|
|
|
DuoMatching |
|
|
|
|
82.65 |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
DuoMatching |
|
|
|
|
83.51 |
|
|
|
|
|
|
|
|
|
|
|
|
DuoMatching |
|
|
|
|
81.45 |
提升最集中的是Semantic和Imaging两列:2步因果设置下Semantic从68.42提到72.84(+4.42),Imaging从69.82提到73.48(+3.66)。Dynamic一列基本持平(94.44对93.61),说明帧级监督没有把运动压没。
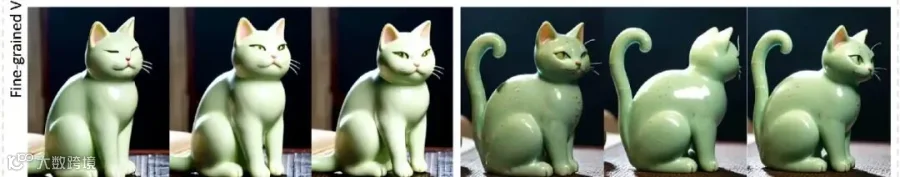 图4:细粒度视觉质量对比。左侧三帧为Causal Forcing++,右侧三帧为DuoMatching,注意瓷猫釉面的斑点纹理与尾巴卷曲细节的差异。
人类评测
23名参与者,每人评估40对提示词匹配的视频,2AFC协议,报告偏好DuoMatching的比例:
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
必须说清楚的一点:对Causal Forcing++的时序与运动偏好率是49.57%,低于50%——这一项其实是略输的。DuoMatching赢在视觉质量(81.30%–93.48%)和语义对齐(79.57%–91.74%),运动维度只是「基本持平」,论文自己的表述也是near or above parity。
 图5:语义对齐对比。上排提示词要求「一只独木舟」,Causal Forcing++(左三帧)没画出来,DuoMatching(右三帧)画了;下排要求「青瓷色茶杯」与「青瓷色盘子」,同样是左边缺、右边齐。
消融:图像老师越强,学生越强
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
83.53 |
两个值得注意的信号:一是连视频老师自己(Wan2.1-14B)当图像老师都能涨分(80.67到81.43),说明涨分不只靠「引入新先验」,边际匹配这个形式本身就有价值;二是老师的HPSv3分数和学生的Semantic/Imaging几乎单调对应,图像侧的进步可以直接兑换成视频侧的进步,而Dynamic与Smoothness在各档老师之间基本不动——时空解耦是成立的。
局限与未来方向
首先,训练门槛没有降。论文全部实验在8张80GB显卡上完成,开启LatentBridge后单次训练迭代的峰值显存为59.41GB(基线56.49GB)。发布的2步学生模型虽然推理侧只需5.68GB权重文件加Wan2.1-T2V-1.3B组件,但复现训练需要同时部署Wan2.1-T2V-14B与Qwen-Image两个大模型当老师。
其次,LatentBridge是按图像老师的latent空间单独预训练的。换一个图像老师,理论上要重训一座桥——好在单次只要15分钟,但这条依赖链意味着「即插即用换老师」并不完全成立。论文也只验证了Qwen-Image这一默认档位的完整流程。
此外,输出规格固定在480×832、81帧,论文没有给出更高分辨率的实验;官方发布的演示脚本默认生成21帧。发布的checkpoint是2步档位,对应Table 1中Frame/2-step那一行(Total 83.53),训练配置里的真实分数教师是Wan2.1-T2V-14B——与论文正文的初始化描述并不完全一致,复现时以仓库配置为准。
最后,论文没有独立的Limitations小节,运动维度的短板需要从人类评测表里自己读出来;400条测试提示词是团队自建的,未公开与其他工作对齐的口径。
结论
DuoMatching验证了一件事:少步视频生成的画质瓶颈,不一定要靠更大的模型或更多的推理步数来解决,把「帧级质量」从整段视频的联合分布里拆出来单独监督,就能把丢掉的细节找回来。
对于做直播、交互式生成的工程团队,这个框架值得跟——增益不增加推理开销,官方仓库给出完整的训练与推理脚本,权重5.68GB可以直接落地测试;对于研究蒸馏和分布匹配的人,论文附录里关于联合与边际匹配关系的两条证明(Appendix C/D)和图像老师消融是比主表更有价值的部分。蒸馏这条路上,大家都在想怎么让视频学生学得更像视频老师,这篇工作的答案是把另一位老师请进教室。
感谢你看到这里,添加小助手 AIGC_Tech 加入官方 AIGC读者交流群,下方扫码加入 AIGC Studio 星球,获取前沿AI应用、AIGC实践教程、大厂面试经验、AI学习路线以及IT类入门到精通学习资料等,欢迎一起交流学习💗~
