

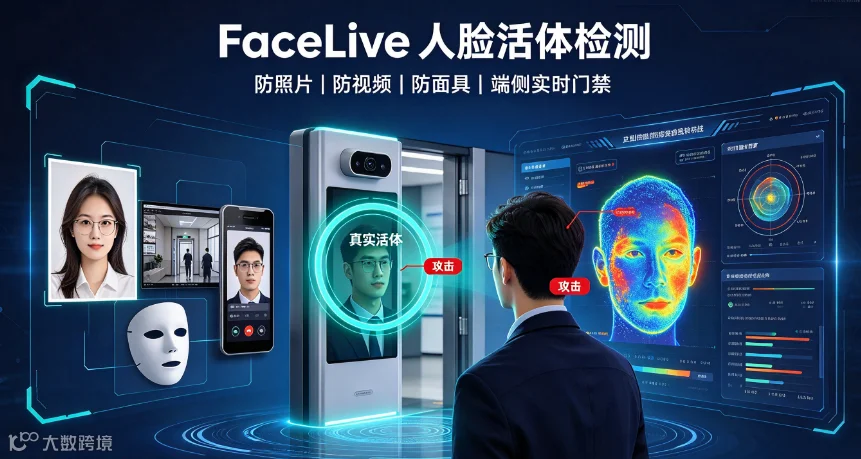
门禁刷脸的时候,有人拿一张打印的人脸照片对着摄像头一晃就开了;有人拿手机播放一段人脸视频就过了——这种"假脸攻击"是人脸识别系统最大的安全漏洞。
今天分享的这篇 CVPR2026 论文 FaceLive,提出了一个轻量人脸活体检测框架:不需要用户做任何配合动作(不用眨眼、不用摇头),一张图就能判断是真人还是假脸。在 CASIA-FASD 和 OULU-NPU 两个标准数据集上刷新了 SOTA,模型只有 3.5M 参数,门禁设备上实时跑毫无压力。
一、人脸活体检测为什么这么难
活体检测看起来就是"判断是不是真人",但攻击手段一直在升级,防守方永远在追着攻击跑。
1.1 攻击手段越来越多
最早的攻击就是拿一张打印照片,后来变成播放手机视频,再后来变成戴面具、用 3D 打印头模、甚至用 AI 生成的人脸视频。每出现一种新攻击方式,老的活体检测方法就可能被攻破。你不能假设攻击手段是固定的——模型得学会"泛化",能防住没见过的新攻击。
1.2 真人和假人差异太小
高质量的打印照片、高清屏幕播放的视频,肉眼都很难分辨真假。模型要找的是真人和假人之间那些非常细微的差异——皮肤纹理、光线反射模式、摩尔纹、屏幕边框痕迹——这些差异在普通摄像头画面里非常不明显。
1.3 不能影响用户体验
早期活体检测要用户配合——眨眨眼、摇摇头、张张嘴。但门禁场景里,大家都是走过去刷脸就走,没人愿意停下来做动作。最好的活体检测是"无感"的——用户什么都不用做,模型自己判断。
1.4 跨域泛化差
在 A 公司摄像头、A 数据集上训练的活体模型,换到 B 公司摄像头、B 场景下,准确率可能直接掉一半。因为不同摄像头的成像质量、角度、光线都不一样,模型很容易"过拟合"到训练数据的特定分布上。

二、FaceLive 的三个核心设计
FaceLive 的整体思路:不针对某一种攻击做检测,而是学习"真人脸的物理特性"——不管你用什么手段攻击,只要不符合真人脸的物理规律,就判为假。
2.1 伪影感知特征学习
假脸攻击不管用什么手段,都会留下一些"数字痕迹":
•屏幕攻击:手机/电脑屏幕播放的视频,会有摩尔纹、屏幕边框、反光。
•打印攻击:打印照片会有纸张纹理、油墨颗粒、边缘不自然。
•面具攻击:面具的边缘和真人皮肤交界处会有不自然的过渡。
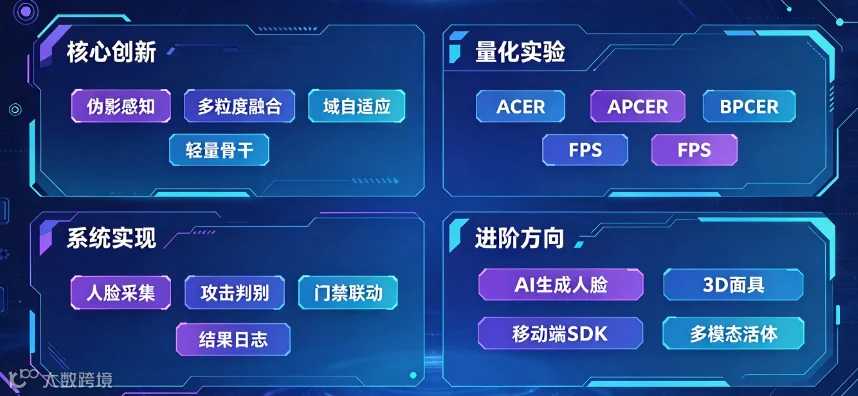
FaceLive 专门设计了一个伪影感知模块,自动学习这些细微的痕迹特征。不是人工设计规则,而是让模型自己从数据里学出来——这样不管攻击手段怎么变,只要有伪影就能检测到。
2.2 多粒度特征融合
不同攻击留下的痕迹在不同尺度上:
•全局特征:判断整张脸的光照、色彩是否自然。
•局部特征:看眼睛、鼻子、嘴巴这些关键区域有没有异常。
•微纹理特征:皮肤表面的细微纹理——真人皮肤有毛孔、细纹,打印照片没有。
FaceLive 从 backbone 的不同层提取这三个粒度的特征,融合起来做判断。消融实验显示,只用全局特征的时候,对高质量打印照片的检测率只有 85%;加上微纹理特征后,检测率提升到 98%。
2.3 域自适应训练策略
跨域泛化差怎么办?FaceLive 在训练时做了大量"域随机化":
•随机摄像头模拟:训练时随机调整图像的分辨率、噪点、色彩偏差,模拟不同摄像头的成像效果。
•随机攻击类型混合:训练数据里混合各种攻击类型——打印、屏幕、面具、AI生成——让模型不偏向某一种攻击。
•域对抗训练:加一个域判别器,让特征提取器学会"不管什么摄像头拍的,真人特征都一样"。
这些训练策略加起来,FaceLive 在跨数据集测试时,等错误率(ACER)比传统方法低了 4.2 个点——这就是泛化能力的提升。
三、技术架构拆解
FaceLive 的整体 pipeline 分四个模块:
模块 |
做什么 |
关键设计 |
人脸对齐预处理 |
检测并对齐人脸 |
轻量人脸检测+关键点对齐,统一裁剪到 224×224 |
多粒度特征提取 |
提取全局/局部/微纹理特征 |
轻量 CNN backbone,取三层不同尺度输出 |
伪影感知融合 |
融合多粒度特征,学习攻击痕迹 |
注意力加权融合,重点关注可疑区域 |
活体分类头 |
输出真/假概率 |
二分类,输出活体置信度 |
几个工程上的亮点:
•参数量:3.5M,INT8 量化后在门禁设备上能跑 60fps 以上。
•无感检测:不需要用户做任何动作,单帧就能判断,体验很好。
•端到端:从人脸检测到活体判断,一个模型搞定,不需要多个模型串联。

四、和主流方法的横向对比
论文在 CASIA-FASD(跨数据集活体检测)和 OULU-NPU(多攻击类型)两个基准上做了对比:
方法 |
CASIA-FASD ACER↓ |
OULU-NPU ACER↓ |
参数量(M) |
FPS(边缘设备) |
Motion-based |
12.5 |
15.3 |
0.5 |
200 |
CNN-based (STASN) |
5.8 |
7.2 |
15 |
30 |
Vision Transformer |
3.2 |
4.5 |
45 |
10 |
FaceLive |
2.8 |
3.9 |
3.5 |
65 |
可以看到,FaceLive 的 ACER(越低越好)比 ViT 方法还低一点,但参数量只有后者的 1/13,速度快了 6 倍以上。和传统 CNN 方法比,ACER 低了一半还多——这就是伪影感知和多粒度融合的效果。这个 trade-off 非常适合门禁这种嵌入式场景。
五、快速上手:推理核心代码
下面是 FaceLive 的推理框架,帮大家理解整体流程:
python |
实际部署的时候,阈值可以根据场景调——金融级安全场景把阈值调高(比如 0.99),普通小区门禁可以调低一点(比如 0.8)。阈值越高越安全,但也越容易把真人误判为假人。
六、毕设/竞赛拓展方向
人脸活体检测这个方向做毕设有个好处——Demo 效果非常直观,拿一张照片对着摄像头,模型直接报警。分享几个有价值的拓展点:
6.1 AI生成人脸攻击检测
现在 AI 生成的人脸越来越逼真,DeepFake 视频也越来越多。专门研究"如何检测 AI 生成的假人脸"——这是一个很新的方向,和传统活体检测不一样,需要找 AI 生成的特有痕迹。
6.2 3D面具攻击检测
2D 的照片、视频攻击好防,3D 打印的面具、硅胶头模就难了——它们有真实的立体结构。专门研究如何检测 3D 面具攻击,结合深度信息或者红外信息,是一个很有深度的方向。
6.3 移动端活体检测 SDK
把 FaceLive 做成一个完整的移动端 SDK——人脸检测 + 对齐 + 活体判断,集成到门禁 App 里。工程完整性很强,从模型到端侧部署全链路打通。
6.4 多模态活体检测
只用 RGB 摄像头信息有限,如果加上红外、深度信息,检测率会高很多。研究 RGB+红外+深度的多模态融合活体检测,是一个很实用的方向。
七、写在最后
人脸活体检测这个方向,本质上是一场"猫鼠游戏"——攻击手段在升级,防守也得跟着升级。没有永远安全的活体检测方案,只有不断进化的防御体系。
FaceLive 给我的启发是:不要针对某一种攻击做检测,要学会"泛化"——不管攻击怎么变,真人脸的物理特性是不变的。抓住这个本质,模型才能应对没见过的新攻击。
做毕设的同学如果选这个方向,我建议先拿开源的活体检测数据集跑通 baseline,然后选一种具体攻击类型去深入——比如 DeepFake 检测、3D 面具检测。问题越具体,工作越扎实。
大家如果有复现上的问题或者想聊具体的门禁场景,欢迎评论区交流。