

一个由 AI 智能体参与设计、从 Python 内核一路走到 ASIC 的开放加速器栈。
目录
1. 设计定位与机器模型 🧠
2. ISA:指令总览 ⚙️
2.1 计算类
2.2 量化类
2.3 搬运类
2.4 控制类
2.5 同步类
3. 编译器与 ol 语言 🐍
3.1 五种 layout
3.2 layout 转换指令
3.3 dot 的语义
3.4 fusion peephole ✨
3.5 硬件循环与地址寄存器分配 🔁
3.6 TMEM 分配
4. 存储层次与数据移动 🗄️
4.1 TMEM 🧠
4.2 DRAM 与适配器 🚚
4.3 量化格式 🎚️
4.4 数据移动的层级与瓶颈 🔍
4.5 KV cache 的组织 📦
5. MXU 与数值 🔢
6. VPU 与流引擎 ➗
7. 模型映射 🧠
Qwen3 / Llama 类 📘
LFM2 🌊
Qwen3.5 🌀
Gemma 4 💎
MoE 🧩
8. 卡上性能 ⚡
9. 目标描述与后端架构 🎯
9.1 四层目标描述
9.2 语义契约的三方实现
9.3 三种后端
9.4 主机驱动与 DMA 细节
9.5 主机工具链
10. FPGA 板级 🛠️
YPCB-00338 🟢
BCU1525 🔵
11. ASIC 流程 🏭
设计点
11.1 nangate45-small 参考 🥇
11.2 宏放置迭代 🧱
11.3 SW_REG 🛡️
11.4 OpenLayout 🗺️
11.5 TMEM 按读者放置 🧭
12. 验证与工具 🔬
12.1 三方比对
12.2 可观测性
12.3 主机 DMA 与主机软件
13. 风险与开放项 ⚠️
13.1 硬件路径
13.2 板级与主机
13.3 软件与流程
1. 设计定位与机器模型 🧠
openTPU 是单指令流、多单元的 AI 加速器:一个 sequencer 每周期发一条 8×32-bit 指令,五类单元执行。每个 slice 有私有 DRAM、TMEM、ACT RAM、IMEM 与 16×32-bit 寄存器堆;slice 间只通过 collective 通信。

图解读:
-
• sequencer 每周期发一条 8×32-bit 指令 -
• 五类单元:DMA、MXU、VPU、Quantizer、Collective -
• 每个 slice 私有 DRAM、TMEM、ACT RAM、IMEM -
• 每个 slice 有 16×32-bit 寄存器堆 -
• slice 间只通过 collective 通信 -
• MXU 从 DRAM 流式读权重,读 ACT RAM,写 TMEM -
• VPU 与 TMEM 双向读写 -
• Quantizer 读 TMEM,写 ACT RAM 与 DRAM 的 KV -
• DMA 在 DRAM 与 TMEM 之间搬运
关键参数:
-
• D:MXU 深度 = 量化块大小,设计 128 -
• 测试常用 32 -
• MCOLS:MXU 列数,卡上 4 -
• LANES:VPU lane 与 TMEM bank 数,8 -
• PAIR:4-bit 列复用开关 -
• DSTEP:DMA 状态步进开关 -
• STREAM:流引擎开关
📐 语义契约由
compiler.py、isasim.py、rtl/三方维护:模拟器是规范,RTL 必须逐位一致。
没有 cache,没有隐藏调度:每次数据移动都是显式指令,所以 trace 能逐周期解释性能。
2. ISA:指令总览 ⚙️
每条指令固定 8 个 32-bit 字:w0 是控制字,包含 opcode、寄存器号与 flags;w1~w7 按 opcode 解释为地址、形状、步长或立即数。
💡 设计哲学:没有隐式数据移动。每次搬数据、换 layout、量化,都是一条指令。
2.1 计算类
-
• MM:矩阵乘核心 -
• 从 DRAM 流式读权重 -
• 乘 ACT RAM 里的 int8 激活 -
• 精确整数累加 -
• K 全部加完才做一次 fp32 epilogue -
• ACC累加 -
• ASCALE按行缩放累加器 -
• RMAX行最大值折进 epilogue -
• PAIR4-bit 列复用,吞吐翻倍 -
• VOP:向量运算 -
• 逐元素: ADD/SUB/MUL/MAX/MIN/ABS/COPY/FILL -
• 归约: RSUM/RSSQ/RDOT/RMAX/ARGMAX -
• 复合: EXP2/EXP2SUB/RECIP/RSQRT/LOG2 -
• 秩一: OUTER -
• B 操作数广播:FULL / ROW / COL / SCALAR -
• DSTEP:线性递推状态步进 -
• DeltaNet / Mamba2 / GLA / RetNet -
• 状态在 DRAM 原地更新 -
• 状态不进入 TMEM -
• STREAM:流引擎泛化 -
• descriptor 编程 A / SCALAR / U / Q 四阶段 -
• 覆盖整个线性递推家族
2.2 量化类
-
• QACT:TMEM fp32 → ACT RAM int8 -
• 每行一个 scale -
• 每 D/4 子块一个二进制偏移 -
• CSCALE把列 scale 折进量化 -
• RSCALE把行 scale 折进量化 -
• DUP是 PAIR 的伴侣 -
• QST:TMEM fp32 → DRAM int8 -
• 用于 KV cache 写入 -
• K 是 token-major -
• V^T 是 dim-major -
• es元素步长统一两种布局 -
• HALF只写前半行
2.3 搬运类
-
• LD:DRAM 到 TMEM -
• DMA 内部按 burst 打包 -
• 每周期搬 D/4 或 LANES 个 word -
• ST:TMEM 到 DRAM -
• 与 LD对称 -
• 用于结果写回
2.4 控制类
-
• RLD:设备值进入地址/计数 -
• f2i截断 -
• RAW取原始位 -
• MUL乘寄存器值 -
• BOUND限制范围 -
• WAITW:等主机写 DRAM -
• 按 mask 截取 -
• 比较 EQ / NE / GE -
• 轮询间隔可设 -
• 超时报错 -
• HALT CHAIN:软重启 -
• 停机后加载新程序 -
• TMEM、DRAM、参数保留
2.5 同步类
-
• BAR:slice 间屏障 -
• GATHER:slice 间全收集 -
• WAITC:编译期依赖 -
• 每条指令带 64-bit wait entry -
• 7 个 4-bit count -
• 1 个 31-bit mask -
• 省 53% sequencer LUT
💡 一句话总结:MM 做乘法,QACT/QST 做量化,VOP 做其余数学,LD/ST 搬数据,RLD/WAITW/HALT CHAIN 控制流,DSTEP/STREAM 做递推。
3. 编译器与ol语言 🐍
ol 是 Triton/Gluon 风格的 kernel 语言,layout 是显式的。程序员写的是“数据在哪个存储层级、什么形状、什么步长”,不是“做什么数学”。
3.1 五种 layout
-
• Tensor:DRAM fp32 -
• 行主序 -
• 带行步长 -
• 最普通的输入输出 -
• QTensor:DRAM 量化行 -
• 每行一个 scale 行 -
• 权重与 KV cache 的形态 -
• parts存成列切片 -
• 每片连续行与 scale 行 -
• Tile:TMEM fp32 -
• base / shape / row stride -
• 中间结果的暂存 -
• Stationary:ACT RAM int8 行 -
• 每行 scale -
• 每 D/4 子块偏移 -
• qranges记录 QACT 写了哪些块 -
• dot()每个 range 发一个 MM -
• Bcast:1-D tile 的列/行视图 -
• 广播操作的视图 -
• 不占额外存储
💡 layout 转换即数据移动:换 layout 不是隐式的,每次都要写一条指令。
3.2 layout 转换指令
-
• ol.load(t)→LD -
• ol.store(t, x)→ST -
• ol.quantize(x)→QACT -
• ol.dot(a, w)→MM -
• ol.kv_append(kv, ...)→ 两条QST
3.3 dot 的语义
dot(a[M,K], w[N,K]) 计算
。
-
• out=:复用已有 tile -
• rowmax=True:映射到RMAX -
• acc=:映射到ACC -
• acc_scale=:映射到ASCALE -
• 自动改写: ol.max(dot(...), axis=1)改写为rowmax
stationary 的 qranges:多个 QACT range 时,
dot发多个MM。第一个正常,其余ACC,最后一个RMAX。
3.4 fusion peephole ✨
只对未命名临时量生效。命名中间量不会被改写,避免语义漂移。编译器用引用计数判断临时量,并处理 Python 3.14 的借用引用。
-
• → EXP2SUB -
• → QACT CSCALE -
• → RSSQ -
• → RDOT -
• → RMAX
💡 每个 peephole 合并 2-3 条指令。主要收益是减少 TMEM 往返,不是减少指令数。
3.5 硬件循环与地址寄存器分配 🔁
ol.range(n) 发射一条 LOOP,body 追踪一次。地址表达式被表示为 Affine:常量、循环变量线性项、运行期变量项。
-
• 地址仿射: 被识别为 Affine -
• 寄存器池: spare_regs、free_regs、used_regs -
• 释放检查: _free_for()检查哪些循环还活着 -
• 循环步进:body 末尾 ADDI -
• 循环复位:结束清零,可复用 -
• 运行期变量: RunVar占参数寄存器 -
• 设备变量: DevVar用 RLD 的MUL -
• 计数器: Counter用于 LFM2 层间偏移
⚠️ 释放的寄存器有使用限制:不能用于仍在活跃的循环地址;不能用于以运行期值为初值的地址,除非 body 头部清零。
3.6 TMEM 分配
-
• next-fit:从移动游标分配 -
• 连续临时量分散到不同 bank -
• 避免 scoreboard 假冲突 -
• best-fit:next-fit 放不下时回退 -
• trace_fit()捕获"TMEM exhausted"后重试 -
• 探测性编译:prefill rows、prompt run、generate bucket 保留 next-fit 结果 -
• ACT RAM block: Stationary死亡时释放,round-robin 复用
💡 核心是避免假冲突:两个临时量落在同一 bank,scoreboard 会认为有依赖,白白插入等待。
4. 存储层次与数据移动 🗄️
4.1 TMEM 🧠
TMEM 是 32-bit 字寻址的 fp32 存储,LANES 个 bank。bank = 地址 mod 8/16,每个 bank 一个读口/周期。
-
• 读端口:MXU、DMA、QUANT、VPU A/B、QUANT 2/3、COLL -
• 写端口:DMA、MXU、COLL、VPU
三种实现:
-
• FPGA 6 副本:384 RAMB36,占卡块 RAM 64% -
• ASIC 3 副本:1R1W 宏 -
• 单副本: TMEM_IMPL 3,冲突后重放 -
• 单副本省到 64 RAMB36 -
• 代价是重放仲裁逻辑
单副本前提:重放 word 在等待窗口内不得被写。reading unit 被冻结,其他单元的写由 hazard 逻辑排序。仿真违反时
$fatal。代价:FPGA 周期 +0.70%,最差 +1.66%;ASIC 形式 +2.75% 周期,25-42% 额外读。
重放机制:一次读的 word 到达端口后,如果同一周期另一个端口也读同一 bank,输的那个把端口、bank、行、lane 存进寄存器,下一周期重发。代价是一次多余读,收益是省去 5 份 SRAM 副本。
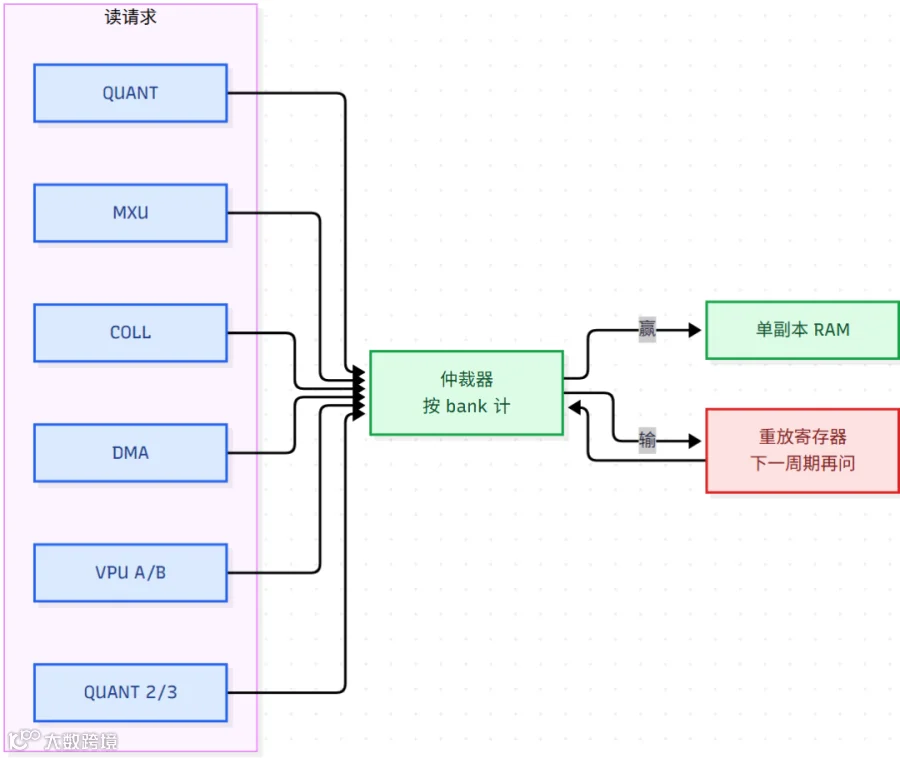
图解读:
-
• 左侧是六个读请求源:MXU、DMA、QUANT、VPU A/B、QUANT 2/3、COLL -
• 中间是按 bank 计的仲裁器 -
• 赢的请求访问单副本 RAM -
• 输的请求进入重放寄存器 -
• 重放寄存器下一周期再问仲裁器 -
• 代价是一次多余读 -
• 收益是省去 5 份 SRAM 副本
4.2 DRAM 与适配器 🚚
YPCB 的 DRAM 是两条 DDR3-1066 通道,2×2 GiB。通过 LiteDRAM 控制器,每通道两个 native 用户端口。按 beat 地址 bit 7 即 bank 奇偶分裂,使能 +6~13% 解码。
-
• Qwen3 4-bit:-12.5% -
• LFM2:-8.2% -
• Qwen3.5:-6.7%
逻辑地址按 64-byte beat 交错到两通道。CHASH(CAPS bit7)按 chunk 奇偶翻转:
-
• 是 chunk 内的 beat 号,0 或 1 -
• 是 chunk 号 -
• 是其二进制 1 的个数的奇偶 -
• 偶数 chunk 按自然顺序 -
• 奇数 chunk 交换两通道 -
• 目的:让幂次步长的列分散到两通道
适配器的三类请求:
-
• port A:MXU scale 读、APF 32-beat run -
• port B:LD/ST/MM 权重流 -
• port B 有 RD 128 beat FIFO -
• port B 采用预留制 -
• SW:QST gather,WQD 32
⚠️ 主机大写在 run 中 ≤4 KiB/通道,H2C overrun 规则。主机写与 C2H 读不重叠,DMA lock。违反时 XDMA 内部会错位 8 KiB,且引擎卡死到重载 bitstream。
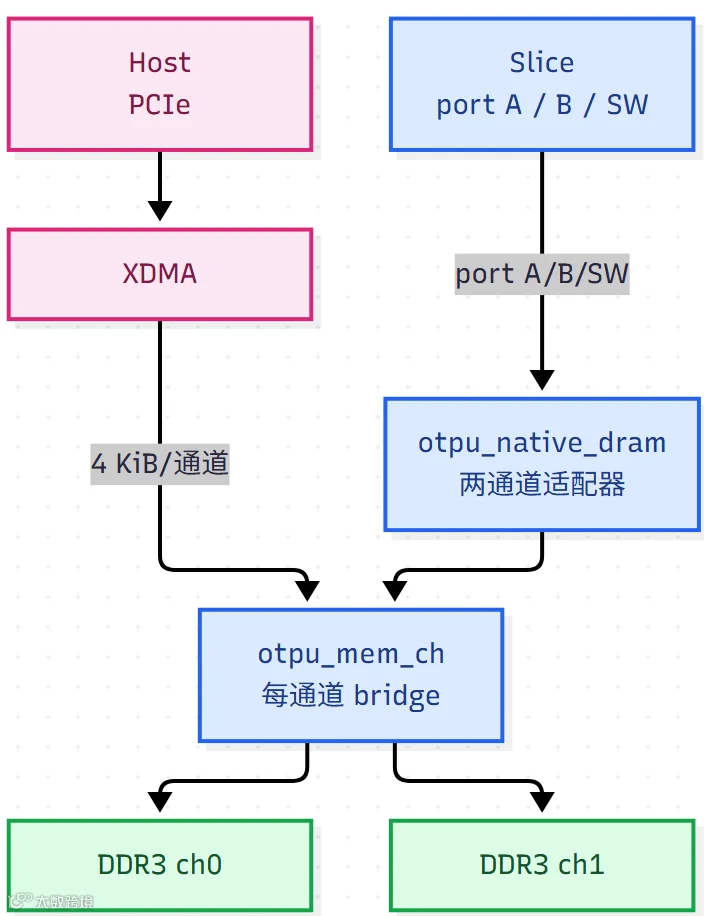
图解读:
-
• Host 经 PCIe 接 XDMA -
• XDMA 每通道最多 4 KiB 写入 bridge -
• otpu_mem_ch 是每通道 bridge -
• otpu_native_dram 是两通道适配器 -
• Slice 有 port A / B / SW 三类请求 -
• bridge 分别接 DDR3 ch0 与 ch1 -
• 主机大写在 run 中受 4 KiB 限制 -
• 主机写与 C2H 读不重叠
4.3 量化格式 🎚️
-
• int8x:8.06 bits/weight -
• int8 -
• -
• 每 D-block 一个 字节 -
• fp4x6:4.25 bits/weight -
• E2M1 -
• -
• 每 block 一个 word -
• word 含 与四个 6-bit -
• nvfp4:4.5 bits/weight -
• E2M1 -
• -
• 每 D/8 一个 E4M3
💥 V^T append 每字节一个 64-byte beat 的读-改-写。Qwen3-0.6B 占 token 写的 73%,周期的 1.05-1.37%。原因是 V^T 的列是 token,行是维度,append 一 token 就是每行写一个字节,跨 128 个 beat。
4.4 数据移动的层级与瓶颈 🔍
按每 token 字节数排序:
-
• 权重:decode 时每 token 流式读全部权重 -
• Qwen3-0.6B int8 约 576 MB -
• Qwen3-0.6B fp4 约 300 MB -
• 占 DRAM 字节的 80-95% -
• KV cache:随 context 线性增长 -
• Qwen3-0.6B 每 token 每层 8 KV head -
• 每 head 128 维 -
• 每维 2 字节 -
• K 与 V 各一份 -
• 激活:TMEM 往返 + ACT RAM 读写 -
• decode 占总字节 2-11% -
• prefill 占 17-29% -
• KV append:V^T 的读-改-写 -
• Qwen3-0.6B 每 token 3.76 MB 读写 -
• 为 28 KB 的 V 服务
ACT RAM 门控:act_ren[j] = p_act && pop_e.cm[j]。decode 只读实际用到的列,不读 MCOLS 列全量。效果:decode 读 1 行而非 4 行。
TMEM 往返:MXU 写 → VPU 读 → VPU 写 → QACT 读。每次 VOP 都是一次 TMEM 读 + 一次 TMEM 写。
4.5 KV cache 的组织 📦
-
• K 行:token-major -
• 每 token 一个 fp32 scale -
• 或 int8 scale 行 -
• 标记为 RSC -
• V^T:dim-major -
• 按 256-token tile 存储 -
• P.V 一次连续流式读 32 KB -
• scale:K 的 scale 跟 token 走 -
• V 的 scale 折叠进 P 的 CSCALE
append 的开销:K 追加是一行连续写;V^T 追加是每维度一个字节,每字节一次 64-byte beat 的读-改-写。
5. MXU 与数值 🔢
MX 列:每个输出在列末 DSP 中精确整数累加。块 scale 作为 2 的幂移位。整个 K 累加完才做一次 fp32 epilogue。
E 条共享 lane:
-
• E = MCOLS/2:无代价 -
• E = MCOLS/4:需编译器 chunk 规则
✅
fp4x6精度与今天 fp4 相当或更好。OCP MXFP4 差 6-8 个点,不用。
面积:Vivado OOC,只对该模块单独综合与布局布线,隔离外围逻辑影响。LUT 为查找表,FF 为触发器,DSP 为乘法硬核。
-
• MCOLS 4:LUT -31% -
• MCOLS 4:FF -42% -
• MCOLS 4:DSP -264 -
• MCOLS 8:LUT -35% -
• MCOLS 8:FF -47% -
• MCOLS 8:DSP -528
从 4 到 8 行只增加 +2.2K LUT、+1.8K FF。旧设计是 +12.0K/+14.2K。

图解读:
-
• MX 阵列分 PE 链与列末 DSP -
• PE 链每级做 16 个乘法 -
• 列末 DSP 做 8 个移位乘加 1 个累加 -
• 权重流与 ACT RAM 一起进入 PE 链 -
• 列末 DSP 输出 48-bit 整数 -
• E 条 lane 做 i2f48、乘 Sw、乘 Sa' -
• 整数累加精确,浮点只在 epilogue
6. VPU 与流引擎 ➗
8 lane fp32,含以下子单元:
-
• slot 0 fmma:每 lane 一个融合乘加槽 -
• vtree:跨 lane 归约树 -
• vtree 服务 RSUM/RSSQ/RDOT -
• se_tail:流引擎收尾阶段 -
• se_comp:流引擎复合阶段
面积:30.8K LUT、27.4K FF、86 DSP。DSTEP 占 61% LUT。流引擎的状态步进逻辑是 VPU 面积的主要来源,不是逐元素运算本身。
速率:
-
• elementwise:8 word/cycle -
• composite:2.67/4/2 word/cycle -
• composite 按固定 add/mul 序列长度 -
• DSTEP:8 state word/cycle -
• 复合函数越“长”,每周期吞吐越低 -
• 序列固定,周期数编译期可静态计算
🧪 pumping:让单元跑双倍时钟。单元本身 bit-exact,但整个 VPU 在 3.75 ns 下 -1.394 ns,不采用。时序余量不足以支撑双倍时钟,强行泵送会让整个设计点降频。
结论:YPCB 不建 2x VPU。杠杆是 16-word DSTEP datapath。把每周期状态字数从 8 提到 16,而不是复制整个 VPU 或跑双倍时钟。这样线性递推的瓶颈从“喂不饱 datapath”变成真正的 DRAM 带宽。
7. 模型映射 🧠
Qwen3 / Llama 类 📘
-
• NoPE 层用 rope gate -
• 一个硬件循环覆盖所有层 -
• 层间差异只在循环计数初值 -
• 不需要展开 -
• int8 embedding 从 tied int8 LM head gather -
• embedding 与 LM head 共享量化权重 -
• 省一份 DRAM 副本
LFM2 🌊
-
• 短卷积:3 taps -
• GQA:16 q / 8 kv -
• 卷积状态是 3-slot ring 的镜像 -
• 三个 tap 在一个循环里滑动 -
• 不需要额外状态拷贝
Qwen3.5 🌀
-
• 24 层 (DeltaNet ×3, attention) -
• 状态 1 MiB/层 -
• 3 个 VPU pass -
• RDOT:算 kv -
• OUTER:更新状态 -
• LOG2:算门控 -
• 每个 pass 是一条 VOP 序列,不是一条指令
Gemma 4 💎
-
• 35 层 -
• sliding/global 交替 -
• KV sharing -
• global 层复用 sliding 层 KV -
• 减少 append 字节 -
• PLE 表 -
• E4B 的表留主机 -
• 表太大,放主机侧 -
• 设备按行 WAITW拉取
MoE 🧩
-
• 卡路由、查目录、 WAITW等缺失专家 -
• 目录查表在卡上完成 -
• 只有缺失专家才触发主机 DMA -
• 专家主序 prefill -
• 35B:-1.91 s -
• 26B:-1.78 s -
• 按专家分组处理 token -
• 减少专家切换的权重重复流式读

图解读:
-
• Card 先做 router MM 与 ARGMAX -
• Card 在卡上查目录 -
• 专家在场时卡上直接计算 -
• 专家缺失时卡用 WAITW 等目录 -
• Host 收到请求后向 DRAM DMA 专家 -
• 卡再计算缺失专家 -
• 最后按 router 顺序合并结果 -
• 主机只搬字节,不参与计算
8. 卡上性能 ⚡
构建 B:133.33 MHz。
-
• 解码受 DRAM 约束 -
• DRAM 利用率 82-94% -
• 预填充受 MXU 约束 -
• 解码时 MXU 有空闲,DRAM 打满 -
• 预填充时 MXU 打满,DRAM 有余量 -
• 两种负载瓶颈不重叠 -
• 这是单指令流多单元的自然结果
卡上测量:
-
• selftest:ALL PASS -
• diag:124 PASS -
• qual:42 PASS 0 FAIL -
• token-exact:12/12
token-exact 指 12 个测试 prompt 的输出 token 与 fp32 golden 完全一致,不是近似匹配。这是“模拟器是规范”契约的端到端验证。

Lens 重放 Qwen3 解码步骤。
图解读:
-
• Lens 在 floorplan 上重放 Qwen3 解码步骤 -
• 每一步的数据移动与单元状态可视化 -
• 可对照 trace 逐周期解释性能 -
• 解码受 DRAM 约束 -
• 预填充受 MXU 约束
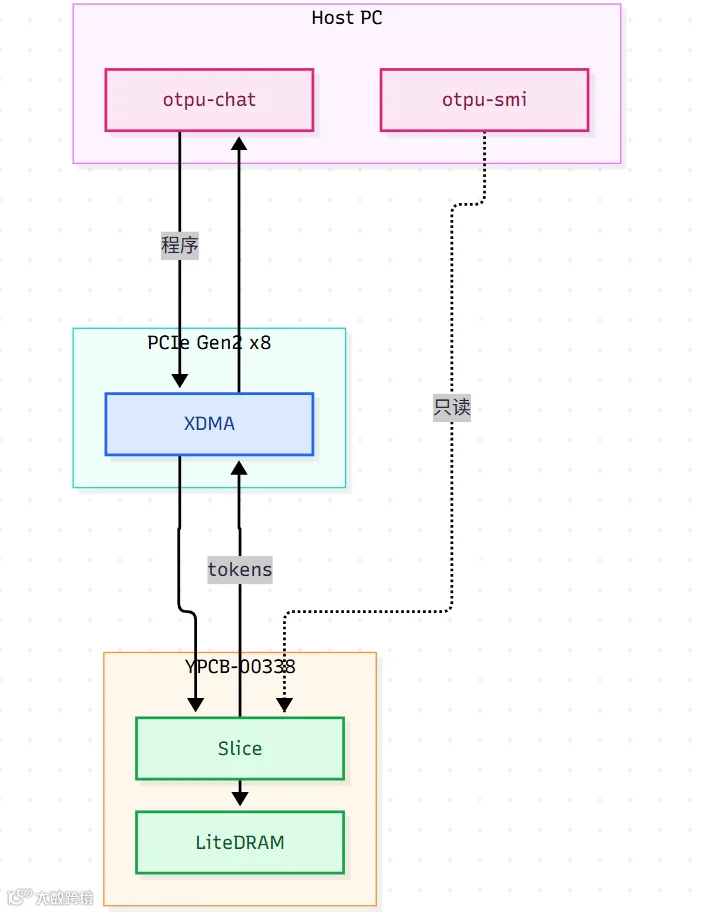
图解读:
-
• Host PC 上跑 otpu-chat 与 otpu-smi -
• PCIe Gen2 x8 经 XDMA 连接 -
• YPCB-00338 上是 Slice 与 LiteDRAM -
• chat 经 XDMA 把程序发给 Slice -
• Slice 把 tokens 经 XDMA 回给 chat -
• otpu-smi 只读 Slice 的计数器 -
• Slice 通过 LiteDRAM 访问 DRAM
9. 目标描述与后端架构 🎯
openTPU 的可移植性来自一个四层目标描述。每个设备一个 targets/<name>.toml,由 target.py 读取。
9.1 四层目标描述
-
• arch: Config的字段 -
• S:slice 数 -
• D:MXU 深度 -
• MCOLS:MXU 列数 -
• LANES:VPU lane 数 -
• ACT_BLOCKS:ACT RAM 块数 -
• TMEM_WORDS:TMEM 字数 -
• DRAM_BYTES:DRAM 字节数 -
• PAIR:4-bit 列复用 -
• DSTEP:DMA 状态步进 -
• STREAM:流引擎 -
• SEQ_WC:WAITC 开关 -
• uarch:只改时序、不改结果 -
• MXU_IMPL:MXU 实现 -
• TMEM_IMPL:TMEM 实现 -
• RPB/WPB:读写端口 -
• WIN:dispatch 窗口 -
• FIFO_DEPTH:MXU 预取深度 -
• TRACE_DEPTH:trace 深度 -
• CHASH:通道哈希 -
• tech:单元库族 -
• generic -
• xilinx7 -
• xilinxus -
• asic -
• 以及器件或 PDK -
• platform:板级 -
• 内存类型 -
• 通道数 -
• 主机链路 -
• 核心时钟
target.py 提供:
-
• config():编译器与模拟器用 -
• sim_uarch():Verilator 构建用 -
• rtl_params():FPGA/ASIC 顶层用 -
• arch_hash():设备的 CFG_HASH 与主机校验
OTPU_TARGET 选目标,默认 YPCB-00338。
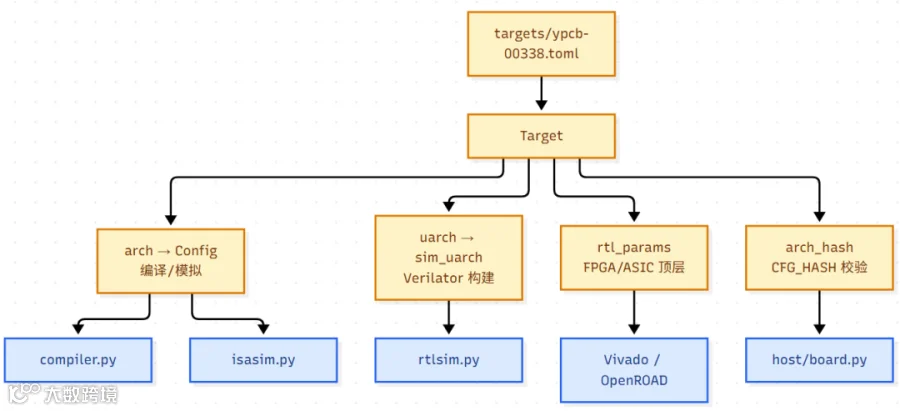
图解读:
-
• targets/ypcb-00338.toml 读成 Target -
• arch 转成 Config,给编译器与模拟器 -
• uarch 转成 sim_uarch,给 Verilator 构建 -
• rtl_params 给 FPGA/ASIC 顶层 -
• arch_hash 给 CFG_HASH 校验 -
• Config 同时给 compiler.py 与 isasim.py -
• sim_uarch 给 rtlsim.py -
• rtl_params 给 Vivado/OpenROAD -
• arch_hash 给 host/board.py
9.2 语义契约的三方实现
-
• isasim.py:位精确功能模拟器 -
• Slice实现每条 ISA 指令 -
• Machine调度 slice -
• 处理 collective、WAITW、HALT CHAIN -
• 它是黄金模型 -
• RTL 跑完后 TMEM/DRAM 必须逐位一致 -
• fp32.py:IEEE-754 RNE -
• flush-to-zero -
• canonical NaN -
• RTL 实现同一组函数 -
• 测试逐位比对 -
• rtlsim.py:Verilator 构建 -
• 把 SystemVerilog 构建成 --binary -
• 按源文件内容哈希缓存 -
• 参数、VFLAGS、Verilator 版本入键 -
• 构建在临时目录 -
• 链接成功后再 rename -
• 每个构建一把 flock -
• 并发构建同一目标会等待 -
• 被杀死的构建不留可执行文件 -
• 仿真器跑在 shell 包装下 -
• 父进程死掉时子进程也被杀死 -
• macOS 没有 PR_SET_PDEATHSIG -
• 靠轮询父 PID 实现 -
• rtl/:SystemVerilog 实现 -
• target.sources()按顺序给文件 -
• core -
• cell family -
• FPGA shell -
• board top -
• tests/test_target.py检查一致性 -
• 检查 rtlsim.RTL_SOURCES -
• 检查 board Makefile -
• 检查 create_project.tcl -
• 检查 tools/synth
9.3 三种后端
-
• ISA 后端: IsaBackend -
• 持有一台持久 Machine -
• DRAM 保留 KV cache -
• adopt=True时镜像数组直接变成机器 DRAM -
• 原地 resize,4 GiB 镜像只存一份 -
• RTL 后端: RtlBackend -
• 每次 run()调rtlsim.run() -
• Verilator 仿真分钟级一个 token -
• 用来证明 RTL 能逐位跑真实网络 -
• 板级后端: BoardBackend -
• 实现 write/read/run -
• 实现 prepare/attach -
• start()/wait()拆成两半 -
• 主机在卡跑当前程序时编译下一个 token -
• trace记录到 trace buffer -
• last是最近一次运行的(programs, stats)
9.4 主机驱动与 DMA 细节
-
• XDMA 传输 -
• h2c_0/c2h_0按 AXI 地址偏移做 DMA -
• _user映射 BAR0 寄存器窗口 -
• 控制寄存器 -
• LiteDRAM CSR -
• XADC -
• DDR4 每 DIMM 的 CSR -
• 寄存器访问按 32-bit word 逐次 load/store -
• 切片 mmap 会变成逐字节 AXI-Lite 写 -
• otpu_ctrl每次写取整字 -
• 只保留最后一个字节 -
• DMA 放置 -
• DMA_PLACE = 2048 -
• 写要求 host−card 地址 mod 64 = 0 -
• 否则 0.77 GB/s 而非 1.7 -
• 读要求 mod 4096 落在 [32, 4064] -
• 否则 1.16 GB/s 而非 1.65 -
• 不满足的缓冲区经 staging 缓冲中转 -
• 运行中的写限制 -
• XDMA 的 H2C 引擎会“跑圈” -
• 一次主机→卡调用超过 4 KiB 且通道忙 -
• 数据会错位 8 KiB 或写成旧数据 -
• 直到重载 bitstream -
• 所以 Board.write每通道每次最多RUN_H2C = 4096字节 -
• DMA 锁 -
• 同一张卡的 h2c 与 c2h 调用永不重叠 -
• 2026-10-01 在卡上观察到永久错位 -
• 225 GB 单向写、11 GB 单向读无问题 -
• 进程内线程锁 -
• 跨进程 flock: <run dir>/<card>.dma -
• 原子写 -
• 只写数据落入的 64-byte beat -
• 绝不把整 chunk 写回 -
• generate 运行时卡可能同时写状态字 -
• 整 chunk 写回会覆盖卡刚写的字
9.5 主机工具链
-
• otpu-smi -
• 读寄存器 -
• 写 SNAP -
• SNAP latch 自由运行计数器 -
• 不扰动任何东西 -
• 读 runner 状态文件 -
• 功率优先走 I2C 的 PMBus 实测 -
• 否则用 Vivado report_power缩放估计 -
• 标“~… estimate” -
• -l模式带 sparkline -
• otpu-selftest -
• 分阶段 bring-up -
• link → config → calib -
• scrub → regs → addr -
• pattern → bandwidth → kernel -
• vops → stream → model → ecc -
• 第一个失败停下并给 hint -
• otpu-diag -
• 不因首个失败停下 -
• 跑所有前置通过的检查 -
• 其余标 SKIP 并注明前置 -
• 最后给工作/不工作矩阵 -
• 给模式诊断 -
• otpu-memcal/ddrcal.py -
• LiteDRAM A7DDRPHY 主机侧校准 -
• CK 相位扫描一个 tCK -
• 每 lane 取公共窗口中心 -
• 写延迟校准 -
• 读 leveling -
• 核心 CPU 也能在复位时自校准 -
• ensure()先等它 -
• 失败的信道再从主机校 -
• otpu-i2c -
• 只读的 I2C 总线访问 -
• LM73 温度传感器 -
• PMBus 电源 -
• TI 电流监测 -
• 所有事务用锁串行化 -
• 绝不写数据字节 -
• 只写命令码或寄存器指针
10. FPGA 板级 🛠️
YPCB-00338 🟢
-
• Kintex-7 xc7k480t -
• 2×DDR3-1066 -
• PCIe Gen2 x8 -
• 核心 133.33 MHz -
• LiteDRAM + WL7DDRPHY -
• 核心内 CPU 校准 -
• 上电自动完成 DDR3 写/读电平与延迟对齐 -
• 校准跑在 VexRiscv 上 -
• 不需要主机介入 -
• 单副本泵送 TMEM -
• ACT_ROWS 16 -
• 4 MX 列 E 4 -
• 单副本把 TMEM 从六副本的 384 RAMB36 压到 64 RAMB36 -
• 代价是重放仲裁逻辑
BCU1525 🔵
-
• VU9P -
• 4×DDR4,64 GB -
• PCIe Gen3 x16 -
• S=2 slice -
• DSP48E2 -
• TMEM 用 UltraRAM -
• UltraRAM 提供 270 Mb 片上存储 -
• 适合放多 slice 的 TMEM -
• DSP48E2 比 K7 的 DSP48E1 多一个预加器 -
• MX 列末累加受益 -
• 待 Vivado 许可证

图解读:
-
• 校准分四步:VexRiscv、写电平、读电平、BIST -
• BIST 选窗口后交给 WL7DDRPHY -
• WL7DDRPHY 与 LiteDRAM 双向连接 -
• 校准跑在 VexRiscv 上,不需主机 -
• 上电自动完成 DDR3 写/读电平与延迟对齐 -
• 单副本泵送 TMEM 的代价是重放仲裁
11. ASIC 流程 🏭
NanGate45 + OpenROAD-flow-scripts。
-
• 综合:Yosys 完成,把 RTL 翻译成门级网表 -
• 布局布线:OpenROAD 完成,把门级网表映射到芯片物理位置并生成金属互连
设计点
-
• small:D=32、MCOLS 2、4 lane -
• card:D=128、MCOLS 4、8 lane
11.1 nangate45-small 参考 🥇
-
• 面积:7.02 mm² -
• 利用率:35% -
• 实例数:571K -
• 寄存器到寄存器:422 MHz -
• 功耗:0.79 W -
• DRC:0 -
• DRC 为设计规则检查 -
• 统计违反工艺规则的图形数

nangate45-small 布线后布局。
图解读:
-
• 7.02 mm²,35% 利用率 -
• 571K 实例 -
• 寄存器到寄存器 422 MHz -
• 功耗 0.79 W -
• DRC 为 0 -
• 这是 small 设计点的参考
卡点 r2:
-
• 面积:4.52 mm² -
• 频率:386 MHz -
• 功耗:4.87 W -
• TMEM 单副本:1.33 mm² -
• TMEM 三副本:4.00 mm²
11.2 宏放置迭代 🧱
候选 A:顶部带状

图解读:
-
• 候选 A 把宏放在顶部带状 -
• setup -0.698 ns -
• 21 违例 -
• 比候选 B 好得多 -
• 是迭代的起点 -
• setup -0.698 ns -
• 21 违例
候选 B:两个角落
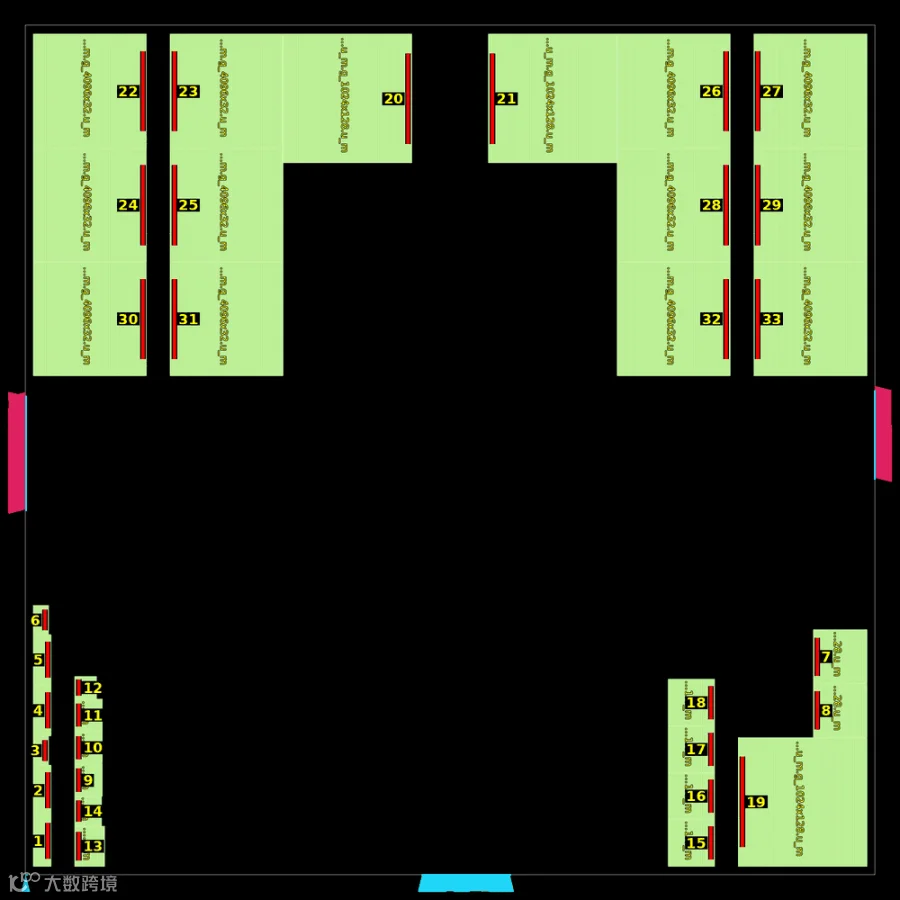
图解读:
-
• 候选 B 把宏放在两个角落 -
• setup -0.753 ns -
• 4149 违例 -
• DMA 状态穿裸片到每个 TMEM 副本 -
• 2.11 ns 中继器 -
• 所以候选 B 失分 -
• setup -0.753 ns -
• 4149 违例
💥 候选 B 失分:DMA 状态穿裸片到每个 TMEM 副本。2.11 ns 中继器,为长互连插入的缓冲器,用于恢复信号摆幅与延迟。
setup 要求数据在时钟沿前稳定;hold 要求时钟沿后保持。WNS 为最差路径的负裕量;TNS 为所有违例路径负裕量之和。
11.3 SW_REG 🛡️
把 SW 输出放触发器后面。加一级寄存器,信号晚一拍但时序更稳。
iter 0:
-
• setup WNS:-0.698 -
• hold:-0.006 -
• DRC:1
iter 1:
-
• setup WNS:+0.001 -
• hold:+0.039 -
• DRC:0
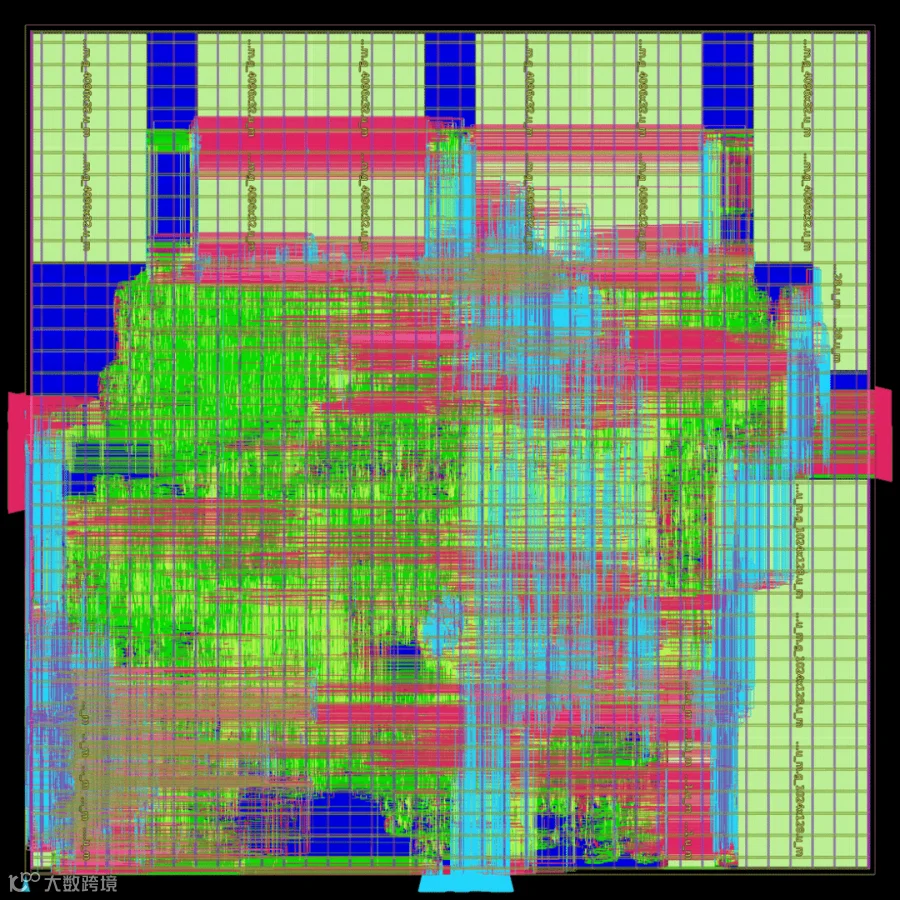
候选 A 布线后迭代 1。
图解读:
-
• 候选 A 布线后的迭代 1 -
• setup WNS 从 -0.698 变 +0.001 -
• hold 从 -0.006 变 +0.039 -
• DRC 从 1 变 0 -
• 现在限制是授权扇出 -
• 1.52 ns 逻辑 + 1.42 ns 中继器
🎯 现在限制:授权扇出。单个信号驱动过多负载。1.52 ns 逻辑 + 1.42 ns 中继器。
11.4 OpenLayout 🗺️
-
• 利用率:60% -
• 时序:3.3 ns -
• 宏放置:计划宏放置 -
• 人先确定宏坐标 -
• 再让工具做标准单元布局与布线
候选 2:
-
• setup +0.156 ns -
• DRC 0 -
• 功耗 0.555 W
rtlmp 基线:
-
• 0 溢出 -
• 但 16,354 DRC 不收敛
溢出指某区域布线需求超过可用轨道数的边数。时钟偏斜为同一时钟到达不同寄存器的时延差。

候选 2 宏放置。
图解读:
-
• 候选 2 是计划宏放置 -
• 人先确定宏坐标 -
• 工具再做标准单元布局与布线 -
• 利用率 60% -
• 时序 3.3 ns -
• setup +0.156 ns -
• DRC 0 -
• 功耗 0.555 W

候选 2 布线后 3.3 ns。
图解读:
-
• 候选 2 布线后 3.3 ns -
• 基于布线后提取寄生 RC 做 STA -
• 比布局阶段估算更准 -
• 3.3 ns 差 -0.05 ns -
• 31 端点 -
• 最差在 VPU u_ma 加法器

rtl_macro_placer 基线。
图解读:
-
• rtl_macro_placer 基线 0 溢出 -
• 但 16,354 DRC 不收敛 -
• 所以计划宏放置更稳 -
• 候选 2 是最终选择
抽取时序:基于布线后提取的寄生 RC 做静态时序分析,比布局阶段估算更准。
-
• 3.3 ns 差 -0.05 ns -
• 31 端点 -
• 最差在 VPU u_ma加法器
11.5 TMEM 按读者放置 🧭
角落:
-
• skew 0.96 ns -
• 2.5 ns 不满足
按读者:
-
• skew 0.31 ns -
• 余 0.5-0.8 ns
📏 数据延迟: 。3 mm 外付 0.66 ns。

图解读:
-
• 角落放置:16 宏放右下,距读者 3-5 mm -
• 角落 skew 0.96,2.5 ns 不满足 -
• 按读者放置:两叠宏,200 um strip -
• 按读者 skew 0.31,满足 -
• 数据延迟公式:0.47 ns + 0.220 ns/mm × d -
• 3 mm 外付 0.66 ns -
• 所以 TMEM 要按读者放置
MXU 按列放置:
-
• ACT 宏两叠相邻 -
• 面向 800 um strip -
• 权重在 strip 内 hop -
• 不穿宏
按列 45%:最佳 1.10,线 87.5 m。保持 40% 裸片拥塞,线少 5%。
12. 验证与工具 🔬
12.1 三方比对
-
• validate.py -
• 设备 vs 量化 golden -
• 设备 vs fp32 -
• 设备 vs floor -
• ISA vs float64 -
• 比对模拟器输出与 fp64 参考 logits -
• RTL vs ISA -
• 比对 Verilator 与 isasim.py -
• TMEM 与 DRAM 逐位一致 -
• otpu-lens -
• 记录 trace 到 .otpuprof -
• 浏览器看 roofline -
• 看 timeline -
• 看 floorplan 重放 -
• 看按指令/源行表格
12.2 可观测性
-
• otpu-smi -
• bitstream -
• link -
• 温度 -
• 功率 -
• DRAM -
• 利用率 -
• 进程 -
• otpu-diag -
• 分 section 完整诊断 -
• --mem full跑 march C- -
• --soak N重跑内核集 -
• 统计间歇性故障 -
• otpu-selftest -
• 分阶段 bring-up -
• 第一个失败停 -
• otpu-lens record -
• 从硬件 trace buffer 读 64-bit 记录 -
• hwtrace.records_to_trace()重建+trace文本 -
• profile.parse与lens.to_data生成 profile -
• kind 为 "hw"

图解读:
-
• 验证分三层:fp32.py、ISA vs float64、RTL vs ISA -
• fp32.py 是底层算术参考 -
• ISA vs float64 比对模拟器与 fp64 参考 -
• RTL vs ISA 比对 Verilator 与 isasim.py -
• 可观测有三个工具:otpu-smi、otpu-diag、otpu-lens -
• 三个可观测工具都辅助 RTL vs ISA 比对 -
• TMEM 与 DRAM 必须逐位一致
12.3 主机 DMA 与主机软件
-
• 主机 DMA -
• XdmaTransport按 放置 -
• 大于 16 MiB 分通道重叠 -
• 主机软件 -
• otpu-chat -
• otpu-serve -
• offload.py:MoE 专家流式加载 -
• host/chat_tui.py:Textual 全屏界面 -
• serve/:OpenAI 风格 API -
• serve/含 KV store -
• serve/含 continuous batching
13. 风险与开放项 ⚠️
13.1 硬件路径
-
• 🧊 泵送 TMEM 未全构建跑通 -
• CLK2X块已在 Vivado 验证 -
• 尚未做完整布局布线 -
• 缓解:先用 FAST=1 跑通功能 -
• 再上 133.33 MHz 全构建 -
• 🔁 重放前提依赖顺序 -
• 依赖 scoreboard / WAITC 顺序 -
• 仿真违反时 $fatal -
• 目前没有运行命中 -
• tile kernel 单元重叠更多 -
• 重放行为尚未测 -
• 需要单独 co-sim 验证 -
• 🏭 ASIC 双端口仅协同仿真 -
• 从未通过 ASIC 流程 -
• 写占用一个端口 -
• 代价 +2.75% 周期 -
• 下一步在 ORFS 跑小设计点 -
• 🧵 16-lane 无 stream engine -
• Verilator 只建 8-lane 的 SE -
• Qwen3.5 的 16-lane 会拒 DSTEP/STREAM -
• 编译器未拒绝 board_config(LANES=16, DSTEP=True) -
• 是个易用性缺口
13.2 板级与主机
-
• 🔵 BCU1525 待 Vivado 许可证 -
• 实际 DIMM 型号 -
• x4 RDIMM 的 DDR4 校准 -
• PCIe 插槽 -
• 供电与散热 -
• DDR4-2400 时序收敛 -
• 每项都可能改变板级配置 -
• 需硬件到位后逐项核对 -
• 🌡️ 卡上功率为估计 -
• YPCB-00338 没有可读 PMBus -
• otpu-smi用 Vivadoreport_power -
• 按利用率缩放 -
• 🚚 H2C overrun 在 XDMA 内部 -
• xdma_rnum_rids 8修复已确认 -
• offload 的大 expert 写仍是例外 -
• 需要更少 outstanding read -
• 或在 host 侧进一步拆分写入
13.3 软件与流程
-
• ⏱️ WAITCentries 生成慢 -
• 35B 上 4.2-4.9 s/程序 -
• 现走 worker / prebuild / 磁盘缓存 -
• affine abstraction 是未尝试方向 -
• 🧪 fp4x6精度未广测 -
• 只在 Qwen3、Qwen3.5、LFM2.5 验证 -
• MoE 和 Gemma 4 的格式选择 -
• 依赖更大的 dKL 扫描 -
• 📦 KV 格式变更未默认启用 -
• 如 6-bit V -
• qwen35、SmolLM3、Phi-4-mini 已通过 -
• Gemma 4 仍用 int8 V -
• 需按格式规则逐模型选择
🎯 小结:硬件路径风险集中在泵送 TMEM、重放前提、ASIC 双端口三项;板级风险集中在 BCU1525 硬件到位;软件风险集中在 WAITC 生成时间与格式扫描覆盖面。每项都有明确下一步,没有阻塞性未知。
📜 全部代码与文档以 Apache 2.0 发布。