AI 设计分子这几年进展飞快,但有一个瓶颈始终绕不过去:设计在硅基世界里迭代,验证却要在真实的湿实验室里排队。
10 月 16 日,谷歌发了篇博客,讲他们怎么把这个闭环真正打通:让 AI agent 直接操作移液机器人、设计并执行真实生物实验、读回结果、自己改方案。三个项目串起来看,目标很明确:人类定方向,agent 跑实验,在几轮"设计-测试"循环里做出有药物价值的分子。他们给出的代表性成果是:针对一个肿瘤相关靶点,筛出了亲和力个位数纳摩尔(nM)级别的全新蛋白结合体,这个水平通常要经历大量实验室优化才能达到。
这篇文章的价值在于细节,尤其是两个"agent 在湿实验里自己纠正幻觉式假设"的故事。我挑重点讲。
一、VERID:给 agent 装一个"物理现实底座"
AI agent 写代码控制移液机器人,最大的坑是:代码语法正确,不代表物理上做得成。
一个 8 通道移液头降到一条太浅的试剂槽里、从已经耗尽的孔里吸液、被未建模的流体效应污染,这些都不会让代码报错,但会让实验报废。
谷歌的方案叫 VERID(VERified Infrastructure for Discovery Laboratories),本质是实验室工作区的语义数字孪生:一棵实时、有状态的 3D 体积实体树,跟踪从机械臂几何、每个孔里的液体体积、试剂身份到枪头库存的一切。它建在开源的 PyLabRobot 框架上,提供四项能力:
实时 3D 状态追踪,行动前让 agent 先查台面布局、孔内体积、可用枪头;秒级虚拟干跑,动真试剂之前在仿真里抓碰撞和空孔;硬件安全拦截,非法命令到不了机器人;同步视频加动作日志,每次运行留完整档案。
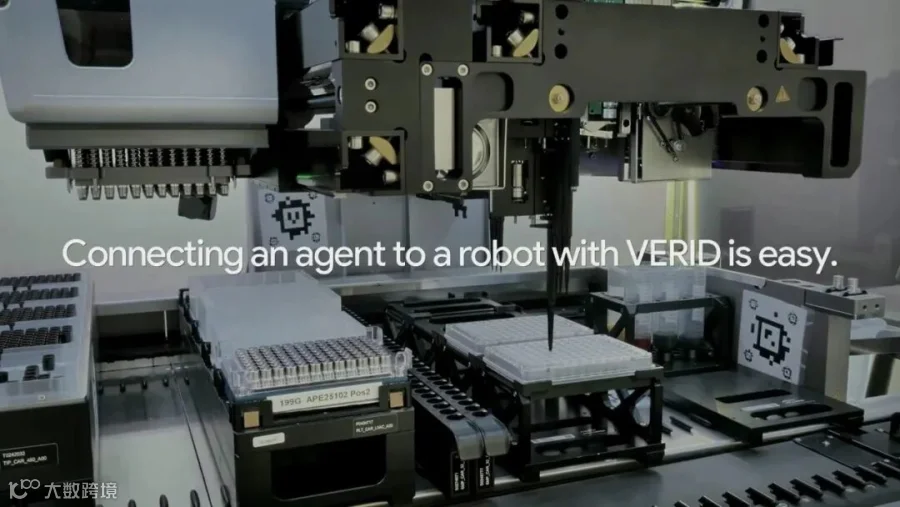
▲ 真实移液工作站实拍:agent 经 VERID 规划、仿真、执行液体处理协议(图源:Google 原文视频,下同)
报告里的案例都很实在。同步视频和执行轨迹抓到过一次"移液头离孔底太近导致染料分层不均",agent 据此改进了混匀策略;同一次实验里板读数仪中途故障,靠数字孪生的持久状态,agent 从中断处恢复,没有重吸一遍;仿真否决了一次物理上放不下的 8 通道吸取后,agent 现场重排了一个析因诊断实验,分离出枪头壁残留携带造成的微妙偏差,这是单纯重复实验根本发现不了的;还有一个闭环自博弈 campaign,agent 迭代设计并执行机器人实验,从俯视相机图像反推盲配染料混合物,跨轮次识别出自己的光学和流体伪影,精度提升了五倍以上。
二、适体沙盒:agent 学会了"别骗自己"
第二个项目是我觉得最有科学味道的一个。适体(aptamer)是能与蛋白结合的 DNA 序列,常用于临床生物标志物研究。它有个天然优势:DNA 可以化学合成成混合文库、直接测序读出,一轮完整的设计-测试-分析循环只要 7 到 10 天。这是测试"lab-in-the-loop"的完美沙盒。
流程是:agent 设计候选序列,对目标蛋白做磁珠筛选分离有功能的结合体,测序返回定量数据,喂给下一轮。三轮实验,两个难度不同的靶点。

▲ 闭环:分析 → 生成 → 设计 → 排序,候选合成、功能筛选、测序量化,循环 N 轮
两个靶点各踩了一个完全不同的坑,而 agent 都是自己从湿实验数据里爬出来的。
α-凝血酶:第一轮命中率为 0%,因为固定引物悬垂在 48% 的序列里干扰折叠。agent 第二轮引入夹紧侧翼茎结构,命中率升到 26.0%;第三轮多样化设计,到 42.1%,特异性 98.5%。
肌红蛋白:这个坑更经典。第二轮 agent 一味追求原始结合亲和力,设计的序列里 63% 富集了 G-四链体(G4)基序。原始拉下量确实涨了,但湿实验数据揭示了真相:这些 G4 大多是非特异性的"粘"性结合体,粘脱靶蛋白、甚至粘裸磁珠。于是特异性从 75.0% 崩到 19.1%,修正磁珠干扰后的真实命中率从 10.2% 跌到 3.7%。也就是说,agent 优化的是一个实验假象。
关键在于接下来的动作:agent 从第二轮的读数里识别出这个伪影,自主改写设计规则,第三轮限制滥交基序、扣除磁珠结合体、转向非 G4 结构骨架,特异性恢复到 72.4%,真实命中率翻了近九倍到 33.5%。

▲ 肌红蛋白(左):先跌后升的 V 形曲线;α-凝血酶(右):从零起步的爬坡曲线。绿色是真实命中率,红色是特异性
论文里还有一个有趣观察:这些 agent 会像一个科学家那样分析数据、提出湿实验协议的修改建议,但偶尔也会"非典型地思考",探索结构生物学家不会去试的序列空间。
三、蛋白结合体:人类定战略,agent 打战术
闭环到蛋白质要难得多:蛋白必须生物表达,每轮循环多出细胞筛选、表达、折叠,序列空间也大得多,计算和湿实验两侧都是瓶颈。
他们选的靶点是 FAP(成纤维细胞激活蛋白 α),实体瘤中过表达的大型困难受体。计算侧的突破口很有意思:去 novo 结合体设计的最后一步是复合物重折叠验证,这一步吃掉绝大部分 GPU 算力,而且开销随靶点长度二次方增长。他们的解法叫"外科表位切除":折叠时只保留局部结合口袋,砍掉周围结构。每个循环加速 8.6 倍(59.3 秒 → 6.9 秒),结构精度不损失。
这组实验还给了一个很有说服力的对照。同等算力下:科学家单独做,用 4 个表位,计算机内命中率 5.06%;agent 单独做,扫了 13 个表位,6.18%;人类定高层战略、agent 执行战术的人机混合,7 个表位,命中率 9.33%,接近科学家的两倍,而且命中的靶点位点分布宽得多。湿实验侧用酵母表面展示加 FACS 流式分选做平行筛选,几轮下来拿到亲和力 3-10 nM 的结合体。
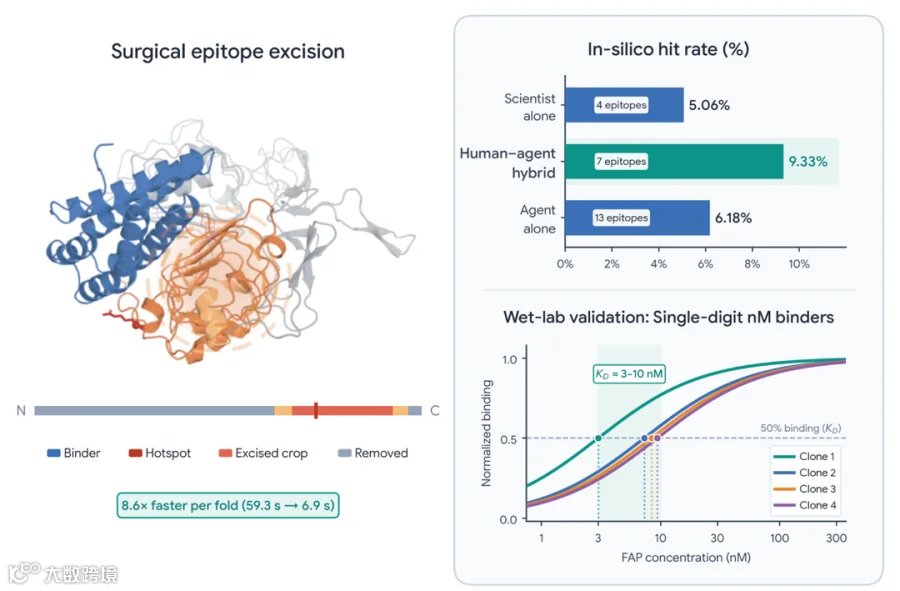
▲ 左:外科表位切除示意(8.6 倍加速);右上:人机混合 9.33% vs 科学家 5.06% vs agent 6.18%;右下:四条克隆的 FAP 结合曲线,KD ≈ 3-10 nM
四、安全:三条防线
让 AI 自主操作生物实验台,安全是不能省略的一节,谷歌给的做法也写得很具体。
第一,安全的测试床和筛查:刻意选无感染风险、无功能获得性风险的受控生物系统当试验场,所有设计序列过生物安全筛查。第二,先仿真后执行:VERID 保证 agent 的每条协议都先在仿真里干跑、对照数字孪生验证,才碰得到试剂。第三,人类监督:设计序列由人直接授权和审查,湿实验协议人工确认,机器人运行有人看着。
他们也点了几个开放问题:确保 agent 优化的是真实靶点结合而不是实验捷径、验证多步湿实验协议、持续监控 agent 的推理和执行轨迹。这些问题没有标准答案,谁先做出来,谁就有资格谈自主实验室。
五、我的几点想法
第一,VERID 这个东西的真正启示不在生物领域。任何让 agent 操作物理世界的系统,都会遇到"代码合法但物理非法"的问题。语义数字孪生加"先仿真后执行",是这个问题目前看到的最干净的解法。自动驾驶、工业机器人、无人机,全都适用。
第二,适体实验里那个 G-四链体的故事,值得每个做 AI for Science 的人刻在心里。agent 优化的指标涨了九倍的速度,然后被湿实验一巴掌打醒:那是粘性假象。它能自己改规则翻身,靠的是真实读数。这提醒我们,agent 的"自我改进"只有在有可靠外部反馈时才成立,纯 in-silico 的自我迭代很容易演化出精巧的自欺。
第三,人机混合 9.33% 对 6.18% 这个对照,比任何"AI 取代科学家"的叙事都有信息量。agent 单独做的优势是覆盖面(13 个表位),科学家的优势是判断,而混合把两者都拿到了。短期内的最优解不是无人实验室,是战略在人、战术在 agent的分工。
第四,把最近几篇连起来看,谷歌和 Anthropic 在各自的赛道上是同一个叙事:Deep Review 审论文,Scion 管代码,量子线路设计管计算,VERID 管实验台。验证闭环正在一个个被工程化接管。湿实验室是其中最贵、最慢、也最接近"真实世界反馈"的一个。谁先把它规模化,谁就把"AI 做科学"从口号变成流水线。
参考:Google Research Blog, "Grounding AI agents in biological reality", 2026-10-16;VERID、适体沙盒、表位切除三篇论文见原文链接。文中数据与图片来自原文,图片版权归 Google 所有。
1.20K-40K!深圳扬奇医芯招双目结构光算法工程师
2.AI教父Hinton诺奖演讲首登顶刊!拒绝公式,让全场秒懂「玻尔兹曼机」
3.GitHub没了?CEO辞职,微软接管,开发者天塌了
4.AI颠覆数学研究!菲尔兹奖得主、华裔数学家领衔11篇顶刊论文|陶哲轩转赞
5.AI OS,下一个二十年的超级平台
6.全球首个IMO金牌AI诞生!谷歌Gemini碾碎奥数神话,拿下35分震惊裁判