英伟达(NVIDIA)正在将完整的Run:ai平台作为开源软件提供给用户,使客户、开发者和生态系统合作伙伴能够获得生产级AI工作负载和GPU编排能力。此次发布通过建立 NVIDIA Run:ai 作为开放基础来扩展 NVIDIA DSX AI Factory Platform,使更广泛的生态系统能够更快地将差异化解决方案推向市场,以响应不断变化的客户需求。

在过去几年中,NVIDIA Run:ai 帮助组织在Kubernetes上大规模运行AI工作负载,通过动态分配GPU资源并在从数据处理、训练到推理的整个生命周期中管理工作负载。通过将 NVIDIA Run:ai 平台能力作为 NVIDIA DSX AI Factory 的一部分开源,现在每个 NVIDIA DSX 生态系统合作伙伴和AI云都可以提高工作负载吞吐量、改善GPU利用率并更高效地运营共享AI基础设施。
此次开源发布,包括完整的 NVIDIA Run:ai 平台和四个也可独立采用的组件:KAI Scheduler、GPU Fractioning Operator、KAI Resource Management、Workload Map。这些组件与额外的平台代码共同组成了集成的 NVIDIA Run:ai 平台。平台团队和生态系统合作伙伴可以将 NVIDIA Run:ai 作为整体采用,在其上构建自己的产品和服务,或根据需求集成单个组件。
NVIDIA Run:ai 可以直接作为开源软件采用,也可以通过 NVIDIA DSX 生态系统合作伙伴的产品采用。

直接部署开源平台
NVIDIA Run:ai 的完整源代码可在 NVIDIA DSX AI Factory GitHub 组织内的 NVIDIA Run:ai 代码仓库中获取。团队可以检查代码、为其开发做出贡献、在平台之上构建或独立采用其模块化组件。
完整的开源 NVIDIA Run:ai 平台也可在 NVIDIA NGC 上获取,提供用于安装集成技术栈。
NVIDIA Run:ai 平台的模块化开源组件
开源发布中包含的四个组件:KAI Scheduler、GPU Fractioning Operator、KAI Resource Management 和 Workload Map。这些组件与额外的平台代码共同组成了集成的 NVIDIA Run:ai 平台。你可以将 NVIDIA Run:ai 作为整体采用,或根据需求集成单个组件。
KAI Scheduler:NVIDIA Run:ai 背后的调度引擎
KAI Scheduler 是驱动NVIDIA Run:ai 平台的Kubernetes原生调度器。NVIDIA 在 Apache 2.0 许可证下将 KAI Scheduler 作为开源软件发布,并将其贡献给 CNCF 作为 Sandbox 项目。KAI 仍然是NVIDIA Run:ai 背后的上游引擎,所有调度器开发都在社区仓库中进行,因此每一项改进都通过同一代码库流转。NVIDIA 继续支持项目的维护者并与更广泛的生态系统合作推进大规模AI工作负载调度。
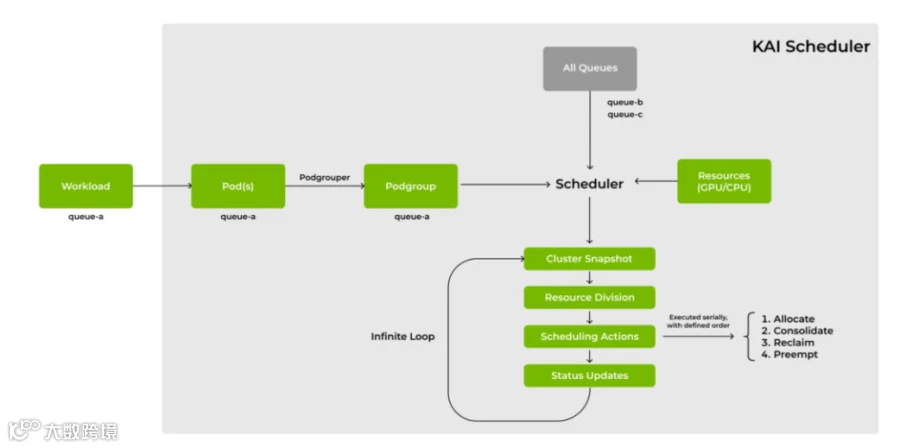
将 KAI Scheduler 用于需要公平访问集群资源和拓扑感知放置的多样化AI工作负载。它可以部署在现有集群中,与当前软件栈并存,无需完整的 NVIDIA Run:ai 平台。
GPU Fractioning Operator:Kubernetes上的GPU分数分配
NVIDIA Run:ai 平台长期支持分数GPU分配,使多个工作负载能够以硬性内存隔离共享一个GPU。分数可以按需请求并即时设置,无需管理员提前进行每节点设置。这是ML团队运行不需要GPU全部内存的工作负载(包括交互式笔记本和较小模型的推理)时使用最广泛的能力之一。
NVIDIA Run:ai 以专有实现开创了这一体验。GPU Fractioning Operator 将CUDA原生的GPU分数分配引入Kubernetes,专有实现已退役,转而采用 CUDA 13.4 中可用的原生能力。CUDA驱动对每个工作负载的GPU内存强制执行硬性限制,每个工作负载只能看到分配给其分数的那部分GPU内存。
将 GPU Fractioning Operator 用于可以共享未充分利用GPU容量的工作负载,包括笔记本、开发会话和较小模型。GPU Fractioning Operator 与 KAI Scheduler 集成,将可用GPU容量转化为实际的放置决策,同时兼容其他调度器。
KAI Resource Management:组织层
调度器决定工作如何放置,而KAI Resource Management 决定谁得到什么:
-
项目和部门: 组织结构或"组织层",将资源映射到消费它们的团队和计划 -
带有组织层级的资源管理: 在该组织结构中分配、保证和共享GPU容量的能力,具有公平份额和配额语义 -
节点池: 分组和定向异构硬件,使工作负载落在正确的资源上
这些功能共同使平台团队能够超越原始Kubernetes调度,以组织实际运作的方式管理GPU:按团队、按部门、按计划、按资源保证。
将 KAI Resource Management 用于由多个团队共享的异构集群,这些团队需要确定的容量份额。例如,平台团队可以保证将集群的50%分配给研究,同时防止任何单一团队垄断剩余容量。如果你已经在电子表格中跟踪配额权益或手动维护每个团队的命名空间,这就是替代它的那一层。它可以与集群中的 KAI Scheduler 结合使用。
Workload Map:Kubernetes的工作负载管理契约
Workload Map 是NVIDIA Run:ai 用于支持任何工作负载类型的契约。KAI Scheduler 将其用于调度和gang语义;平台的其余部分将其用于工作负载发现、监控和生命周期管理。
在Kubernetes中,一个AI工作负载几乎从来不是一个裸的Deployment或Job。它是一个PyTorchJob、一个RayCluster、一个JobSet、一个KServe InferenceService、一个Dynamo图部署,或公司自己的自定义资源。每种类型都有自己的内部结构、具有不同角色的组件(driver和workers、head和workers、prefill和decode)、自己的扩缩和gang语义以及自己的状态报告方式。
Workload Map 提供了一种一致的方式,将这些工作负载在其整个生命周期中视为一等对象:
-
描述Pod、组件和角色 -
提交和配置 -
具有gang和拓扑感知的调度 -
一致地观察状态和健康 -
在准入或运行时应用策略
这个工作负载管理层位于Kubernetes原语与服务用户的调度器、仪表板、SRE和故障排除工具、成本工具、备份工具和ML平台之间。Workload Map 不是让每个工具为每个CRD构建私有的、部分集成,而是为每种工作负载类型定义一次,使任何平台或工具都能够一致地调度、观察、操作和治理它,而无需对每个CRD进行硬编码。
将 Workload Map 用于必须理解和管理多种Kubernetes工作负载类型而无需对每个CRD进行硬编码的平台和工具。它作为Go库发布,可在非结构化对象上离线工作,因此你可以在不向集群添加任何东西的情况下采用它。它的范围经过刻意收窄:Workload Map 描述工作负载结构,不负责调度、排队、自动扩缩或跨集群传播。