每当我们使用ChatGPT或类似的AI助手时,偶尔会发现它们自信满满地说出一些错误的事实——把某个真实城市的位置说错,把一位名人的出生地张冠李戴。这类现象有个专门的名字叫"幻觉"(hallucination),是目前AI领域最让工程师头疼的问题之一。
假设有个学霸同学,在高中阶段积累了扎实的历史、地理和文学基础知识。毕业后,他参加了一个专门学习新编程语言的集训营。集训结束之后,他的编程能力确实提高了,可当你再问他"法国的首都是哪里?"时,他却支支吾吾说不准了。
事实上,在做大模型微调的团队里,几乎都听过一句话:“预训练决定模型有没有文化,SFT决定它会不会好好办事。”但更残酷的现实是,很多团队花了大量算力做SFT,效果却不如预期,问题往往不在训练代码,而在喂进去的那批数据。
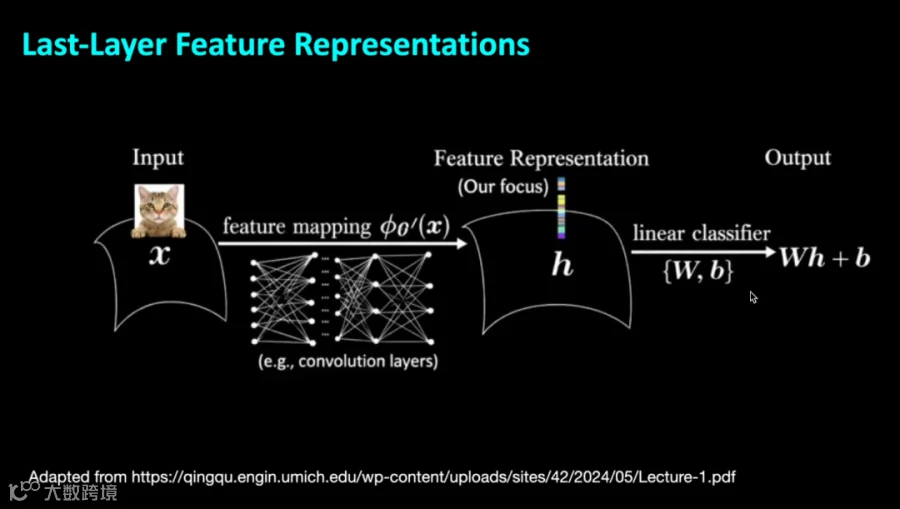
本文将串起一条完整的逻辑链:从深度学习里一个漂亮的理论现象“神经崩溃(Neural Collapse)”,到衡量特征质量的“特征偏移”,再到用“自筛选(Self-curation)”提纯SFT数据,最后聊聊为什么筛选阈值必须当成超参数来调,不能一味追求严格。
一、理想状态:神经崩溃,模型在追求一个完美几何
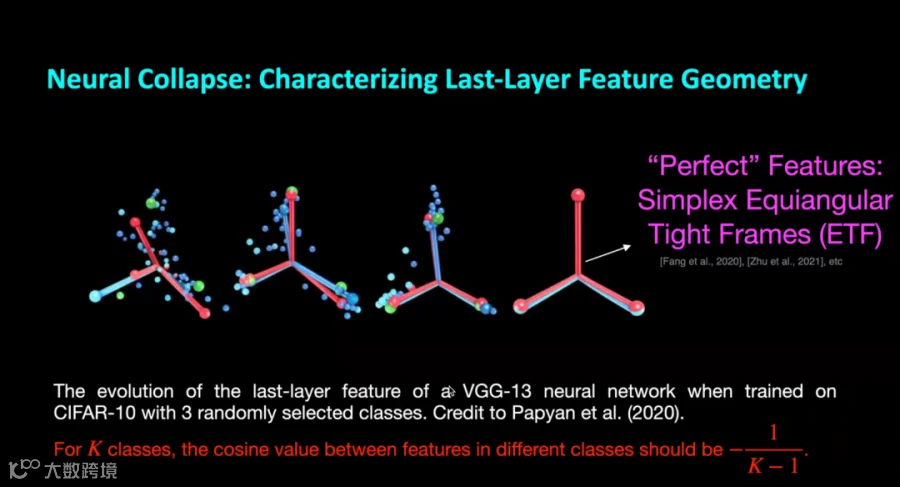
神经崩溃是近年来深度学习理论里很受关注的现象。简单说,当分类模型训练充分后,其特征表示会呈现三个特征:同一类别的样本特征高度聚拢到同一个中心;不同类别的中心在空间中均匀分布,形成类似单纯形等角紧框架(Simplex Equiangular Tight Frame, ETF)的对称结构;类内方差趋近于零。
对 $K$ 个类别来说,理想状态下不同类别中心向量之间的余弦相似度趋近于 $-1/(K-1)$。比如3分类时约为 $-0.5$,对应120度夹角。
这个现象的价值在于,它给了一个可以量化的“完美标准”。既然完美状态是已知的,那么就可以定义一个偏离量,用来衡量当前模型离理想状态有多远,这就是特征偏移参数 $\beta$。$\beta$ 越小,说明特征越干净、越接近理想几何,通常也意味着更好的泛化与可分性。
二、$\beta$ 的意义:一把衡量数据与模型底子的尺子
$\beta$ 不只是理论玩具,它可以用来对比不同预训练模型微调后的特征质量。
以视觉领域为例,把传统卷积网络ResNet和视觉Transformer(ViT)放在同一个数据集上做微调,通常会发现ViT得到的特征偏移更小,也就是更接近理想几何结构。这与ViT在迁移学习上的普遍表现是一致的:更好的预训练表征,更容易在下游任务上形成干净、可分的特征空间。
换句话说,底子好的模型,更容易“长”出高质量特征,也更容易在自筛选阶段挑出靠谱的数据。
三、自筛选:让模型自己给自己挑练习题
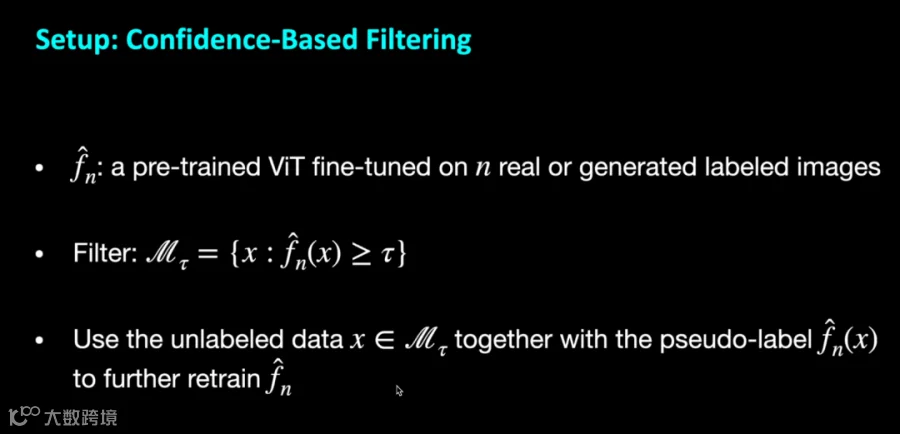
既然数据质量关键,那怎么低成本拿到高质量数据?一种常见思路是基于置信度的自筛选,也叫自训练(Self-training)加伪标签(Pseudo-labeling)的组合。
:让模型对大量无标签数据做预测,只保留预测置信度高于 $\tau$ 的样本。
从理论上讲,这个逻辑是站得住的。当训练数据量 $n$ 足够大、置信门槛 $\tau$ 足够高时,被筛选保留的样本更可能落在模型已经学得很稳的区域,其特征与理想特征的偏差会更小,也就是质量更高。
四、过度筛选会让模型重新崩溃
很多人会把置信门槛越调越高,觉得越严格越纯净。实际情况并非如此。
某些难类别可能几乎被全部过滤掉,模型对它们越来越陌生。
模型只在自己认同的样本上反复训练,错误更容易被强化,最终导致性能回落,甚至出现特征结构退化。
所以,**$\tau$ 必须被当作一个需要认真调优的超参数,而不是越严越好的道德标准。实践中常见的做法是配合数据量监控、类别分布监控,以及在小验证集上观察 $\beta$ 和实际准确率的变化曲线,找到平衡点。
五、回到SFT:为什么给示例往往比直接问更靠谱
在语言模型上,也有一个非常直观的对应现象:零样本(0-shot)和少样本(few-shot)的表现差异很大。给模型提供若干“提问+标准回答”的示例,往往能显著提升它在特定任务上的准确率和理解深度。
原因在于,示例帮助模型快速对齐任务格式、输出风格和隐含意图,相当于临时把它的表征拉到了更合适的区域。而SFT做的事情,本质上是把这种对齐固化进模型参数里,让它不需要每次都在提示词里塞一堆例子。
不过SFT也有明确边界。它靠模仿数据,只能让模型学得像,很难判断哪个回答更好。要进一步提升有用性和安全性,通常需要引入基于人类反馈的强化学习(RLHF)或直接偏好优化(DPO)这类偏好学习方法,用“哪个回答更好”的信号来补充SFT的不足。
六、给实践者的几点建议
:SFT效果差,优先排查标注错误、指令与回答不匹配、风格不统一等问题。
:通常只对回答部分计算损失,避免模型去学习预测用户输入。
:防止学新任务时出现灾难性遗忘,丢掉通用对话能力。
:冻结主干、只训练少量新增参数,成本显著降低,效果在很多场景下足够可用。
:跟踪筛选后数据量、类别分布、置信度分布,避免过度筛选导致模型退化。
:高置信不等于正确,尤其是模型在某个领域系统性错误时,它会自信地错。
结语
从神经崩溃到自筛选,这条逻辑链其实指向同一个结论:模型训练的本质,是让表征逼近更干净、更结构化的状态;而数据,是决定它能不能走到那里的关键。
海量脏数据很难训出好模型,少量高质量数据却常常能带来明显提升。真正成熟的微调流程,不是无脑堆数据,而是建立一套能持续评估、过滤、迭代数据的机制,同时警惕过度筛选带来的反噬。
参考文献
Zhang, Z., Srinivasan, R., Feedman, M., et al. Neural Collapse: A Unified Prediction with Generalizability and Robustness.arXiv preprint, 2021.
Papyan, V., Han, X., Donoho, D. L. Prevalence of Neural Collapse During the Terminal Phase of Deep Network Training.PNAS, 2020.
Dosovitskiy, A., Beyer, L., Kolesnikov, A., et al. An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale.ICLR, 2021.
He, K., Zhang, X., Ren, S., Sun, J. Deep Residual Learning for Image Recognition.CVPR, 2016.
Brown, T., Mann, B., Ryder, N., et al. Language Models are Few-Shot Learners.NeurIPS, 2020.
Ouyang, L., Wu, J., Jiang, X., et al. Training Language Models to Follow Instructions with Human Feedback.NeurIPS, 2022.
Rafailov, R., Sharma, A., Mitchell, E., et al. Direct Preference Optimization: Your Language Model is Secretly a Reward Model.NeurIPS, 2023.
Hu, E. J., Shen, Y., Wallis, P., et al. LoRA: Low-Rank Adaptation of Large Language Models.ICLR, 2022.
Lee, D., Cha, C., Fung, G., Park, S., Lee, N. Self-Training with Augmented Data Improves Fine-Tuned Language Models.EMNLP, 2021.
Arazo, E., Ortego, D., Albert, P., et al. Pseudo-Labeling and Confirmation Bias in Deep Semi-Supervised Learning.IJCNN, 2019.
专注于研发AI心理智能体
-----------------------------
让AI成为超级助手,
迈入人机协作时代。
主办方:惟一数字心理
- End -