


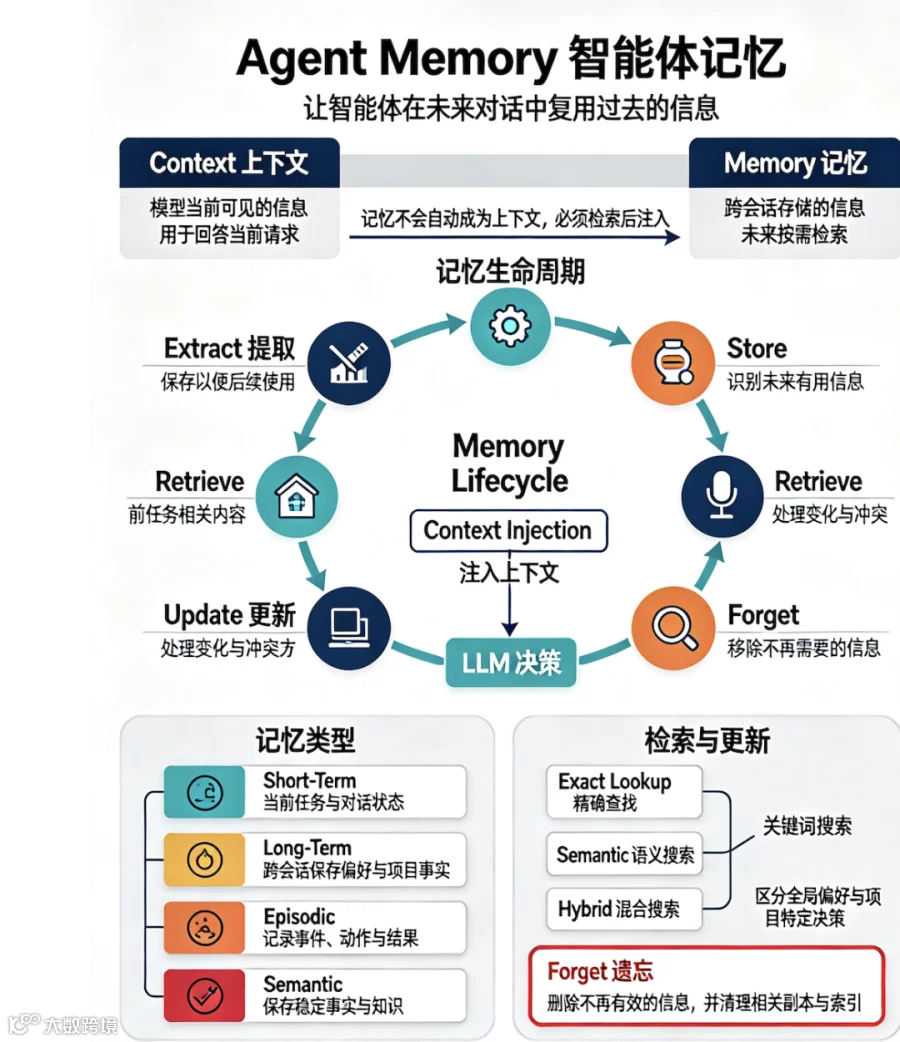

10 个关键问题Q&A
-
Q:什么是 Agent Memory? A:智能体记忆,是让 AI 智能体存储信息、跨会话复用历史交互信息的能力。 -
Q:Context 和 Memory 的核心区别是什么? A:上下文是模型当前请求可用的临时信息;记忆是预先存储的信息,必须检索后加入上下文才能被模型使用。 -
Q:智能体为什么需要记忆? A:记住事实、接续中断任务、基于历史信息做出更合适的决策。 -
Q:什么是短时记忆? A:服务当前对话或任务周期的信息,不限于内存,对话落库也可以属于短时记忆。 -
Q:情景记忆和语义记忆差别在哪? A:情景记忆保存完整事件过程与结果;语义记忆只保存独立事实,不带原始场景。 -
Q:记忆生命周期包含哪五个操作? A:提取、存储、检索、更新、遗忘。 -
Q:常见的记忆检索方式有哪些? A:精确查找、关键词检索、语义检索(Embedding)、混合检索。 -
Q:更新记忆时最大难点是什么? A:区分修改是全局偏好变更,还是仅针对单个项目的特殊设定,避免误覆盖。 -
Q:遗忘和更新有什么不同? A:更新是修改、保留信息;遗忘是彻底移除不再需要的记忆数据。 -
Q:记忆检索等于上下文工程吗? A:不是。检索负责取出存量记忆;上下文工程负责挑选、组织信息交给大模型,二者独立。
AI 智能体从当前对话接收信息,并依靠这些信息决定下一步动作。 但这些信息在后续对话里无法自动保留。 智能体记忆让智能体可以存储信息,并在将来使用。
举个例子,用户告诉智能体:
我偏好 Python,项目里使用 PostgreSQL。
智能体把这些偏好保存下来。 几天之后用户提问:
给我的下一个项目推荐一套后端技术栈。
智能体取出之前存储的偏好,基于它给出推荐。 如果没有记忆,智能体可能会反复询问相同问题;有了记忆,智能体就能复用历史交互里的信息。
为什么智能体需要记忆?
记忆主要在三方面发挥作用:
- 记住事实
保存用户偏好、项目细节、重要决策; - 接续任务
不用从头开始,继续之前未完成的工作; - 优化决策
参考过往交互里的相关信息。
设想一个辅助开发者搭建应用的代码智能体:在一次会话中,开发者指定了数据库、API 框架和编码规范。等到下一次会话,智能体可以直接读取这些信息,而不是重新询问。 只要历史信息有助于当下的决策,记忆就有价值。
上下文(Context) vs 记忆(Memory)
二者相关,但用途不同:
- 上下文
模型当下可用的信息;用于回答当前请求;包含指令、对话消息、实时检索数据;每次调用模型时动态组装。 - 记忆
为未来留存的信息;跨请求、跨会话复用;包含保存的事实、偏好、过往事件;按需存储、按需读取。
记忆不会自动变成上下文。 智能体必须主动检索相关记忆,再把它塞进发给大模型的上下文里。 举例流程:
-
智能体存储:用户偏好 Python -
用户开启一轮新对话 -
智能体检索到这条偏好记忆 -
将偏好加入当前上下文 -
大模型基于这条信息作答
这和前面讲的「上下文工程(Context Engineering)」直接相关。
重点重申:记忆不会自动进入上下文,必须由智能体检索后注入上下文。
智能体应该记住什么?
智能体不应该存储每一条消息,只挑选未来可能有用的信息:
-
用户偏好(比如首选编程语言) -
项目事实(应用使用的数据库) -
决策记录(选择某套架构的原因) -
历史事件(任务已经完成的步骤) -
适用于后续交互的规则指令
同时要避免存储无关、不可靠、已经失效的信息。
记忆的类型
短时记忆 Short-Term Memory
保存当前对话 / 当前任务周期内需要用到的信息。 例子:用户让智能体搭建 REST API,对话中指定框架、数据库、鉴权要求,智能体靠这些信息完成任务。
短时记忆常见内容:
-
近期对话消息 -
当前任务以及任务状态 -
工具调用和返回结果 -
执行过程中临时做出的决定
示例:
conversation = [
{"role": "user", "content": "Build a REST API."},
{"role": "user", "content": "Use FastAPI and PostgreSQL."},
]
重要:短时记忆不等于只放在内存 RAM 里。系统可以把对话历史持久化存入数据库,但依然归类为短时记忆。
长时记忆 Long-Term Memory
跨对话、跨任务会话持久保存信息。 例子:用户长期做 Python 后端项目,偏好 PostgreSQL,智能体保存这条偏好,隔很久之后的会话依然可以读取。
长时记忆常见内容:
-
用户偏好 -
项目需求 -
重要决策 -
历史交互学到的事实 -
已完成任务的结果
最简实现可以存在 JSON 文件:
{
"preferred_language": "Python",
"preferred_database": "PostgreSQL"
}
长时记忆不只是 “存数据”,系统还要判断存什么、何时检索、何时更新、何时删除。
情景记忆 Episodic Memory
存储特定事件、经历,回答:发生了什么?智能体做了什么?结果如何?
示例:
{
"event": "Resolved database connection failures",
"cause": "Connection pool exhaustion",
"action": "Increased the connection pool size",
"outcome": "Service recovered"
}
事件:解决数据库连接失败;原因:连接池耗尽;动作:调大连接池;结果:服务恢复
语义记忆 Semantic Memory
存储剥离了原始场景的事实与知识,不需要加载当初聊这件事的整段对话。
示例:
{
"project": "Inventory API",
"framework": "FastAPI",
"database": "PostgreSQL"
}
语义记忆适合稳定不变的事实、偏好、项目基础信息。
情景记忆 vs 语义记忆对比(调试数据库故障场景)
-
情景记忆(一段具体经历):昨天 API 报错,原因是数据库连接池耗尽,调大连接池后服务恢复。 -
语义记忆(一条独立事实):库存 API 使用 PostgreSQL。
区别:情景记忆保留事件全过程与结果;语义记忆只保留事实本身。 智能体可以同时使用两者:排查新故障时,既读取项目数据库配置,也读取过去同类故障的处理记录。
记忆检索 和 上下文工程 是两个独立步骤:记忆负责提供存量信息;上下文工程负责筛选、整理模型当下需要的内容。
记忆生命周期 Memory Lifecycle
智能体记忆不只是存储,一套记忆系统包含五大核心操作,构成完整生命周期:
提取 Extract → 存储 Store → 检索 Retrieve → 更新 Update → 遗忘 Forget
- 提取 Extract
识别未来有用的信息。对话里混杂事实、偏好、临时需求、无关废话,不能全部存成记忆。 例:用户说 “我后端用 Python,关系型数据库优先 PostgreSQL”,系统提取两条记忆:首选语言 Python、首选关系库 PostgreSQL。 提取可以靠规则、LLM,或者两者结合;提取要保留原意,不能把不确定的话当成确定事实。 - 存储 Store
保存提取出来的信息。存储方案按需选择:
-
JSON 文件:简单原型验证 -
关系型数据库:结构化记录 -
向量数据库:基于相似度检索 -
专用记忆系统(如 Mem0):一站式提取 + 管理
存储的记忆信息要足够支撑后续使用。
- 检索 Retrieve
查找和当前任务相关的记忆。 例:用户问给新项目推荐数据库,系统检索到 PostgreSQL 偏好,再把这条记忆加入发给大模型的上下文。
检索方式:
-
精确查找:根据 key / ID 定位 -
关键词检索:query 和文本关键词匹配 -
语义检索:基于语义相似度(依赖 Embedding) -
混合检索:关键词 + 语义检索结合
原则:只拿相关记忆,不要把所有记忆全塞进去。
- 更新 Update
记忆会过时、出错,新信息到来时要更新。 例子:用户先说偏好 PostgreSQL,之后说新项目改用 MySQL。 系统要区分:这条新说法是覆盖全局偏好,还是仅针对这个特定项目?二者不一定冲突。
更新策略可选:
-
直接覆盖原有值 -
新增一条范围更窄的事实 -
标记旧事实失效 -
暂时保留冲突信息,等待后续消解
- 遗忘 Forget
删除不再需要的记忆。 触发场景:用户主动要求遗忘、项目结束、信息不再有效。 遗忘 ≠ 更新:更新是修改并保留信息;遗忘是彻底移除。 如果同一条记忆有多份副本、多个索引,删除时要一并处理。
实操练习
仓库地址:https://github.com/ratishjain12/ai-engineering-notes/tree/main/examples/agents/agent-memory 示例演示能力:
-
从对话提取并保存事实 -
新开会话检索历史记忆 -
更新已保存偏好 -
将检索出来的记忆注入 LLM Prompt
目标:理解记忆层和智能体的协作逻辑,而不只是调用 SDK。