




10 个关键问题Q&A
-
Q:Kimi K3.1 Pro 是什么规格? A:3T 参数量开源模型,100 万 token 上下文,配套高速版,响应速度为标准版 2–3 倍。 -
Q:什么时候开放完整模型权重? A:最晚 2026 年 11 月 4 日发布权重。 -
Q:它代码能力水平如何? A:Terminal‑Bench 4.0 得分 65.7%,可独立完成游戏引擎项目、前端、动力学仿真。 -
Q:3D 建模方面有什么特色? A:BenchCAD 搭配工具可达 92.7%,支持参数化建模、Blender/CAD 脚本,平台自带 3D Make。 -
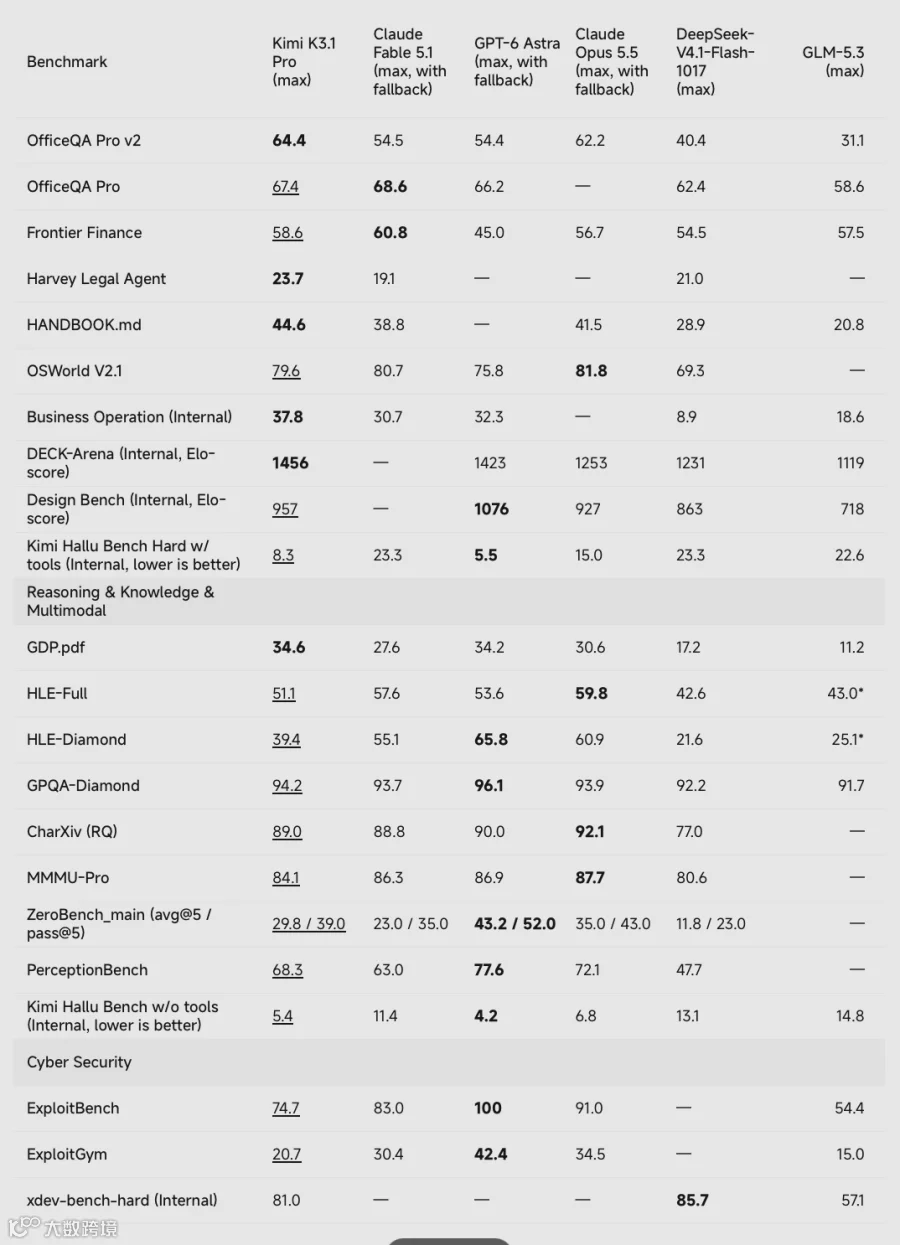
Q:金融能力改进在哪? A:多项金融基准上涨,声明级幻觉率从 23.4% 降至 8.3%,适合建模、投研。 -
Q:Kimi 怎么处理网络安全风险? A:训练阶段剔除漏洞相关数据,主动压低攻击性能力,不追求攻击突破。 -
Q:安全管控后,模型是不是完全没有安全能力? A:仍具备通用代码审计、漏洞排查等防御侧能力,适合企业自查。 -
Q:哪些平台可以直接使用 K3.1 Pro? A:Kimi 网页、移动端 App、Kimi Work、Kimi Code、Kimi API。 -
Q:企业版默认开启 K3.1 Pro 吗? A:默认关闭,需要企业管理员手动开启。 -
Q:它的开源理念是什么? A:走可控开源路线,避免放出攻击性过强的权重,帮助提升全社会软件安全基线。
我们正式推出 Kimi K3.1 Pro,它是全新 K3.1 系列的首款模型,也是我们迄今为止能力最强的 3T 参数量级开源权重模型,拥有100 万 token 上下文窗口。它在代码编写、3D 创作、金融研究以及其他智能体能力上都实现了大幅提升。
我们同时发布 Kimi K3.1 Pro 高速版(Kimi K3.1 Pro Highspeed),交互响应速度可达 K3.1 Pro 的 2‑3 倍。
Kimi K3.1 Pro 与 Kimi K3.1 Pro 高速版现已上线 Kimi.ai、Kimi Work、Kimi Code 以及 Kimi API 平台。完整模型权重将于2026 年 11 月 4 日前对外发布。
开拓开放智能新前沿
Kimi K3.1 Pro 是在 Kimi K3 基础上完成后训练迭代的版本,投入了规模更大的后训练计算资源。为了能够在上百个下游领域开展大规模联合强化学习,我们对整套技术栈进行全面优化:包括强化学习框架、长上下文推理、训练效率、沙箱基础设施、滚动调度、环境质量校验共享平台。让每一份强化学习算力投入,都可以带来稳定可预期的效果提升。最终,K3.1 Pro 在全部领域均取得稳定进步。
在代码、智能体、知识类各项基准测试中,K3.1 Pro 的表现已经看齐或接近业界头部闭源模型。 在评估编码智能体在真实受限终端任务表现的 Terminal‑Bench 4.0测试集上,K3.1 Pro 得分 65.7%,超过 GPT‑6 Astra(58.2%),仅略低于 Claude Opus 5.5(66.4%)。 在内部基准测试 Kimi Code Bench 3.0 Long‑horizon(Kimi 代码基准 3.0 长任务)(用于测试编码智能体多步骤执行、工具调用、跨多工程领域端到端解决问题能力)中,K3.1 Pro 取得 61.2% 的分数,高于 K3 版本的 55.95%。

代码能力
K3.1 Pro 可胜任各类编码工作,小到现有代码库快速 bug 修复,大到完整项目搭建。同时,它对游戏、网页交互体验的视觉风格把控更加成熟,并且懂得调用合适工具完成开发。
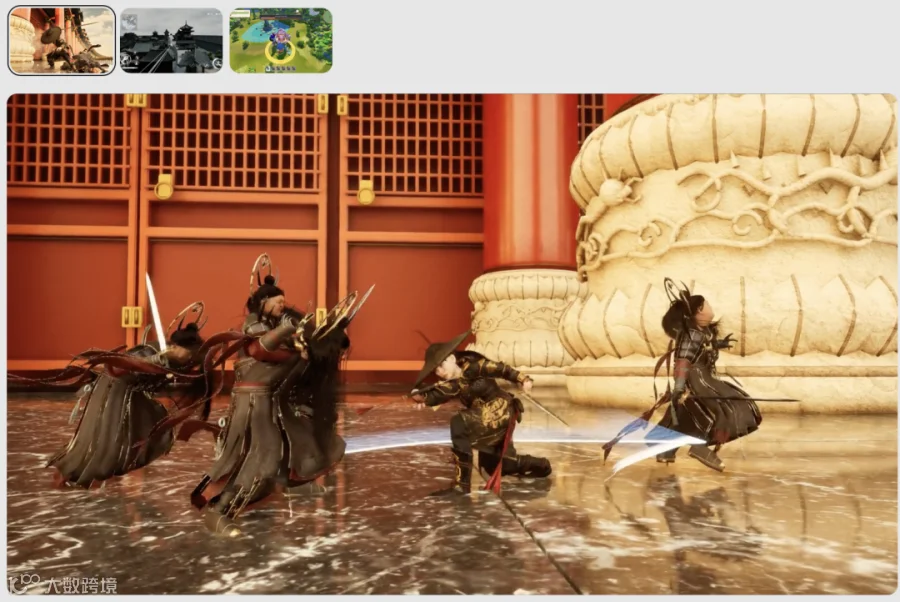
K3.1 Pro 可以高效使用 Unity、虚幻引擎、Godot 等主流游戏引擎,结合网页搜索与 3D 生成能力产出完整项目。它产出的前端页面、Three.js 交互式场景、3D 素材,在构图、排版、动画、细节打磨上都有更好表现。下面的示例全部由 K3.1 Pro 端到端生成:
虚幻引擎天宫之战游戏
Kimi K3.1 Pro 在虚幻引擎 5.8 中搭建出一座东方神话天宫。拥有半径 1750 米的 36 廊柱回廊;一条用 Blender 程序化建模生成的巨型神龙;主角角色由 MetaHuman 制作。场景源三角形数量达到 3600 万,使用 Nanite 做渲染、Lumen 实现光照。外部素材:Cloud Forge VDB 云层素材包、Poly Haven/ambientCG 8K 材质、NASA 月球测绘数据。
3D 汽车落地页
Kimi K3.1 Pro 基于定制版 Three.js 分支开发了一个浏览器端可滚动浏览的 3D 汽车展示页面。包含电影级布料展开动画,交互式工作室车库,一共四个展示章节,结尾可查看 968 个机械零件的爆炸分解视图。布料模拟与摄像机动画在 Blender 中预烘焙。外部素材:Sketchfab 平台 CC‑BY 协议的 JDM 轮毂素材。车身涂装、全部内部机械零件均由 Kimi K3.1 Pro 生成。本案例仅做能力演示,不代表马自达 RX‑7 FD3S 品牌授权或背书。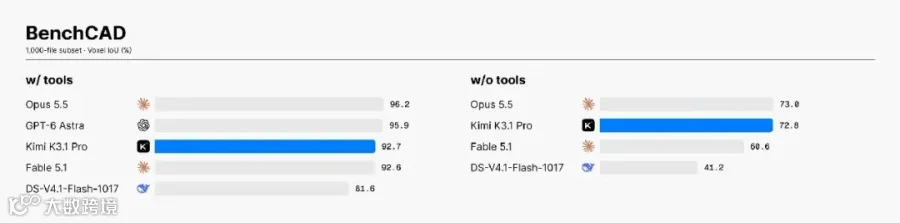
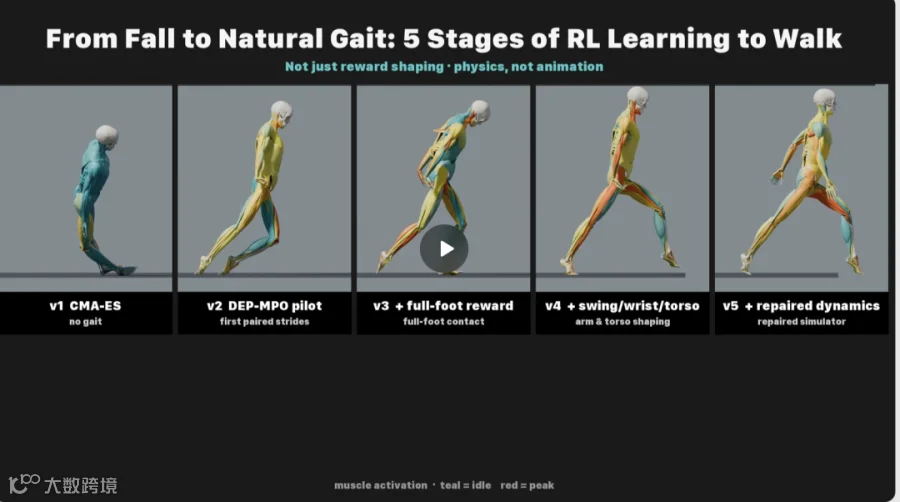
大规模强化学习也强化了 K3.1 Pro 的长周期编码能力。一项内部测试中,它基于开源人体解剖模型human‑atlas(包含 296 块骨骼含软骨、402 块肌肉)搭建人体行走动力学模拟器,附带完整训练与评估流水线。一共执行 167 次任务、420 次独立评审。它分析实验结果,定位问题,迭代优化行走控制器。让原本几秒就会摔倒的虚拟人体,实现交替迈步持续行走 11.2 秒。当奖励塑形策略无法改善手臂运动效果时,K3.1 Pro 没有单纯反复调整奖励参数;而是主动对模拟器动力学做开环探测,定位并修正了 36 处肩部肌肉力臂计算错误,再重新训练控制器。
3D 建模与设计
K3.1 Pro 在 3D 创作、空间推理方面实力强劲。在BenchCAD基准测试(测试根据多视角渲染图生成 CAD 代码实现三维重建能力)中,搭配工具时 K3.1 Pro 得分 92.7%,接近 Claude Opus 5.5(96.2%)与 GPT‑6 Astra(95.9%)。 无论是文本描述、草图还是参考图片,它都能推导出物体形状、比例、空间位置关系,产出可投入使用的 3D 模型。同时它对现有素材库、模型合集的了解也更加丰富。
K3.1 Pro 尤其擅长参数化建模:机械零件、建筑模型、可配置产品、定制家具都可以处理。无需 MCP 连接器,就可以编写并运行 Blender、CAD 软件脚本,完成资产创建、修改部件、调整几何体、材质与场景布局。
Kimi 平台现已上线 3D Make功能。你可以在 Kimi 网页端和 App 预览、编辑 3D 模型;下载支持 3D 打印的文件,也可以导出视频、实况照片用于分享传播。
金融能力
依托更强推理与智能体能力,K3.1 Pro 可以端到端完成整套金融工作流。 在 OfficeQA Pro v2(基于真实金融文档,测试信息检索、跨文档校验、多步数值推理的复杂财税数据分析)取得业界领先的 64.4 分。 在衡量完整投资工作流 —— 从标的筛选到盈利分析的 Frontier Finance 测试集,相比 K3 版本同样有提升。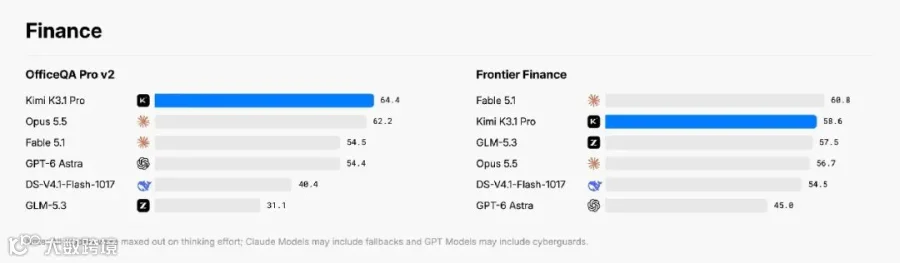
K3.1 Pro 在全部内部金融基准上均有明显进步:
- 金融建模
评估公式关联、金融逻辑、最终工作簿的工程质量。K3.1 Pro 较 K3 提升 7.2 分。 - 金融研究
评估产出可溯源研究报告,满足证据约束、截止时间约束。K3.1 Pro 较 K3 提升 11.6 分。 - 商业运营模拟
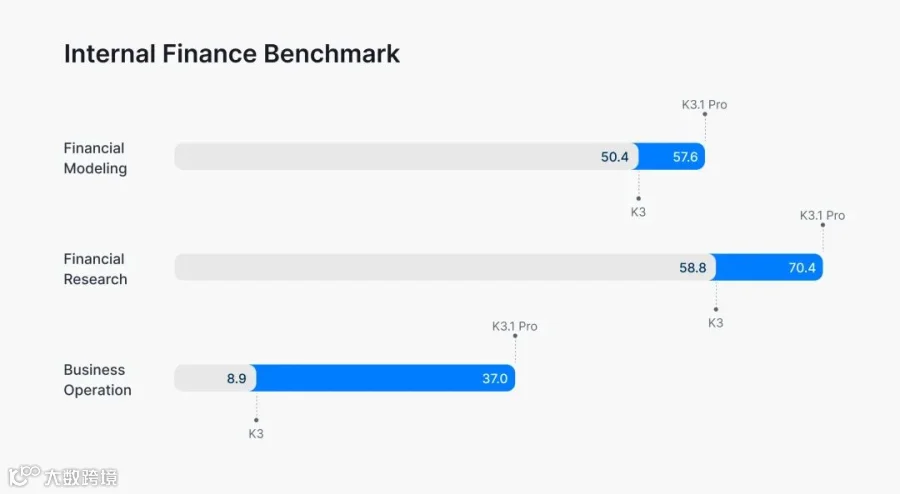 。K3.1 Pro 性能达到 K3 版本的约 4.2 倍。
金融分析、投资研究对事实准确性有极高要求。为此我们针对性优化 K3.1 Pro 在真实业务、高难度提示词场景下的事实可靠性。 内部高压力测试基准 Kimi Hallu Bench Hard 中,声明级幻觉率从 K3 的 23.4% 下降至 8.3%;至少包含一处事实错误的回复占比仅为旧版本的 42.4%。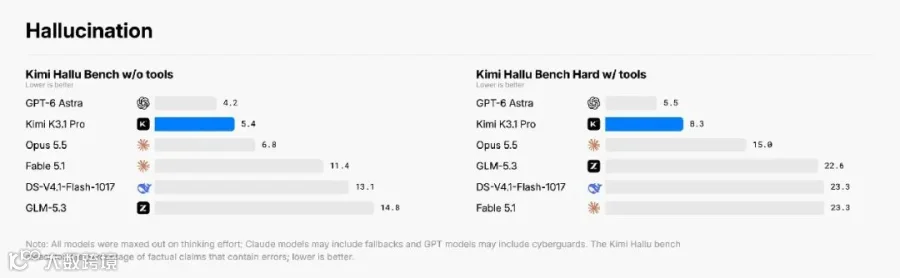
注:该测试是压力测试,专门挑选模型容易出错的场景;该数据不等于日常使用下的整体错误率。
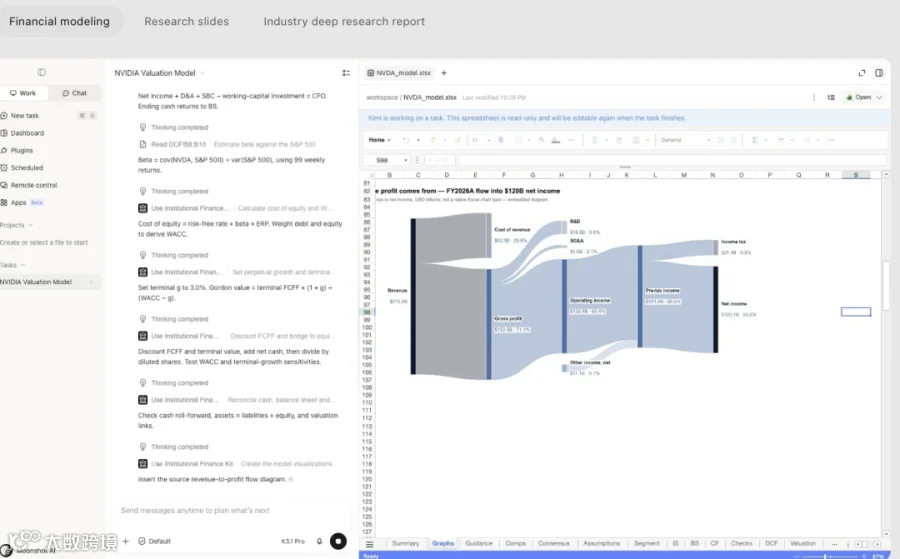
文中案例展示了 K3.1 Pro 如何处理金融建模、投资分析、基于引用来源的调研任务。
网络安全能力
随着 K3.1 Pro 能力增强,我们投入大量精力研究网络安全能力的来源以及可控边界。我们对漏洞挖掘能力开展分析评估;训练过程做针对性管控,在保留通用实用能力的同时降低被滥用的风险。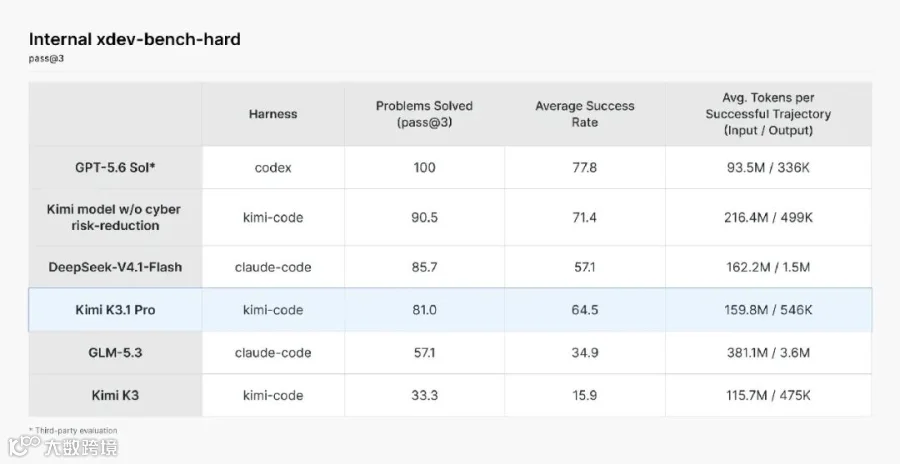
识别并剔除网络安全相关训练数据迭代过程中我们观察到:随着后训练规模扩大,漏洞研究能力同步提升。溯源发现,网络安全相关内容混杂在通用中期训练语料,强化学习环境任务集合中也包含安全类任务,这是大规模训练自然带来的副作用。 初步内部实验表明:如果不在中期训练、强化学习阶段剔除安全相关数据,模型的网络安全能力会大幅上涨。该发现为我们提供了有效的管控抓手。 发布开源权重版 K3.1 Pro 时,我们在上述两个训练环节识别并移除网络安全相关数据,同时保留保障模型可用性的通用编码任务。后续我们会在每一轮训练持续落实该管控手段。
评估结果数据清洗完成后,我们使用内部基准 xdev‑bench‑hard 开展测评。该测试集由专家手工编写,基于源代码的漏洞发现与利用任务;测试样本复现 Linux 内核、Node.js、JavaScriptCore、Exim、VirGL 等软件真实公开漏洞,且全部开启防护措施。任务提供漏洞源代码、简短 bug 提示、对应二进制文件;智能体需要开发漏洞利用程序,在隔离沙箱实现任意代码执行,读取密钥字符串完成自动校验。采用 pass@3 指标,从随机子集采样运行,不设置硬超时、输出 token 上限。
对比对照组(未做安全风险削减,中期训练和强化学习均保留安全数据)pass@3 可解决 90.5% 任务;最终对外发布 K3.1 Pro 版本达到 81.0%。 对比证明,移除相关训练数据,确实降低了模型的网络攻击能力。 与此同时,它相比前代 Kimi K3 仍然有巨大进步,说明即便完成安全数据过滤,更强的通用编码、长周期排错能力依然会迁移到安全相关任务。 K3.1 Pro 的攻击性网络安全能力刻意控制在业界已发布头部闭源模型水平之下。 我们会持续迭代内部评测基准,保证随着模型能力提升评测依然具备参考价值。
开源权重发布理念
-
我们不会发布能够把攻击性网络安全能力推到新高度的开源权重。K3.1 Pro 的攻击性安全能力,被我们设计限制在整套训练流水线理论可达到水平之下,弱于业界前沿闭源模型。 -
我们计划循序渐进提升开源权重模型的安全相关能力。对防御安全工作的从业者来说,能力可控的开源模型有实际价值。当高性能模型权重对外开源、由用户自主掌控运行环境,更多团队(包括缺少专门安全评审的老旧系统)就有条件审计自身代码。我们相信,能力适度向更多人开放,而不是集中在少数闭源厂商手中,从长远看会提升整体软件安全水平。 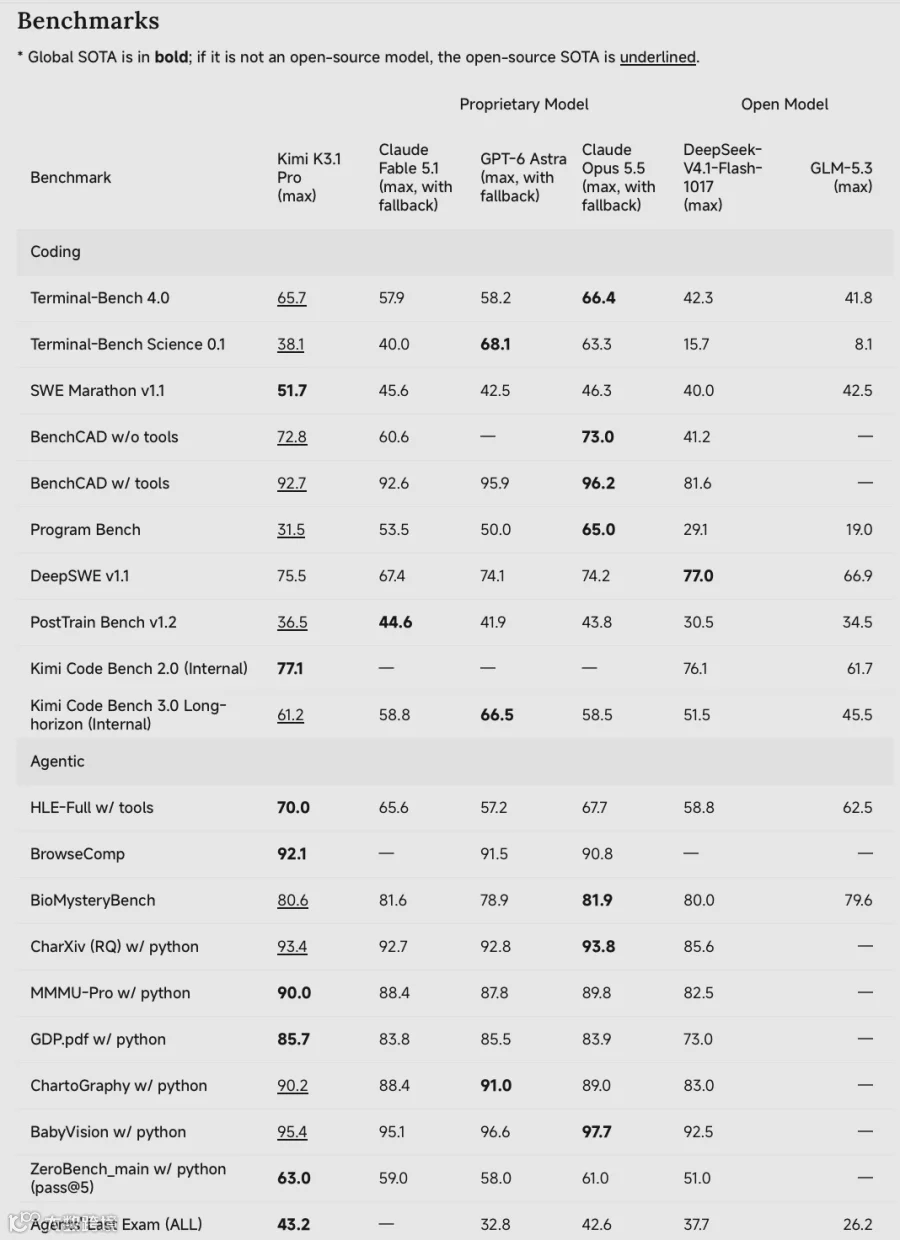
获取渠道
Kimi K3.1 Pro 现已在全线 Kimi 产品上线:Kimi.ai 网页端、Kimi 移动端 App、Kimi Work、Kimi Code,以及 Kimi API。完整模型权重最晚于2026‑11‑04发布。
Kimi 企业版管理员可以为组织开启 K3.1 Pro;发布默认状态为关闭。
各渠道详情:
- Kimi 智能体(Agent)
iOS、安卓、鸿蒙系统更新最新版 App;或访问 kimi.ai。 - Kimi Work 桌面端
下载 3.1.0 及以上版本,支持 Windows 与 Apple 芯片 Mac。 - Kimi Code
运行 Kimi Code,通过 /model命令切换选择 Kimi K3.1 Pro。 - Kimi API
访问 Kimi API 平台,模型代号 kimi‑k3.1‑pro/kimi‑k3.1‑pro‑highspeed;API 客户支持零数据留存模式。 - 企业用户
Kimi Business 提供企业级数据隐私、成员账号管理,企业账号与个人账号完全隔离;访问定价页面选择联系销售订阅团队版。
脚注: 若无特殊说明,本文中 Kimi K3.1 Pro 所有测试分数,推理强度设置为 max,温度 temperature=1.0,top‑p=0.95。