




10 个关键问答 Q&A
- Q:什么是 Agent Harness?
A:包裹大模型的可执行代码,定义提示词、工具集合、上下文管理、任务执行控制流。 - Q:传统全局 Harness 存在什么核心缺陷?
A:一套逻辑服务全部异构任务;某类任务的优化改动,可能降低其他任务性能,发生负迁移。 - Q:OO‑Harness 为什么选用面向对象继承作为核心范式?
A:实现代码复用,专用子类只做局部定制修改,不会破坏父 Harness 已验证有效的逻辑。 - Q:OO‑Harness 训练阶段的任务聚类依据是什么?
A:依据基础 Harness 实际执行轨迹、失败模式,不是人工预先定义任务类别。 - Q:和扁平独立 Harness 家族(AAH)最大区别?
A:AAH 各个 Harness 完全独立,复制代码;OO‑Harness 依靠继承复用,减少冗余代码。 - Q:Harness 路由器输入包含哪些信息?
A:任务描述、基础 Harness 执行轨迹、训练阶段冻结的路由经验库。 - Q:测试时为什么可以回退到基础 Harness?
A:遇到分布外陌生任务,没有适配的专用子类,避免强行套用不相关演化修改,保障 OOD 性能。 - Q:对比 Meta‑Harness 全局优化,OO‑Harness 效率优势在哪?
A:候选 Harness 仅在对应任务聚类评估,不需要跑完整验证集,大幅降低 API 调用成本。 - Q:哪两个组件被消融证明必不可少?
A:①基于继承的层级 Harness 演化;②结合执行轨迹的 Harness 路由。 - Q:OO‑Harness 主要局限性?
A:强依赖运行环境、第三方 API;接口变更会破坏已演化 Harness;私有服务需要安全鉴权配置。
论文 arXiv:2610.28380 [cs.CL],2026‑10‑20
作者:李高棠 ¹*、巴瓦纳・达尔维・米什拉 ²、明逸飞 ²、陈艳飞 ²、朱钟颖 ²、莱斯利・米库利西奇 ²、朗・T・勒 ²、孟睿 ²、李春良 ²、童航航 ¹、李镇宇 ²、托马斯・普菲斯特 ² ¹ 伊利诺伊大学厄巴纳‑香槟分校;² 谷歌云 AI 研究院 * 本研究为李高棠在谷歌云 AI 研究院实习期间完成
摘要
智能体 Harness 是可执行代码,定义大语言模型周边的提示词、工具集合与控制流逻辑。单一的全局 Harness 难以适配异构任务,不同任务需要截然不同的执行策略。本文提出面向对象 Harness(OO‑Harness),一套 Harness 优化框架,借助面向对象设计演化出具备层级结构的可执行 Harness 类。训练阶段,演化智能体利用执行记录生成一系列专用 Harness;每个专用 Harness 通过继承,作为基础 Harness 或其他已有专用 Harness 的子类实现。测试阶段,Harness 路由器利用训练阶段积累的路由经验,为每一个任务挑选最合适的 Harness。
本文在三套长时序基准测试集(业务工作流、工作空间任务、工具调用)开展实验,OO‑Harness 在所有对比方法中取得最优性能,相对基础 Harness 最高绝对提升15.79%。大量消融实验验证了框架各核心组件的贡献。
1 引言
让模型能够处理训练分布之外的任务,是语言智能体领域的核心目标(Xi 等人,2024;Zeng 等人,2023)。近期的基准测试体现出智能体需要应对的任务广度:FutureX 评测智能体借助外部信息预测现实世界事件(Zeng 等人,2025);APEX‑Agents 评估投资银行、管理咨询、企业法务场景下跨应用工作流(Vidgen 等人,2026)。这些任务在工具调用、上下文管理、任务完成校验方面的需求各不相同。智能体 Harness 就是围绕大语言模型,把这些执行选择封装成可执行代码的组件(Yang 等人,2024)。
现有很多工作借助执行反馈,迭代优化可执行代码以及其他 Harness 组件,实现智能体设计与 Harness 优化自动化(Hu 等人,2024;Jiang 等人,2026;Karten 等人,2026;Lee 等人,2026;Lin 等人,2026a;Lou 等人,2026;Nie 等人,2026;Zhang 等人,2025)。例如 Meta‑Harness 利用验证集反馈迭代生成候选程序,从中选出一套全局 Harness(Lee 等人,2026)。但这种方式不能保证:在分布偏移发生时,同一套改动依旧能带来收益。即便在同一个基准集内部,“智能体 Harness 工程” 的组件消融实验表明:增加演化得到的记忆模块会提升困难任务效果,但会降低简单任务性能(Lin 等人,2026a)。EvoHarnessBench 进一步发现,新增工具、技能、专家智能体,甚至会破坏原本已经表现良好的行为(Ke 等人,2026)。
以上研究启发我们:需要构建一批专用 Harness,它们可以共享公共代码,同时保留各自差异化的执行策略;再通过路由器为任务分配对应的 Harness。
既然 Harness 本身就是可执行代码(Ning 等人,2026),面向对象设计就可以很自然地描述 “公共行为” 与 “任务专属行为”。本文提出面向对象 Harness(OO‑Harness),一套 Harness 优化框架,用来演化具备层级关系的可执行类(见图 1)。每一个专用 Harness 继承自基础 Harness 或者其他已有的专用 Harness;子类可以重写继承来的方法,也可以新增自定义方法。
训练流程:首先基于基础 Harness 的执行记录,把验证集任务按照执行需求做聚类。演化智能体反复迭代:选定一个任务聚类与父 Harness,创建子类,然后在该聚类的任务上评估子类。执行反馈会指导后续迭代优化,并沉淀为设计经验与路由经验。这套设计有两大优势:
- 高效性
仅在目标聚类上评估候选 Harness,不需要在全部验证集上重复运行; - 泛化性
针对特定任务的改动不会破坏基础 Harness 和其他已学习的 Harness;面对新任务,可以选用适配的 Harness,不会被无关改动干扰。
测试流程:借助多态特性,执行器通过统一接口运行被选中的 Harness。Harness 路由器接收任务本身、基础 Harness 的可观测执行轨迹,再结合训练得到的路由经验,选择一个专用 Harness,或者直接复用基础 Harness 的输出。部署前,Harness 层级结构和经验库全部冻结;训练、测试全程,执行器大模型权重保持不变。
也有同期工作研究面向任务的 Harness 选择机制。Adaptive Auto‑Harness 通过 Git 分支在多个专用 Harness 之间完成任务路由(Liu 等人,2026b)。与之不同,OO‑Harness 依靠继承机制实现 Harness 之间代码复用,同时结合类描述、可观测的基础执行轨迹、训练得到的路由经验共同完成选择。
本文选用 AutomationBench、Workspace‑Bench、Toolathlon‑GYM 三套数据集开展评测,OO‑Harness 取得所有对比方法里的最优主指标得分。
本文主要贡献
-
提出一套 Harness 表示范式:依靠继承、方法重写、新增方法实现代码共享与任务专属行为; -
实现演化框架:从执行记录中学习专用 Harness 与路由经验,支持按任务做 Harness 选择; -
在三套长时序智能体基准上取得优异实验结果,消融实验完整验证各个组件价值。 
图 1 Harness 适配的三种架构。(a) 全局 Harness:全部任务共用同一套实现;(b) 扁平 Harness 家族:路由器在多个互相独立的 Harness 实现里做选择;(c) OO‑Harness:Harness 之间依靠继承实现代码复用,路由器从继承层级中挑选 Harness。绿色箭头代表继承,虚线箭头代表选择,黑色实线代表执行。
2 相关工作
自演化智能体
自演化智能体利用执行经验,迭代优化提示词、记忆、技能以及其他持久化组件。GEPA 反思交互轨迹,优化提示词(Agrawal 等人,2025);ReasoningBank 把成功、失败的经验提炼成可复用记忆(Ouyang 等人,2026);AEvolve 对智能体持久状态做可控更新(Lin 等人,2026b);HASP 把技能封装为可执行函数,用来修改动作、补充修正上下文(Liu 等人,2026a)。以上自适应技术都可以作为 Harness 演化的底层模块。OO‑Harness 的创新在于:通过继承演化一批专用 Harness,并使用路由器为每个任务分配 Harness。
Harness 自动演化
很多现有工作依靠代码搜索、执行反馈自动构建、迭代 Harness,代表工作有 Meta‑Harness(Lee 等人,2026)、Agentic Harness Engineering(Lin 等人,2026a)、HarnessEvolve(Jiang 等人,2026)。但这些方法主要优化单一全局 Harness:对一类任务有效的改动,可能损害另一类任务。HarnessDev 专门评测 Harness 的构建与演化(Wu 等人,2026);EvoHarnessBench 证实,盲目扩充工具、技能、专家智能体,会让原本有效的行为退化(Ke 等人,2026)。
同期工作研究跨任务、跨部署环境的自适应:Adaptive Auto‑Harness 借助 Git 分支与变基实现工作空间内容的共享与定制(Liu 等人,2026b);EvolveNet 把分布式部署得到的自适应结果合并进全局 Harness(Nie 等人,2026)。表示层方面,NOOA 提出一套编程模型,把智能体原生表达为 Python 对象(Furgale 等人,2026)。
OO‑Harness 和它们的区别:我们演化一套具备继承层级的可执行 Harness 类,支持继承、重写、新增方法;Harness 路由器结合训练沉淀的路由经验、类描述、任务文本、基础执行轨迹完成 Harness 选择。
3 方法
3.1 问题设定与总览
Harness 封装执行器(大语言模型M)外围的提示词、工具、执行规则(Ning 等人,2026)。OO‑Harness 在验证任务集上迭代 Harness 代码,大模型M全程固定不变;之后在完全不相交的测试任务集上,使用冻结后的 Harness 评估泛化性能(见图 2)。
这一点和 Meta‑Harness 的 TerminalBench‑2 实验不一样:Meta‑Harness 用同一批任务做搜索与最终评估(Lee 等人,2026)。把演化用任务和评估任务分开,对于衡量模型在搜索集之外的泛化能力至关重要(Wang 等人,2026)。
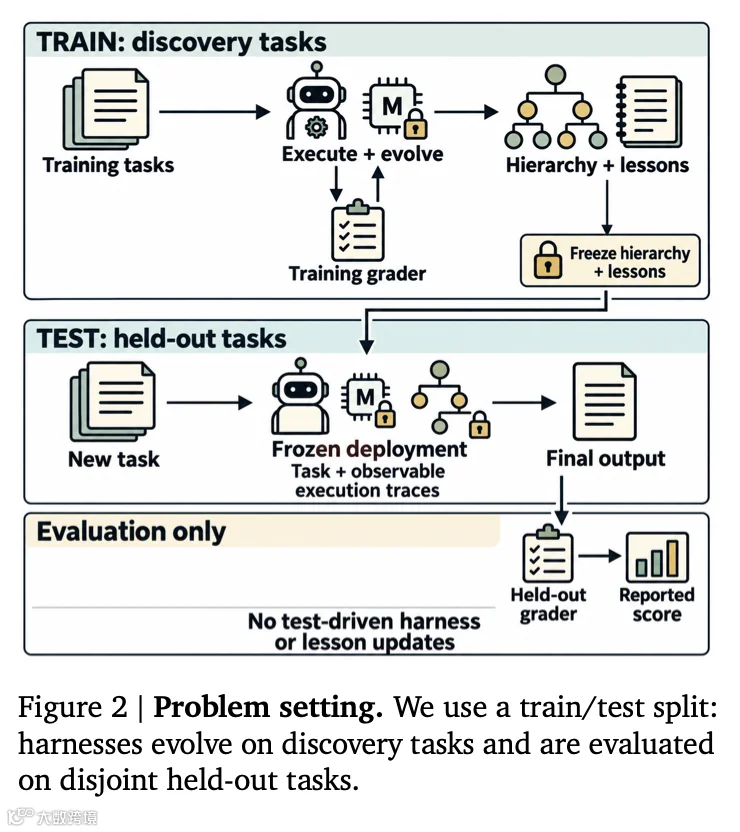
图 2 问题设定。采用训练‑测试划分:Harness 在验证任务上演化,在完全隔离的留出测试集上评估;测试阶段不会更新 Harness 和经验库。
\(T_H\)代表 Harness 层级结构,存储完整 Harness 类,起点为基础 Harness \(H_0\)。每个子类继承父类全部方法,可以重写已有方法、增加全新方法。任务聚类c把执行需求相近的验证任务归为一组;\(D_c\)为聚类c内的验证任务,\(H_c\)为该聚类当前选用的 Harness。任务聚类用来组织任务证据;层级结构用来组织可复用 Harness 代码。
- 演化智能体\(\pi\)
基于验证任务证据生成候选子类; - Harness 路由器\(\rho\)
选择基础 Harness 或者某一个专用 Harness(见图 3)。
执行记录\(\varepsilon\)保存候选代码、验证任务交互轨迹、运行结果、成功 / 失败案例的反思总结。开启经验存储后,系统会把执行记录提炼成两类经验:
- 设计经验\(L_\pi\)
指导后续代码修改; - 路由经验\(L_\rho\)
指导 Harness 选择。
两类经验都在验证阶段积累,部署后冻结。路由器本身大模型权重不训练;训练只改变路由器参考的证据库。

图 3 OO‑Harness 训练与测试完整流程。 1)初始化:运行基础 Harness 得到轨迹,构建初始任务聚类; 2)演化迭代:演化智能体生成子类,在聚类任务上评估,利用执行反馈更新经验库; 3)部署冻结:Harness 层级、类描述、路由经验全部冻结,用于测试; 4)测试阶段:路由器读取任务、基础 Harness 执行轨迹、冻结路由经验,选择专用 Harness 或者复用基础 Harness 结果。测试阶段不会更新任何内容。
3.2 Harness 层级的表示:接口与继承
Harness 演化操作对象是可执行类定义与配套源码。智能体可以修改提示词、工具、上下文管理、执行控制逻辑,新增自定义方法;在框架支持的前提下,还可以配置中间件、文件后端、子智能体。生成的子类必须兼容框架统一执行接口。
子类复用继承得到的方法,同时可以重写方法、增加新方法;重写时可以通过super()调用父类方法。图 1 展示层级结构;附录代码片段展示继承关系。
⚠️执行实例说明:路由器选择一个完整 Harness 类,全部方法在同一个实例内部执行;父类不会单独启动一轮智能体运行。方法内部可以依据运行时信息做条件分支,例如工具反复报错、输出产物未完成等。
3.3 训练阶段初始化
-
在验证任务集合\(D_{tr}\)上运行基础 Harness \(H_0\),保存交互轨迹与评估反馈。 -
把任务聚类:将那些基础 Harness 运行结果显示 “适合同一套 Harness 改动” 的任务分到同一个聚类c,得到任务子集\(D_c\)。每个聚类记录共同执行需求,初始选用 Harness 全部为\(H_c=H_0\);初始层级\(T_H=\{H_0\}\)。
3.4 训练迭代流程
每一轮迭代,演化智能体拥有文件读写权限,可以读取 Harness 源码、任务聚类、全部执行记录;可以读取文件、调用子智能体做分析,编写编辑候选代码。执行步骤:
-
选定目标聚类和父类 Harness,明确改动目标,实现可执行子类;成功、失败的候选全部留存,可供后续查阅。 -
在目标聚类任务集合\(D_c\)上,用固定大模型M运行候选 Harness \(H'\)。记\(S_c(H')\)为候选在该聚类得分;\(S_c^{current}\)是聚类当前在用 Harness 得分。候选的父类不必等于聚类当前使用的 Harness。只在目标聚类评估,不需要跑完整验证集,节约开销。 -
接受条件:当\(S_c(H')>S_c^{current}\),同时满足基准集专属校验条件,则接纳新子类\(H'\);否则拒绝。校验条件参考单任务运行结果与执行反馈;模糊场景可引入判定智能体。 -
被接纳的子类加入层级集合\(T_H\),可以成为该聚类新的选中 Harness \(H_c\)。所有运行结果都会用于后续迭代、更新经验库。候选只需要在目标聚类取得提升,不需要在全部任务变好。父类依旧保留可复用,可以独立被选中,不会被子类覆盖。
反复被拒绝的聚类会降低搜索优先级,让演化优先探索其他任务分组。每一轮迭代都会重新审视聚类划分:依据执行反馈,可以重新分配任务、拆分或者合并聚类(多次修改都无法提升性能时尤其需要)。算法 1 完整总结演化逻辑,附录 A.4 提供实现细节。
算法 1:验证任务上 Harness 演化算法 输入:基础 Harness\(H_0\),固定大模型M,验证任务\(D_{tr}\),迭代预算T
-
在\(D_{tr}\)运行\(H_0\),保存全部执行记录 -
初始化层级\(T_H\),全部聚类初始 Harness \(H_c \leftarrow H_0\) -
for i = 1 … T: 4. 根据执行记录生成 / 调整任务聚类\(\{D_c\}\) 5. 演化智能体\(\pi\)选择聚类c以及\(T_H\)中的父 Harness 6. 构建子类\(H'\):重写或新增方法 7. 在\(D_c\)运行\(H'\),收集得分与反馈 8. 对比任务结果,执行接纳校验 9. 保存被接纳的\(H'\);如果效果更优就更新聚类的\(H_c\) 10. 根据接纳历史调整聚类搜索优先级 11. 保存全部运行结果;开启经验库时提炼设计、路由经验 -
end for 输出:冻结层级\(T_H\),各聚类 Harness\(\{H_c\}\),执行记录,经验库
3.5 测试阶段:选择与执行
对于新任务t,路由器读取基础 Harness 运行轨迹\(\omega(t)\),做选择: \(H^{*}=\rho\left(t, \omega(t),\left\{H_{0}\right\} \cup\left\{H_{c}\right\}_{c \in C}, \mathcal{L}_{\rho}\right)\)
路由器输入:类描述、适用条件、冻结的路由经验。
-
如果选出\(H^{*}=H_0\),直接复用基础 Harness 输出; -
否则实例化\(H^{*}\),运行继承逻辑加上定制化逻辑。
整个留出测试集运行过程中,层级结构、证据库完全固定。测试阶段,打分器得分、判定结果、标准答案都不会提供给路由器与执行器。
4 实验
4.1 实验设置
基准数据集与评价指标
- AutomationBench
业务工作流;300 条验证任务,300 条留出测试任务;确定性打分器评估任务完成。 - Workspace‑Bench(Lite‑100)
跨文件、跨应用办公任务;288 验证,100 留出测试;依据任务定制评分细则打分。 - Toolathlon‑GYM
多工具任务完成;251 验证,252 留出测试。
指标说明(全部以百分比报告)
- Mean
AutomationBench 为平均部分得分;Workspace‑Bench 为微平均评分细则通过率;Toolathlon‑GYM 为平均奖励; - PASS 严格成功
AutomationBench / Toolathlon‑GYM 要求奖励≥0.999;Workspace‑Bench 需要满足全部评分细则。
主指标:AutomationBench、Workspace‑Bench 看 Mean;Toolathlon‑GYM 看 PASS。
对比基线
-
Base:未经过演化的原始基础 Harness; -
全局 Harness 优化:Meta‑Harness、AHE(Agentic Harness Engineering); -
专用 Harness 家族:AAH(Adaptive Auto‑Harness); -
测试时增强基线(不做训练,仅推理阶段增强):并行 best‑of‑K 采样(K=2、5)、串行自精调 K=2。参考 Wang 等人 (2026);仅使用可观测轨迹,不访问打分器。
全部方法使用同一个执行器gemini‑3.5‑flash,严格遵循各数据集原生执行协议。所有 Harness 优化方法统一使用Claude Opus 4.8作为演化智能体,最多 40 轮迭代;OO‑Harness 路由器使用Claude Sonnet 5。留出测试阶段所有 Harness、经验库冻结;打分器输出仅用于最终统计分数。每个方法、每个数据集独立跑 3 次,报告均值 ± 标准差。Steps:只统计最终被选中轨迹的平均步数,不计其他采样、选择调用。
4.2 主要实验结果
见表 1,OO‑Harness 在三套基准的主指标全部取得最优。实验结果证明面向对象编程范式非常适合基于代码的 Harness 演化:继承复用已有行为,重写、新增方法实现任务定制。在 AutomationBench 上,OO‑Harness 同时拥有最低平均轨迹步数。
另外可以观察:测试阶段并行采样、串行自精调,性能并不能稳定提升。仅仅增加推理轮次无法稳定带来收益;也体现出本训练流水线学习任务适配 Harness 的价值。
全局优化 vs 层级化优化(Meta‑Harness 对比 OO‑Harness)
Meta‑Harness 训练得到单一全局 Harness;OO‑Harness 针对聚类演化一套层级化专用 Harness。两者都是测试前冻结代码;Meta‑Harness 同一个 Harness 跑全部任务;OO‑Harness 动态从层级里挑选。图 4 对比三点优势:
- 训练收敛
OO‑Harness 前期收益更大; - 训练效率
搜索耗时显著缩短(只在聚类评估候选,减少 API 调用与开销); - 泛化性能
留出测试集得分更高。

图 4 Meta‑Harness(全局)对比 OO‑Harness(层级化)。(a) 训练收敛曲线;(b) 平均搜索耗时;(c) 留出测试集平均得分。
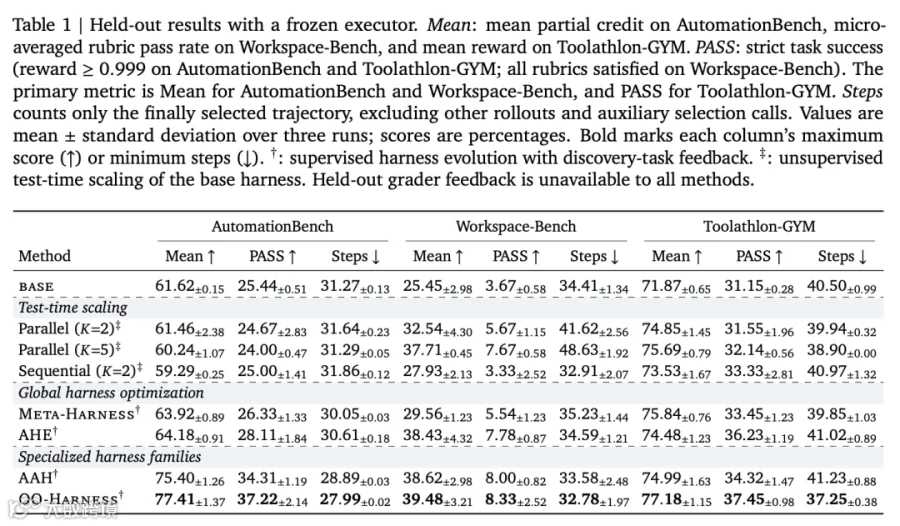
表 1 留出测试集完整结果(执行器模型冻结)。加粗代表该列最优得分或最小步数。†:使用验证集反馈做 Harness 演化;‡:仅对基础 Harness 做测试时增强。测试阶段打分器反馈对所有方法不可见。 | 方法 | AutomationBench | | | Workspace‑Bench | | | Toolathlon‑GYM | | | | --- | --- | --- | --- | --- | --- | --- | --- | --- | --- | | | Mean | PASS | Steps | Mean | PASS | Steps | Mean | PASS | Steps | | base | 61.62±0.15 | 25.44±0.51 | 31.27±0.13 | 25.45±2.98 | 3.67±0.58 | 34.41±1.34 | 71.87±0.65 | 31.15±0.28 | 40.50±0.99 | | 测试时增强| | | | | | | | | | | Parallel(K=2) ‡ | 61.46±2.38 | 24.67±2.83 | 31.64±0.23 | 32.54±4.30 | 5.67±1.15 | 41.62±2.56 | 74.85±1.45 | 31.55±1.96 | 39.94±0.32 | | Parallel(K=5) ‡ | 60.24±1.07 | 24.00±0.47 | 31.29±0.05 | 37.71±0.45 | 7.67±0.58 | 48.63±1.92 | 75.69±0.79 | 32.14±0.56 | 38.90±0.00 | | Sequential(K=2) ‡ | 59.29±0.25 | 25.00±1.41 | 31.86±0.12 | 27.93±2.13 | 3.33±2.52 | 32.91±2.07 | 73.53±1.67 | 33.33±2.81 | 40.97±1.32 | |全局 Harness 优化| | | | | | | | | | | Meta‑Harness † | 63.92±0.89 | 26.33±1.33 | 30.05±0.03 | 29.56±1.23 | 5.54±1.23 | 35.23±1.44 | 75.84±0.76 | 33.45±1.23 | 39.85±1.03 | | AHE † | 64.18±0.91 | 28.11±1.84 | 30.61±0.18 | 38.43±4.32 | 7.78±0.87 | 34.59±1.21 | 74.48±1.23 | 36.23±1.19 | 41.02±0.89 | |专用 Harness 家族| | | | | | | | | | | AAH † | 75.40±1.26 | 34.31±1.19 | 28.89±0.03 | 38.62±2.98 | 8.00±0.82 | 33.58±2.48 | 74.99±1.63 | 34.32±1.47 | 41.23±0.88 | | OO‑Harness † |77.41±1.37|37.22±2.14|27.99±0.02|39.48±3.21|8.33±2.52|32.78±1.97|77.18±1.15|37.45±0.98|37.25±0.38|
5 分析实验
消融两大核心组件:①基于任务 + 执行轨迹的 Harness 路由;②依靠继承实现层级化 Harness 演化。再结合案例研究分析基础 Harness 复用、任务聚类、Harness 具体改动;最后构造分布外 OOD 场景测试。
5.1 消融实验
5.1.1 Harness 路由消融
固定整套 Harness 库、执行器、打分器、测试划分;只改变路由器输入。两组对比:
- 仅任务信息路由
只用任务描述与元数据;置信度≥0.7 才选用专家 Harness,否则回退基础 Harness; - 任务 + 基础执行轨迹路由
额外读取基础 Harness 运行轨迹。 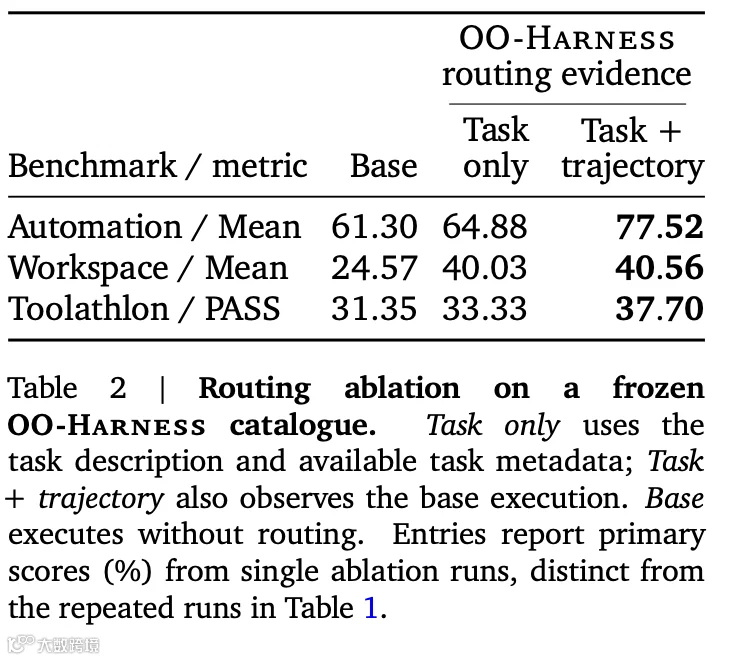
表 2 路由消融实验(单次运行,和表 1 多轮重复实验区分) | 数据集 / 主指标 | Base | 仅任务信息 | 任务 + 轨迹 | |---|---|---|---| | Automation / Mean | 61.30 | 64.88 | 77.52 | | Workspace / Mean | 24.57 | 40.03 | 40.56 | | Toolathlon / PASS | 31.35 | 33.33 | 37.70 |
可以看到:执行轨迹带来的收益随数据集变化。AutomationBench 平均部分得分提升 12.64 点;Toolathlon‑GYM 的 PASS 提升 4.37 点;Workspace‑Bench 仅有 0.53 点提升。
原因分析:Workspace‑Bench 学到的聚类标签和任务类型强绑定(文档写作、表格编辑),任务文本本身就足以做路由;AutomationBench、Toolathlon‑GYM 很多 Harness 解决跨领域的执行故障:例如漏写输出、工具调用预算耗尽无法收尾。基础执行轨迹能够暴露这些故障,路由器据此选择修复该故障的 Harness。
5.1.2 层级演化结构消融(继承的价值)
在 Workspace‑Bench 对比三种 Harness 学习模式;路由逻辑、执行器、任务划分、搜索预算全部保持不变,只改变 Harness 代码复用方式:
- OO(继承模式)
子类继承已有演化出来的 Harness,重写 / 新增方法; - Flat 扁平拷贝模式
所有子类都直接继承 Base;需要复用时,把旧 Harness 完整代码复制粘贴进新类,不使用继承语法; - Base‑reset 重置模式
每个候选全部直接继承 Base,完全不复用之前演化得到的代码。
结果见图 5:OO 取得 40.56% 微平均评分通过率,高于 Flat(高 4.96 个点);Flat 又优于 Base‑reset。Flat 已经实现代码拷贝复用,OO 相对 Flat 的优势直接证明:面向对象继承组织代码本身就能带来性能增益。

图 5 Workspace‑Bench 继承消融对比:Base‑reset、Flat 拷贝复用、OO 继承。纵轴微平均评分细则通过率。
5.2 案例研究
基础 Harness 的复用行为
OO‑Harness 只有路由器选中专用 Harness 的时候,才会重新运行任务;否则直接复用基础 Harness 输出结果。AutomationBench 一组 300 任务实验:134 条任务(44.7%)直接复用 Base;166 条任务分配给专用 Harness。

表 3 AutomationBench:按路由目标分组,原始 Base 性能 | 路由去向 | 任务数量 | Base 原始平均奖励 | Base 原始严格 PASS | |---|---|---|---| | 复用 Base | 134 | 77.15% | 36.57% | | 使用专用 Harness | 166 | 44.40% |14.25% |
被分配给专用 Harness 的任务,原本基础 Harness 效果显著更差;路由器把定制能力定向分配给 “基础 Harness 跑不好” 的任务;原本基础 Harness 表现好的任务直接复用结果,避免不必要重新运行。路由经验负责把观测到的执行故障匹配对应的专用 Harness。
任务聚类如何反映执行需求
演化智能体基于执行记录生成、修改聚类,不需要预先给定领域 / 任务分类体系。见图 6:
-
AutomationBench:聚类更多捕捉轨迹暴露出的故障与修复需求,例如缺少写入提交、需要跨业务域计算校验; -
Workspace‑Bench:学到聚类和任务类型高度对齐,例如文档编写、表格编辑。当任务输出格式一致,后端需求往往也一致,任务类型聚类自然浮现。
路由经验示例:观测到反复 SQL 查询解析错误 → 匹配路由经验 → 选择 API 错误归一化 Harness,自动生成查询修复提示。
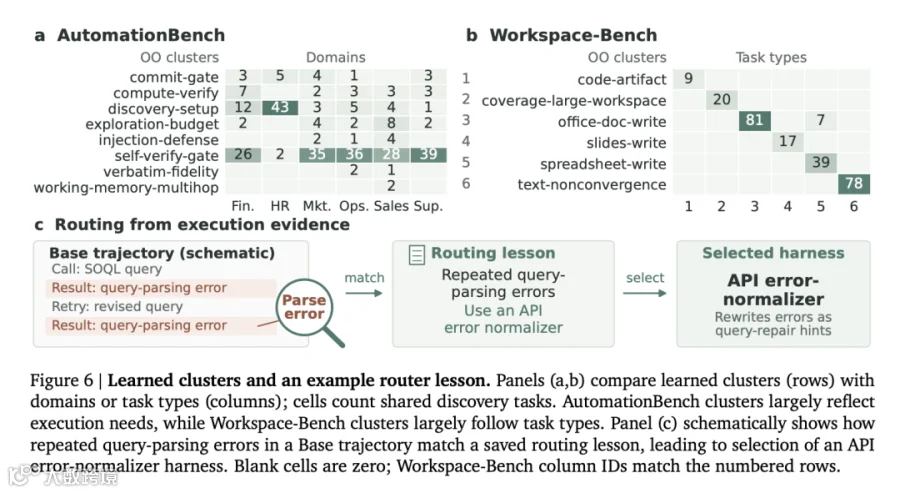
图 6 学到的任务聚类与路由案例。(a) AutomationBench 聚类(行)vs 业务域(列);(b) Workspace‑Bench 聚类 vs 任务类型;(c) 路由示意图:基础轨迹出现查询解析错误,匹配路由经验,选中 API 纠错 Harness。
Harness 具体修改案例
继承既保留公共逻辑,又实现针对性定制。AutomationBench 的discovery‑setup继承链:在 “检测漏写” 完成校验基础上,叠加预算临近提醒,再叠加工具错误引导;每一个节点都是完整可执行 Harness。父类保留完整能力,依然可以服务不需要子类新增逻辑的任务。附录展示 Workspace‑Bench 文档后端定制案例。
5.3 分布外场景下的 Base 复用
为测试极端分布外 OOD,在 Toolathlon‑GYM 构建特殊划分:训练集应用家族与测试集应用家族完全不重叠。训练:Google Workspace、Notion 等;测试:Amazon、GitHub、Kubernetes、MySQL、Yahoo Finance 等。
训练完成后测试:Meta‑Harness 强制使用训练得到的全局 Harness 跑全部测试任务;OO‑Harness 路由器对全部测试任务选择回退 Base。实验结果:OO‑Harness 复用 Base,保留原始性能;Meta‑Harness 把训练学到的全局 Harness 直接套用在完全陌生应用,PASS 下降。
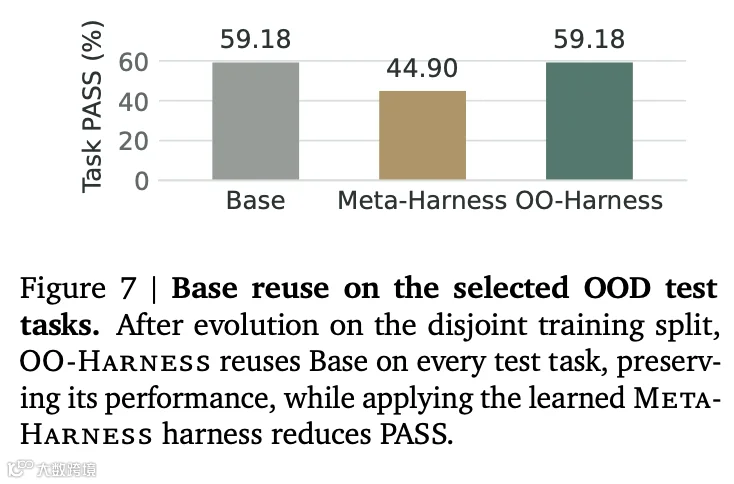
结论:把 Base 保留为可选项,OO‑Harness 遇到完全陌生任务,不会强行套用训练得到的专用改动。
6 总结
OO‑Harness 借助继承演化得到一批专用 Harness,结合执行轨迹证据完成任务路由。任务聚类捕获共同执行需求;继承机制实现代码复用与行为定制。在三套基准测试集取得最优结果;消融实验验证继承、轨迹路由两大组件有效性;案例展示专用 Harness 的定制能力和基础 Harness 回退复用的价值。
局限性
OO‑Harness 依赖宿主平台提供 API 与运行环境。服务宕机、限流会影响稳定性;接口变更需要同步更新演化出来的 Harness。对接私有、需要鉴权的服务,需要安全凭证管理与权限配置。未来可以进一步研究跨环境部署、鲁棒 API 集成。
参考文献(略)
附录(精简翻译,关键部分)
A 实现与评估细节
A.1 模型配置
-
演化智能体全部使用 Claude Opus 4.8; -
固定执行器:gemini‑3.5‑flash;
Harness 演化只修改执行器外围代码,大模型权重完全不动。
A.2 通用训练配置
每个数据集最多 40 轮演化迭代;候选评估只在验证任务;测试前全部冻结。
A.3‑A.8 各数据集配置、基线实现、消融参数、OOD 划分、许可证说明(略)
A.4 OO‑Harness 实现要点
- 演化工作区
演化智能体作为编码智能体,拥有文件读写权限,可以读取历史轨迹、反馈、源码,输出子类代码; - 演化提示词核心指令
读取轨迹,定位可通过 Harness 修复的共性问题;写子类,调用 super()保留父行为;禁止硬编码任务 ID 与答案;输出 JSON 清单; - 路由器提示词
只允许读取任务、基础轨迹、冻结经验;没有明确适配方案时选 Base;输出 JSON:选择、对应规则、理由; - 继承代码示例(Toolathlon)
class FormulaLiteralHarness(BaseHarness):
    def manage_context(self, messages, state):
        messages = super().manage_context(messages, state)
        return pin_literals_if_needed(messages, state)

class PercentCheckHarness(FormulaLiteralHarness):
    # 继承父类manage_context,不重写
    def verify_before_finish(self, messages, state):
        parent = super().verify_before_finish(messages, state)
        if parent:
            return check_saved_percent_values(messages, state)
        return parent
子类
PercentCheckHarness继承父类上下文管理逻辑;重写收尾校验方法,先调用父类校验,再新增百分比单元格检查。
B 案例研究
B.1 Workspace‑Bench:生成 Word 文档
基础 Harness 调用write_file("report.docx",text)只会把纯文本 UTF‑8 写入文件;后缀是 docx,但并不是真正二进制 Word 文档。专用office‑doc‑writeHarness重写文件后端 write () 方法,将文本渲染为合法二进制 docx 文档。渲染失败自动回退父类逻辑。任务描述里就可以看到输出后缀,所以仅任务元数据路由效果就很好。
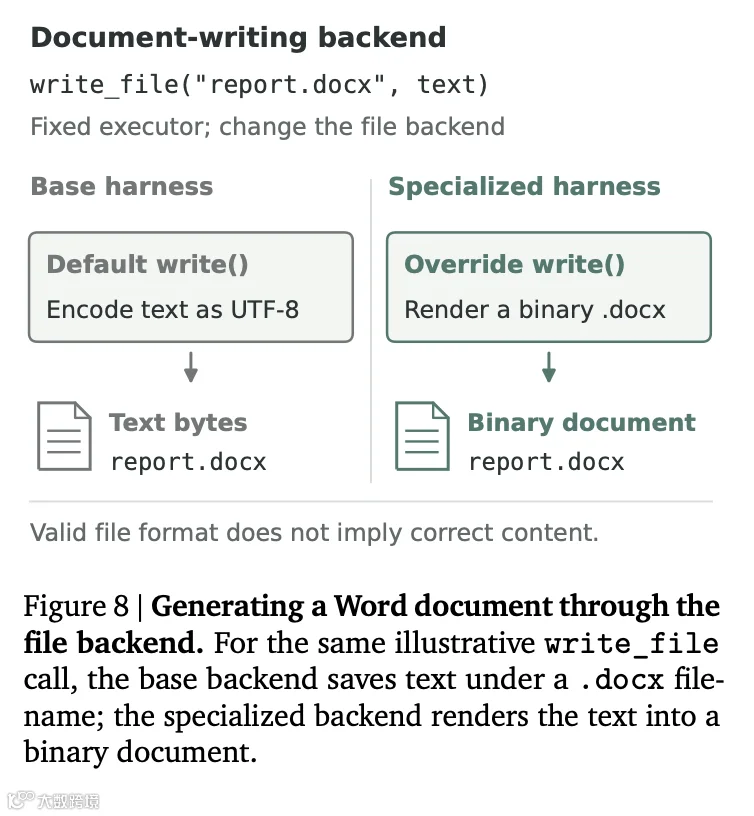
图 8 文档写入后端对比:Base 直接写文本字节;专用 Harness 重写 write 函数渲染二进制 docx。
B.2 AutomationBench:继承式校验与路由经验
业务工作流经常出现:智能体只读、查询,没有执行写操作就直接结束任务。
-
s9:收尾前校验,如果还没有写操作,强制多一轮执行机会; -
s12:继承 s9;在步数预算快要耗尽时,如果依旧没写成功,给出提醒; -
s29:继承 s12;新增不可恢复工具错误的修正提示。 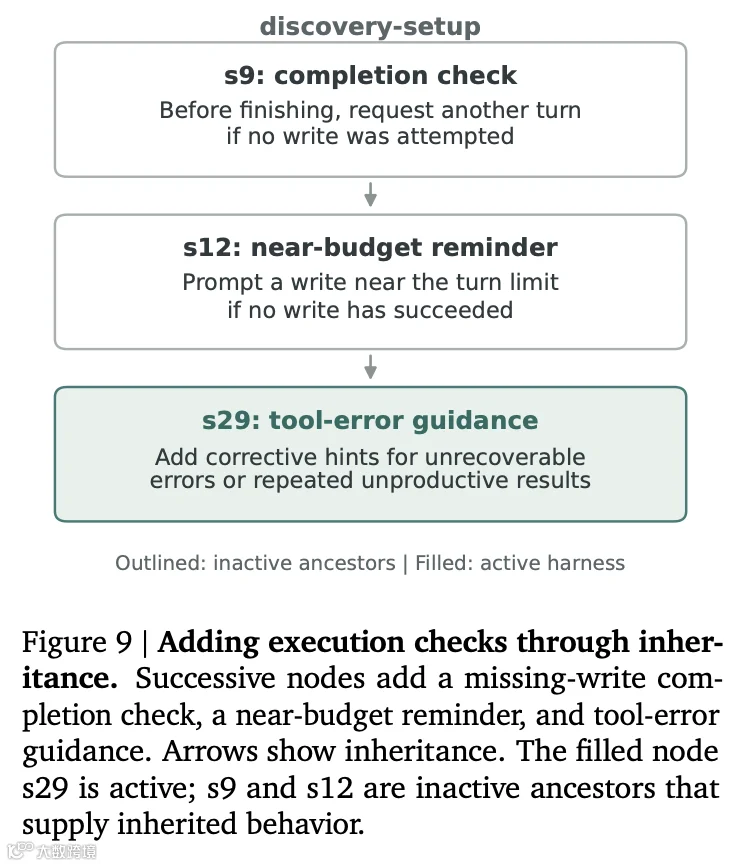
图 9 继承链:s9→s12→s29;不断叠加完成校验逻辑。
路由案例(表 4)
-
案例 1:多次 401/404 连接错误,没有任何写操作;匹配经验→选择资源清单 Harness,输出服务资源信息辅助 API 调用; -
案例 2:三次成功写入,无报错;匹配经验→直接复用 Base 结果。
B.3 Toolathlon‑GYM:输出校验
聚类可以跨多个应用。excel‑formula‑literal Harness 继承原有逻辑,新增校验:读取保存的 Excel,识别百分比单元格 0‑1 浮点数,自动提醒修正为百分比整数。
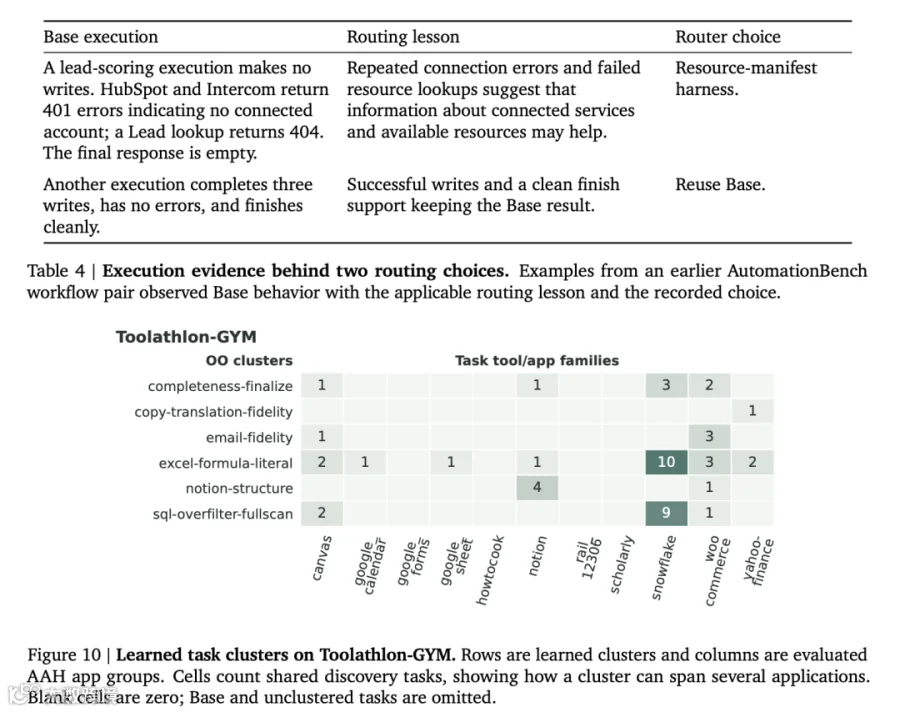
图 10 Toolathlon‑GYM 学到聚类,一行代表聚类,一列代表应用家族,可以看到一个聚类会覆盖多个不同应用。