


编者摘要:OpenResearcher(EMNLP2026)提出一套面向 AI 智能体的能力蒸馏方案,核心是蒸馏深度研究的工具行为轨迹,而非知识或答案,解决复杂多跳研究任务难以采集示范数据的痛点。
传统模型蒸馏适合输入输出边界清晰的任务,而深度研究需要反复检索、阅读文献、交叉校验证据,人工标注轨迹成本极高;直接联网录制轨迹存在费用昂贵、网页动态变化、实验不可复现等问题。该团队搭建离线封闭考场,收集数千道种子题配套证据文档,混合千万级公开网页构建固定本地检索库,规避公网不稳定问题。
以 GPT-OSS-120B 作为教师模型,赋予搜索、打开网页、页内查找三类基础工具,使用 64 张 H100 运行约两天,生成近十万条完整研究轨迹。再对 30B 基座(推理仅激活 3B 参数)做监督微调,几块显卡一晚即可完成训练。在 BrowseComp-Plus 离线评测中,该小模型取得 54.8 分,高于同环境下 GPT-4.1、Claude-4-Opus 约 36 分的成绩。消融实验证实,即便使用教师失败轨迹训练,模型依旧高分,证明其学习的是检索重试、证据定位的行动策略,而非死记答案。
该方案存在明显局限:模型效果高度依赖固定离线文档库,脱离封闭考场进入真实互联网,性能大幅下滑;能力上限被教师模型锁定,数据集为非商用授权。
产业层面,智能体时代的核心资产从模型权重转向高质量行为轨迹生成管线。
企业自建管线需同时满足场景高频复用、可自动判分、瓶颈为检索决策、信息环境可固定打包四项条件;开放互联网场景,直接调用商用大模型接口更稳妥。

OpenResearcher 10 个关键问题 Q&A
- Q:OpenResearcher 蒸馏的是模型知识还是答案?
A:都不是。它蒸馏深度研究智能体的工具调用行为轨迹,学习如何搜索、翻页、定位证据、检索失败后换词重试这套行动策略,而非背诵题目答案。 - Q:为什么不直接采集人类做研究的操作轨迹?
A:长程多跳研究轨迹人工标注成本极高,很难规模化产出数十万条高质量完整示范数据,工程上不可行。 - Q:为什么不直接连真实互联网录制教师模型轨迹?
A:公网搜索接口成本昂贵;网页会更新、失效,检索结果不稳定,训练实验无法稳定复现。 - Q:教师模型、学生模型分别是什么,算力消耗如何?
A:教师为 GPT-OSS-120B,64 张 H100 跑约 2 天生成近 10 万条轨迹;学生是 30B 基座,推理仅激活 3B 参数,几块显卡一晚就能完成 SFT 微调。 - Q:训练过程需要强化学习 RL 吗?
A:不需要。仅使用监督微调(SFT)做行为克隆,没有在线试错的 RL 环节。 - Q:小模型高分,是不是死记硬背题库里的答案?
A:不是。消融实验显示,只用教师模型做错的失败轨迹训练,小模型依然能拿到相近高分,证明学到的是研究策略,不是背题。 - Q:为什么 GPT-4.1 在这个离线评测基准分数反而偏低?
A:GPT-4.1 本身推理能力很强,在有完整黄金文档时准确率很高;短板是没有养成持续检索、排查证据的智能体工具使用习惯。 - Q:这套模型放到真实互联网环境效果怎么样?
A:性能大幅衰减。离开固定离线考场,在真实动态互联网评测得分明显下降,单纯行为克隆很难泛化到全新未知信息环境。 - Q:这套技术真正的护城河是什么?
A:不是模型权重,而是离线考场的环境工程、大规模长步骤工具调用轨迹;权重会快速迭代,但轨迹生成管线可以持续复用。 - Q:企业在什么条件下才值得自建这套蒸馏管线?
A:需要四条同时满足:业务长期高频复用、任务支持客观自动判分、瓶颈在检索决策动作、依赖的信息环境可以低成本打包固定。开放互联网场景,调用商用大模型接口更加稳妥。
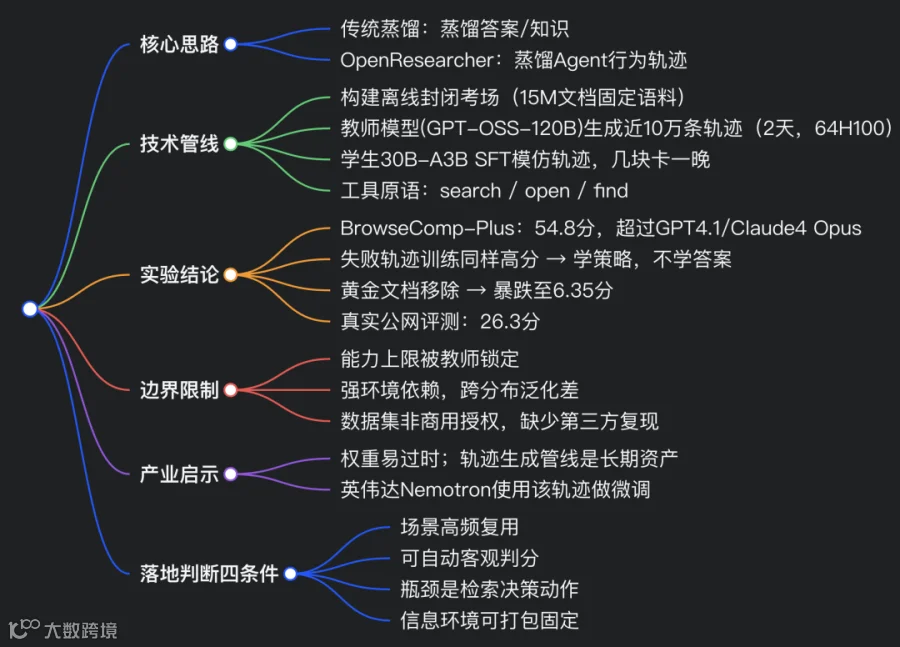
附录 OpenResearcher 论文精读
论文:OpenResearcher: A Fully Open Pipeline for Long-Horizon Deep Research Trajectory Synthesis(EMNLP2026,arXiv:2603.20278)核心一句话:不是蒸馏知识、不是蒸馏答案,而是蒸馏【深度研究智能体的工具使用行为轨迹】;在封闭离线考场里,用大模型教师跑出来大量搜索浏览轨迹,监督微调小模型,让小模型学会多跳检索研究策略arXiv。
一、传统蒸馏的局限:研究能力很难直接蒸馏
常规蒸馏适合输入输出边界清晰的任务:翻译、抽取、单步代码,对错标准明确。 深度研究任务是长程多跳 Agent 任务,难点不在最终答案,而在整套探索行为:
-
拆解模糊问题 → 搜索 → 读长文档 → 比对证据 → 发现矛盾推翻结论 → 更换关键词重试,直到收敛; -
很难采集大量高质量人类操作轨迹; -
直接调用公网搜索 API 录制轨迹:成本极高、网页动态变化、结果不可复现; -
人工出题判分困难,没有标准化的打分函数。
传统蒸馏:学答案;OpenResearcher:学行动策略。
二、方案:搭建离线封闭 “考场” 生成合成轨迹
1. 构建离线固定文档库
从公开题库选数千道种子题,预抓取上万篇核心证据文档,混入1500 万公开网页,搭建本地离线检索引擎,完全脱离实时互联网。 ✅ 优势:检索结果固定、可反复复现、不需要持续支付搜索 API 费用。
2. 教师模型生成轨迹(约两天算力)
教师模型:GPT-OSS-120B,仅赋予 3 个基础工具原语:search检索、open打开页面、find页内查找。 64 张 H100 运行约 2 天,自动跑近 10 万条完整研究轨迹(包含大量长轨迹,单次任务上百次工具调用),完整记录每一步思考 + 工具动作。
3. 学生模型监督微调(成本极低)
学生底座:30B 模型,推理激活仅 3B 参数(30B-A3B),直接 SFT 模仿教师全套动作轨迹,几块 GPU 一晚即可完成训练。 不使用强化学习,纯行为克隆。
三、关键实验结果(BrowseComp-Plus,830 道深度研究题)
-
基座原始小模型:20.8 分 -
蒸馏轨迹微调后:54.8 分 -
同环境下商业旗舰:GPT-4.1≈36.4、Claude-4-Opus≈36.8
小模型在固定离线考场里,超过当时旗舰闭源模型。
非常关键的消融结论
哪怕只用教师模型失败的错误轨迹做训练,小模型依然达到 55.06 分,几乎不变。 👉 证明:模型学到的不是题目答案,而是一套研究动作策略:检索失败就换关键词、在长文本定位证据、多源交叉校验,而不是死记答案。
另一个对照:给 GPT-4.1 直接把包含答案的黄金文档放进上下文,准确率可达 93.5%。 👉 旗舰大模型本身推理能力足够,短板是没有养成持续调用工具、排查证据的 Agent 行为习惯。
四、巨大短板:高度依赖固定封闭环境(核心边界)
- 考场内很强,走出考场就暴跌
-
移除考场内的黄金文档,分数直接掉到6.35 分; -
放到真实动态互联网评测 BrowseComp,分数掉到26.3 分; -
单纯行为克隆无法泛化到全新未知信息环境,真实互联网场景需要搭配在线强化学习。 - 能力上限被教师锁死
,学生不会产生超越教师的新能力; -
开源数据集是非商用授权;目前还没有第三方独立完整复现。
五、成本与护城河的重新理解
过去认知:训练大模型权重是最贵的。 这套管线完全反转成本结构:
-
学生微调:非常便宜,几块卡一晚; - 真正高成本、护城河在环境工程 + 高质量 Agent 行为轨迹
:搭建离线语料库、设计工具原语、大规模合成长轨迹。
行业印证:英伟达将 OpenResearcher 合成轨迹作为 Nemotron 3 Ultra 的微调数据,NeMo Data Designer 集成这套轨迹生成思路。
权重会迭代过期;持续生成高质量 Agent 行为轨迹的管线,才是长期资产。
六、落地 ROI 四判断准则(什么时候值得自建这套离线蒸馏管线)
四条必须全部满足才划算:
-
业务场景长期高频复用; -
任务可以实现客观自动判分; -
瓶颈是搜索浏览决策动作,不是检索召回 / 工具基础设施故障; -
业务依赖的信息环境可以低成本打包、固定、重置。
只要场景是开放互联网、大量全新未知信息、强即兴推理:直接调用商业大模型接口依然是更稳妥的选择。