搜索
首页
大数快讯
大数活动
服务超市
报告
跨企查
广告开户
APP
产业带
导航
知识体系
工具箱
产业园
更多
百科
找货源
跨境招聘
DeepSeek
首页
>
三个00后,A轮拿了67亿
>
三个00后,A轮拿了67亿
创业邦
2026-10-24
12
导读:让每一块GPU释放更多价值。
作者丨晨阳
编辑丨小龙、子钺
一家尚未推出正式产品、亦无规模化收入的AI初创公司,在成立不到一年后估值飙升至60亿美元。这种巨大的反差,使Flapping Airplanes成为2026年硅谷AI投资热潮中备受瞩目且极具争议的案例。
近日,
美国
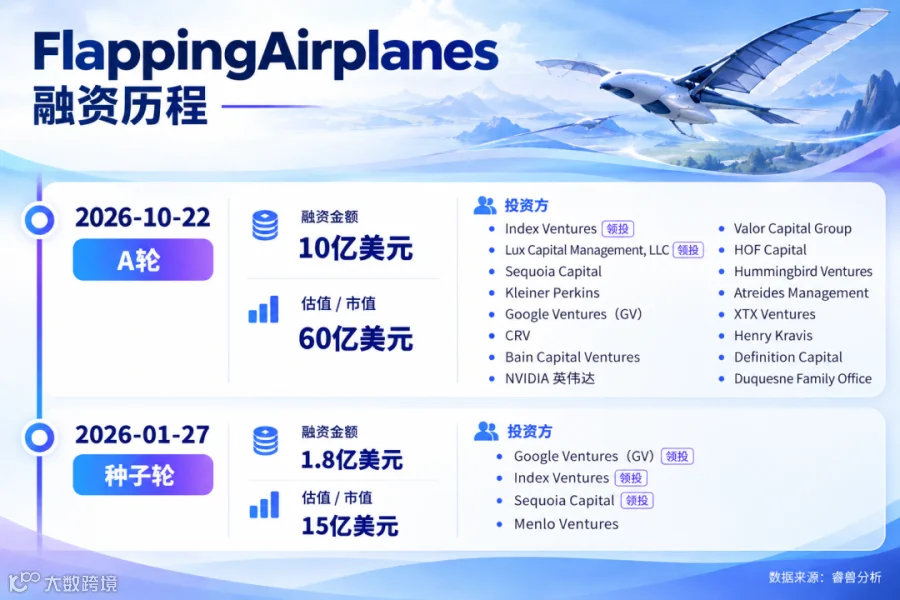
人工智能初创公司Flapping Airplanes宣布完成10亿美元(约合67亿元人民币)A轮
融资
。本轮融资由Index Ventures和Lux Capital联合领投,红杉资本、谷歌旗下风投机构GV、Kleiner Perkins等机构参投。
融资完成后,Flapping Airplanes估值达到60亿美元(约合400亿元人民币)。相较于今年1月融资时的15亿美元估值,短短9个月内增长了三倍。
Flapping Airplanes成立于2025年末,由Ben Spector、Asher Spector和Aidan Smith三位年轻创业者联合创办。团队履历横跨斯坦福大学、麻省理工学院、脑机接口公司Neuralink以及硅谷创业孵化生态。
与
OpenAI
、Anthropic等公司持续投入巨额资金扩大模型规模的路径不同,Flapping Airplanes提出了一个极具挑战性的命题:能否让人工智能使用更少的数据和算力,获得同等甚至更强的智能?
三位年轻人的逆向创业
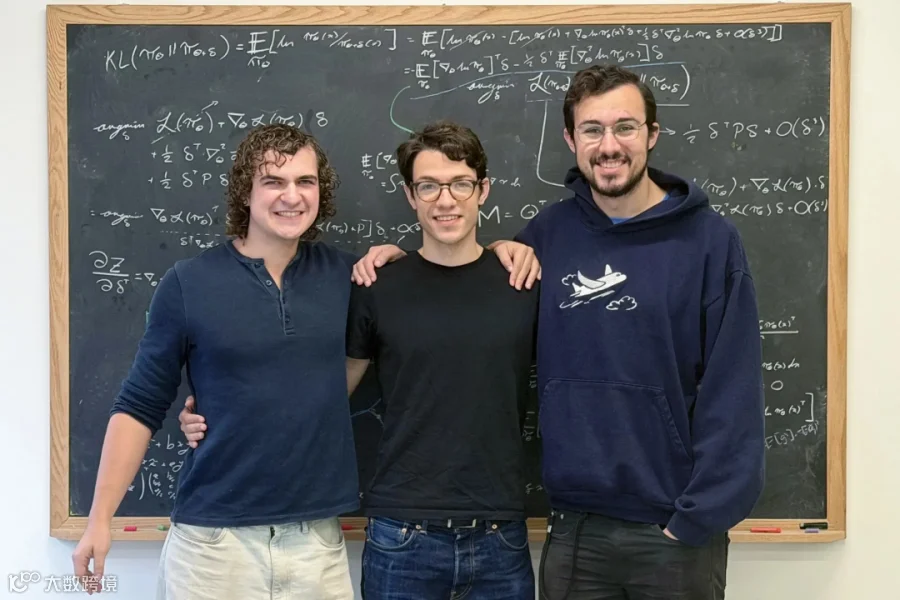
Flapping Airplanes的创始团队由三位20多岁的年轻人组成:Ben Spector、其兄Asher Spector以及Aidan Smith。
从左到右依次为:Aidan Smith、Asher Spector、Ben Spector
CEO Ben Spector拥有麻省理工学院计算机科学与数学工程硕士学位,后进入斯坦福大学计算机科学博士项目,师从Chris Ré。在MIT期间,他联合创办了学生创业加速器Prod,Cursor、Mercor、Etched、Decart等公司的早期孵化均与其有关。红杉资本评价Prod为“硅谷最强大的人才孵化器之一”。
2024年10月,Ben作为第一作者发表了开源GPU编程框架ThunderKittens论文。该框架旨在降低高性能GPU内核开发难度,数据显示其在GEMM和注意力推理性能上匹配cuBLAS与FlashAttention-3,并在注意力反向、状态空间模型等操作中优于最强基线。这段经历奠定了其创办Flapping Airplanes的技术底色:深入GPU底层计算系统,解决AI运行效率问题。
Asher Spector毕业于哈佛大学,后在斯坦福大学攻读统计学博士,研究方向涵盖统计推断与机器学习,于2026年完成学位。他曾于
Meta广告
团队实习,工作涉及利用更少用户数据训练机器学习模型,这与他后来在Flapping Airplanes聚焦“数据效率”的研究方向逻辑一致。
Aidan Smith背景独特,作为蒂尔奖学金(Thiel Fellowship)获得者,他在佐治亚理工学院就读期间同时在Neuralink工作三年,从事机器学习研究和语音应用相关工作。这段经历使他比典型AI研究者更早接触到神经科学、生物智能与工程系统的交叉领域。
三位创始人并未打算简单复制生物大脑或推倒重来现有AI系统。他们的判断更为克制且具体:现有大模型在数据效率上远未触及上限,未来真正具备竞争力的系统,未必是参数最多、数据最大的那个,而可能是能以更少资源获得更强学习能力的系统。
资本市场已用真金
白银
表达了态度。2026年1月,Flapping Airplanes完成1.8亿美元种子轮融资,估值达15亿美元,投资方包括GV、红杉资本、Index Ventures和Menlo Ventures。至此,公司累计公开股权融资额约11.8亿美元。
让每一块GPU释放更多价值
过去几年,AI行业遵循着增加参数、扩大数据规模、投入更多计算资源以提升模型能力的发展逻辑。这一方法虽推动了大语言模型的快速发展,但也带来了高昂的成本。训练先进模型需要大量高性能芯片,部署需持续消耗算力,数据中心建设运行还依赖电力、网络和冷却设施。随着AI应用从聊天机器人扩展至编程、科研、机器人及企业自动化,行业对计算资源的需求仍在增长。
Flapping Airplanes认为,解决这些问题不能仅靠采购更多GPU,而是希望从两个方向提高AI系统效率。
提升模型数据利用效率
公司希望探索新的模型训练方法,让系统从更少数据中提取更多有效信息。若此法取得突破,未来训练先进AI模型所需数据规模将大幅下降。这不仅意味着成本降低,还可能让人工智能进入过去难以应用的领域,进一步扩大应用边界。
提高GPU实际计算效率
公司正在开发名为Megakernel的GPU计算框架。传统GPU计算通常执行大量不同任务,存在调度、数据传输和同步等开销,芯片利用率往往不足。Megakernel的思路是将原本分散的多个计算操作整合到更大的GPU内核程序中执行。
该框架能在单个内核中处理完整训练过程、执行推理任务,甚至同时运行游戏等不同类型工作负载。更重要的是,它试图让不同性质的任务共享计算资源。例如,模型训练主要消耗计算能力,而推理某些操作受内存带宽限制。若能合理安排两类任务,使计算单元和内存系统交替发挥作用,将有机会减少GPU空闲
时间
。
当算力成为新时代的石油
效率决定AI的下一场竞争
在AI Agent快速发展的背景下,人工智能不再只是回答一次问题,而是需要持续执行搜索、编程、分析、规划和操作等复杂任务,一个任务可能涉及数十次甚至更多模型调用。当这种使用方式进入企业生产流程,推理成本将直接影响商业模式的可行性。因此,降低单位任务的计算成本不仅是技术优化,更可能决定AI企业的利润空间。
从产业
角度
看,效率提升具有更深远意义。
首先,它可能降低AI行业的进入门槛。目前,最先进模型的研发集中在少数拥有巨额资金和算力资源的企业手中。如果未来训练高性能模型所需的数据和算力显著减少,中小型科技公司、科研机构乃至专业领域团队将获得更大的创新空间,人工智能创新也不必完全依赖超大规模资本投入。
其次,效率突破可能推动AI向现实世界渗透。以机器人为例,其既受计算资源和能源消耗限制,又面临真实世界训练数据不足的问题。如果人工智能系统能够在更少数据条件下学习,并以更低计算成本运行,机器人技术就有机会获得更强的经济可行性。类似逻辑也适用于生命科学、工业自动化和其他数据稀缺、计算成本敏感的领域。
科技史上,许多改变世界的创新最初都不是对既有道路的简单延伸,而是源于有人敢于重新提出问题。当一个行业逐渐形成共识,新的机会往往隐藏在那些被视为理所当然的前提之中。
【声明】内容源于网络
0
0
创业邦
创业邦是领先的国际创新生态服务平台,为高成长企业、金融机构、产业园区、 地方政府提供全方位的媒体资讯、数字会展、数据研究、创新咨询、教育培训、 资本对接等服务。 公司及旗下基金获得IDG资本、DCM、红杉中国、北极光创投、顺为资本、腾讯 投资、盛景投资、宜信、GGV等10余家世界顶级投资机构支持,并形成长期紧 密的战略合作关系。
内容
17368
粉丝
1
关注
在线咨询
创业邦
山东创业邦创业服务有限公司
创业邦是领先的国际创新生态服务平台,为高成长企业、金融机构、产业园区、 地方政府提供全方位的媒体资讯、数字会展、数据研究、创新咨询、教育培训、 资本对接等服务。 公司及旗下基金获得IDG资本、DCM、红杉中国、北极光创投、顺为资本、腾讯 投资、盛景投资、宜信、GGV等10余家世界顶级投资机构支持,并形成长期紧 密的战略合作关系。
总阅读
428.1k
粉丝
1
内容
17.4k










 创业邦
