

将 ScienceAI设为星标
第一时间掌握
新鲜的 AI for Science 资讯
作者丨Scinetics 研究团队
编辑丨ScienceAI
ScienceRSI:构建科学模型能力迁移与复用新范式
模型参数量越大是否意味着科学推理越可靠?小模型能否将其专长有效传递给大模型?近日,Scinetics 联合复旦大学、中国科学技术大学及香港科技大学发布技术报告 ScienceRSI,提出一种围绕专业化、验证、迁移与复用的科学模型训练框架。该框架旨在让模型习得的有效能力成为其他模型进阶的学习信号,解决科学推理中局部能力差异导致的误差问题。
实验数据显示,ScienceRSI 在 4B 和 8B 规模模型的五项科学评测中均取得最高分;在 8B 向 27B 模型的迁移实验中,七项基准平均分从 87.3% 提升至 94.0%。目前,ScienceRSI-8b 模型权重已在 Hugging Face 开源。
技术报告:https://www.preprints.org/manuscript/202610.2228
开源模型:https://huggingface.co/Scinetics-ai/ScienceRSI-8b
核心机制:专业化、验证、迁移与复用
训练多个具备不同专长的模型并不自动等同于获得一个全能的科学助手。ScienceRSI 强调在能力迁移前,需通过统一的科学标准检验专家模型的贡献,确保只有优于当前回答的有效信息被采纳。

图 1 同规模能力整合、小模型向大模型迁移,以及后续复用方向。
专业化分工
首先培养具有不同科学专长的紧凑模型,分别侧重定量计算、符号推导、机制解释和证据判断。这种专业化策略使不同模型在具体能力上形成互补优势。
严格验证
将科学回答拆解为可检查的具体要求,如计算准确性、机制合理性及结论的证据支持度。仅当专家在特定要求上的表现优于当前回答时,其贡献才具备被采用的资格。
精准迁移
将经过筛选的专家贡献用于目标模型训练,使反馈精准对应模型需要改进的薄弱环节。目标模型结合任务奖励与专家反馈,有效整合分散的科学能力。
循环复用
将改进后的模型作为下一轮专业化的起点,形成持续优化的闭环。这一过程需持续检验新专家是否能带来新的学习价值,避免知识停滞。
实验结果:多规模模型性能显著提升
研究团队选用 GPQA-Diamond、RaR-Science、SciBench、ChemBench、RaR-Med、MMLU-Pro 及 MATH500 七项基准,全面评估科学推理、领域科学及通用推理能力。

图 2 三组迁移实验的完整主结果。深绿色加粗与浅绿色下划线分别标记最佳和次优得分。
同规模整合与小模型辅助大模型
在 4B→4B 实验中,ScienceRSI 的科学推理平均分达 55.0%,较 GRPO 高出 2.0 个百分点;领域科学平均分达 59.3%,提升 3.3 个百分点。在 4B→8B 实验中,科学推理与领域科学平均分分别提升 1.9 和 2.1 个百分点。结果表明,即便专家参数量小于目标模型,经过验证的局部优势仍能形成有效的训练反馈,且在提升科学能力的同时保留了具有竞争力的通用推理表现(8B 模型在 MATH500 上达 85.7%)。
8B 专家助力 27B 模型全面突破
在使用 Qwen3-8B 专家向 Qwen3.5-27B 目标模型迁移的扩展实验中,ScienceRSI 在七项基准上均实现提升。七项基准等权平均分从 87.3% 升至 94.0%,增幅达 6.7 个百分点。其中,ChemBench 从 87.2% 升至 95.5%(+8.3%),RaR-Med 从 82.9% 升至 91.7%(+8.8%)。这证明较小专家的科学专长经筛选整合后,能显著增强起点更高的大模型表现。
关键洞察:专家反馈需经严格筛选
盲目引入所有专家输出可能导致错误信息的吸收。对比实验显示,仅使用 GROP 时科学推理平均分为 53.0%;加入未经筛选的密集专家监督(GRPO+MOPD)后得分降至 50.1%;而采用 ScienceRSI 验证机制后得分提升至 55.0%。
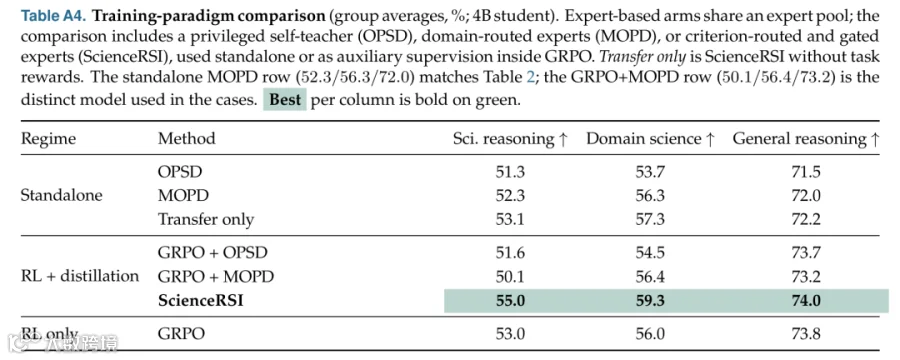
图 3 GRPO+MOPD 与 ScienceRSI 均结合任务奖励和专家监督,表中同时列出纯蒸馏与仅强化学习的对照。
进一步分析表明,移除验证环节导致科学推理平均分降至 50.6%;若保留监督量但随机分布反馈,科学推理与领域科学平均分分别下降 6.3 和 12.1 个百分点。这证实训练信号的价值取决于其是否精准对应真实能力缺口。ScienceRSI 通过先检验后采用的策略,确保了专业化训练形成的局部优势得以保留。
案例解析:遗传题中的互补协作
在一道关于 TtGg 与 ttgg 杂交子代比例的遗传题中,起始模型错误回答为 0%。机制专家提供了通过验证的遗传方格信息,证据专家给出了正确的最终比例。经过完整训练,ScienceRSI 正确回答为 25%,并通过全部七项要求验证。该案例直观展示了即使单个专家无法独立解题,其通过验证的局部贡献仍能协同提升模型整体能力。

图 4 保留起始学生的错误输出、专家验证结果与训练后回答。后者来自完整训练过程,不归因于单次更新。
未来展望:递归改进与多模态扩展
随着目标模型能力增强,原有专家可能无法提供足够的新信息,因此专业化训练、任务难度与验证能力需同步提升以实现持续的递归改进。未来,可靠反馈机制有望扩展至分子结构、科学图像、模拟数据及实验观察等多模态领域,帮助模型在更复杂的科学任务中识别缺口并吸收有效经验。ScienceRSI 为此路径提供了经过实验验证的基础框架。
人工智能 × [ 生物 神经科学 数学 物理 化学 材料 ]
「ScienceAI」关注人工智能与其他前沿技术及基础科学的交叉研究与融合发展。
欢迎关注标星,并点击右下角点赞和在看。