克雷西 发自 凹非寺 大模型验证了自身价值,却也彻底搅乱了算力资源的供需平衡。TrendForce数据显示,自2025年年中以来,部分DDR5内存价格在短短一年多内上涨近10倍。这一现象的核心驱动力在于云端大模型的训练与推理吞噬了大量产能,导致需求向端侧溢出。 与此同时,手机端可运行的模型参数规模从3B迅速膨胀至30B甚至更高。面对模型进化
速度与硬件扩张速度的严重错配,行业正通过压缩模型精度和优化推理系统开销两条路径寻求突破。在9月的高通骁龙峰会上,成立不足一年的中国初创企业无量火科技与高通联合发布了移动端解决方案,展示了其Ember推理引擎,成功在手机端无损运行30B大模型并大幅降低内存占用。这标志着端侧AI正迎来长周期的增长机遇。
存算资源错配催生端侧AI长周期红利
无量火科技CEO王瑜琨指出,存算资源的供需错配越深,端侧AI的增长空间反而越大。随着云端大模型对存储资源需求的激增,全球DRAM产能被大量消耗,直接推高了内存价格。而在端侧,模型参数规模从3B向30B乃至100B迈进,硬件性能的滞后加剧了这一矛盾。 然而,出于用户体验和成本考量,终端厂商无法完全依赖云端算力。模型进化与云端算力需求的溢出,共同推动智能向终端迁移。今年以来,多家厂商密集发布智能体手机,尽管完整体验尚需时日,但技术路径已逐渐清晰:一是从模型侧压低精度,二是从推理引擎侧压缩系统开销。无量火科技选择深耕后者,旨在填补端侧AI基础设施领域的标准空白。
AI优化AI:推理引擎的自进化之路
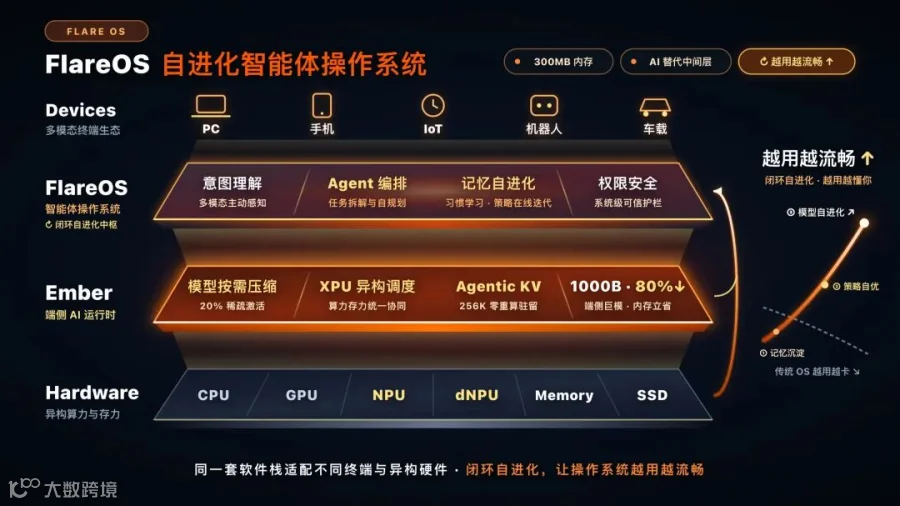
Ember推理引擎的核心在于“预测性部分加载”。基于大模型的稀疏特性(如MoE架构中仅激活少数专家网络),Ember通过训练轻量级预测模型,提前判断下一步推理所需的参数,仅将这部分数据从闪存加载至内存,其余参数保持静止。这种方法不仅适用于MoE架构,也能通过改造Dense模型的FFN层冗余激活,使其达到类似MoE的运行效率。实测数据显示,Ember可将MoE模型内存占用降低80%,Dense模型降低50%,且推理
质量几乎无损。


与传统依赖手写优化规则的引擎不同,Ember在预测、调度和路由等环节广泛采用深度学习算法。这意味着引擎在部署后可持续积累优化经验,实现推理速度随使用时长而提升,并通过跨用户共享形成网络效应。这种“用AI优化AI”的自进化模式,旨在通过软件算法弥补硬件扩张的滞后,重构软件生态。 在此基础上,无量火推出了基于Ember的AI原生操作系统FlareOS。该系统仅需300MB出头运行内存即可支撑操作系统、大模型及多个Agent同时运行,内存占用仅为传统系统的十分之一。FlareOS利用AI替代传统OS中大量的抽象层和中间件,将资源释放给智能运算,实现了软件在闭环逻辑内的自行进化,打破了传统软件“越用越卡”的局面。
抢占身位,构建生态壁垒
依托团队在PC和手机端性能优化及MoE方向的深厚积累,无量火快速打通了商业化路径。公司位于
上海浦东张江,成立百天即与多家头部算力平台达成合作,并入选中国信通院创新实践汇编。成立不到半年,无量火作为唯一中国初创企业登上高通骁龙峰会主题演讲舞台。目前,Ember已适配国内外十余家主流算力平台,并与多家头部终端厂商建立OEM合作。

面对激烈的市场竞争,王瑜琨强调以速度拉开身位,用生态锁死壁垒。核心在于确保引擎进化速度跟上模型迭代节奏。无量火团队具备扎实的工程功底和极客文化,致力于构建底层的“智能系统”。随着开源模型架构约每半年发生一次重大变革,快速适配能力成为关键。当引擎覆盖足够多的芯片和终端后,沉淀的适配数据和优化经验将形成难以跨越的生态壁垒。 展望2027年1月的CES,无量火计划联合合作伙伴发布FlareOS软硬一体化产品。随着DRAM 3D堆叠和HBF闪存技术的发展,端侧带宽有望提升十倍至数十倍。王瑜琨预测,明年100B参数的大模型将在手机上流畅运行。未来,从手机到车载再到机器人,每台终端都可能搭载一套自进化的智能系统。在智能奇点时代,无量火正致力于让智能没有边界,推动万物泛在的智能终局到来。


