

测试数据显示,昇腾950PR在1,055个BF16矩阵乘法形状中,最佳内核效率可达理论上限的99.7%,但绝对吞吐量为325 TFLOPS,低于H100的747 TFLOPS。DeepSeek通过将KV缓存优化、内核调度及专家通信深度整合进昇腾软件栈,致力于解决从单算子高效执行到整体模型高效运行的跨越难题。
单芯片算子跑满并不等同于整套模型的高效运行。推理与训练过程涉及KV缓存读写、数据搬运、专家分发及通信等待等多重环节。昇腾与DeepSeek的最新协作,正旨在将这些原本分散在模型层、编译器及系统软件中的环节进行系统性统筹与优化。
矩阵乘法效率高,但绝对吞吐仍有差距
测试采用的950PR_9579配置为28个Cube核和128GiB HBM。在源自开源模型的1,055个BF16 GEMM形状测试中,其最佳实现效率达99.7%,中位效率为86.0%,优于H100的75.5%中位数。这表明针对特定矩阵形状,昇腾原生内核已能充分释放计算单元潜力。
然而,效率百分比不等同于总吞吐量。950PR的中位吞吐为325 TFLOPS,显著低于H100的747 TFLOPS。该芯片主要定位预填充(prefill)和推荐等场景,其核心数量与内存带宽均低于950DT。芯片仅负责执行既定计算,而模型部署还需应对计算之外的等待与数据搬运开销。

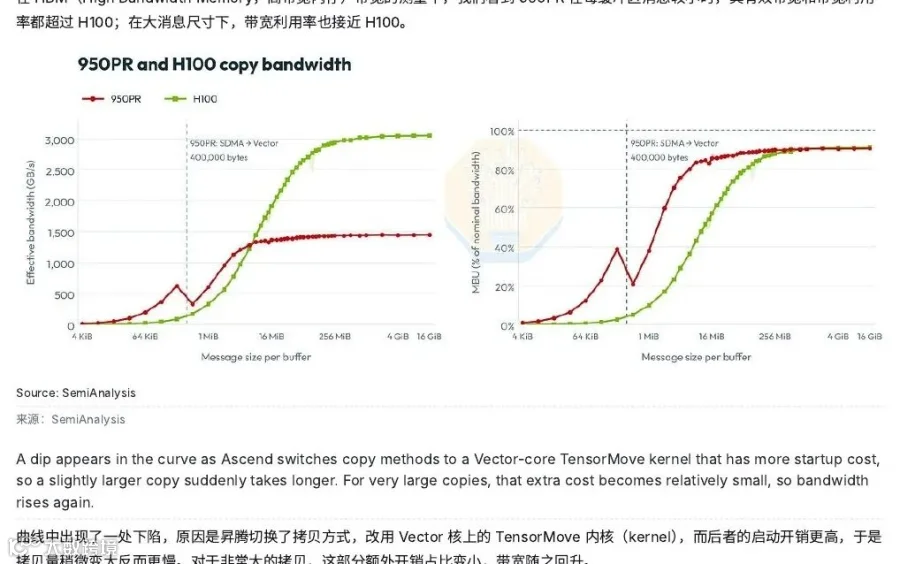
HBM测试进一步揭示了差异所在。在小消息尺寸下,950PR的有效带宽及利用率超越H100;随着消息增大,利用率趋近H100。但在约400,000字节处出现带宽曲线下陷,原因是拷贝路径切换至启动开销更高的Vector核TensorMove。数据搬运策略与时机,直接影响单个算子的最终表现。
适配优化:从减少数据搬运入手
DeepSeek对昇腾的支持已覆盖TileLang、DeepGEMM、DeepEP、TileKernels、FlashMLA和DeepSelect等代码库。目前仅TileLang完全可用,部分组件仍依赖尚未就绪的CANN 9.2.0,“支持昇腾”仍处于工程链补齐阶段,距离全工作负载直接适用尚有距离。
最直观的改进体现在FlashMLA的KV缓存布局上。旧布局将量化数值与缩放因子分离存储,读取一个token需发起两次搬运;新布局将同一token的两类数据连续存放,使内存搬运引擎可一次性读取。此举在不改变模型输出的前提下,减少了一次数据传输请求。

昇腾950后端已并入TileLang主仓库。开发者需决策计算路径、tile切分及数据放置,编译器则负责协调Cube核、Vector核与数据搬运。AutoSchedule依据依赖关系和预估时间安排重叠执行,在950PR小尺寸场景中,单算子执行时间最多减少40%。内核工程重心已从“编写算子”转向“确保下一批数据在当前计算结束前到位”。

专家通信重叠与HBM资源争用
MoE推理涉及Token向不同专家的分发及结果合并。昇腾将Cube与Vector分为独立执行路径,为计算与通信并行提供可能;DeepEP-Ascend则在底层调用URMA和HCCL,将此路径接入昇腾超节点。
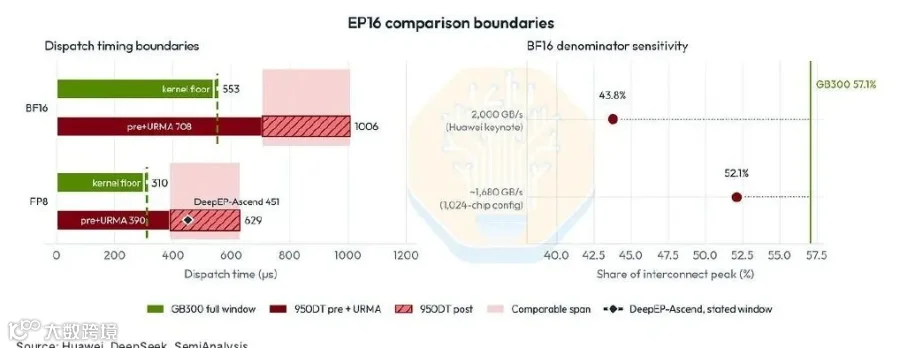
通信开销并未消失。对比显示,950DT的dispatch拆分为pre、URMA和post三段,而GB300采用一次融合调用,统计边界存在差异。关键在于,专家计算、Vector处理和数据搬运均占用共享HBM带宽。通信重叠的效果取决于其是否因争用带宽而拖慢并行计算。
在32颗950DT部署的DeepSeek-V4.1-Flash剖析中,单个decode步骤包含40层目标模型、3个DSpark drafter块及5轮采样。每一步仅检测到4次由AI CPU发起的HCCL操作,却存在43次专家分发。通过将更多通信与计算排入重叠窗口,避免了模型在每次专家路由时停滞。

结语:软件栈协同是模型落地的关键
此次协作不仅留下了昇腾适配代码,更揭示了模型与硬件磨合的关键点:KV缓存布局影响搬运次数,专家并行引发HBM争用,实际部署则将调度与通信问题回归至编译器与固件层面。若能将可复用的内核、后端及部署经验保留在主仓库,未来更换模型或集群时无需重复解决相同问题。但同时也需注意x86兼容性及超节点依赖等限制,面向特定模型跑通的路径,距离让广大开发者直接使用,仍需填补进一步的工程缺口。
