

9 月 22 日,小米 MiMo 团队正式开源 MiMo-V2.6 系列模型。与此同时,一款名为 MiMo-V2.6-Distill-Qwen-9B 的轻量级模型同步发布。尽管 9B 参数量在当下千亿级模型的浪潮中显得微不足道,但其背后折射出的“小模型实用化”与“开源基建完善化”趋势,值得深入关注。
技术解析:从基座到蒸馏的演进逻辑
MiMo-V2.6-Distill-Qwen-9B 基于 Qwen3.5-9B 基座,采用 MIT 许可协议,支持商业应用。其核心训练方法为监督微调(SFT),数据源自 MiMo 自生成的高质量轨迹。这里的“蒸馏”并非简单的输出模仿,而是让小模型学习大模型的解题路径与思维过程。
小米官方明确将该 SFT 检查点定位为“智能体强化学习(Agentic RL)开源研究的起点”,强调其作为基础设施的属性,而非最终成品。
774 亿 Token 的数据配方
SFT 阶段共投入 77.4B token 数据,其中带损失(loss-bearing)数据为 27.2B。数据分布呈现显著的多模态与安全导向特征:
| 方向 | 总量 | 占比 | 带损失 |
|---|---|---|---|
| 代码 Code | 23.2B | 29.9% | 7.3B |
| 网络安全 Cyber | 11.0B | 14.2% | 4.8B |
| 通用 General | 22.0B | 28.5% | 5.7B |
| 视觉 Visual | 21.2B | 27.4% | 9.4B |
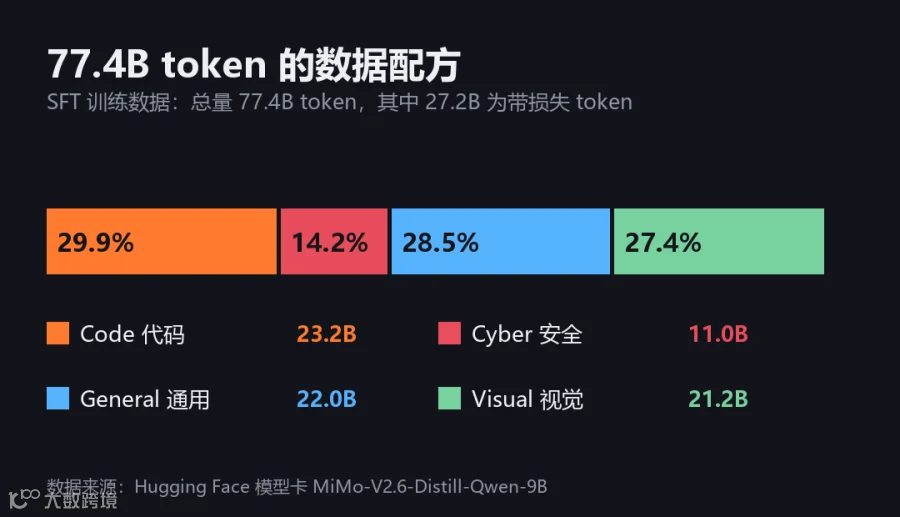
SFT 数据配方:代码、安全、通用、视觉四方向
值得关注的是,网络安全(Cyber)数据占比达 14.2%,且侧重于漏洞复现与渗透测试等主动安全能力;视觉数据虽占比 27.4%,但带损失 token 数最高,表明多模态能力是训练重点之一。
性能评估:倍数增长揭示能力补齐效应
通过与基座模型 Qwen3.5-9B 的对比评测发现,蒸馏模型在基座薄弱领域实现了数量级的提升。
| 领域 | 评测指标 | 基座得分 | 蒸馏后得分 |
|---|---|---|---|
| 代码 | SWE Verified | 60.0 | 61.1 |
| 代码 | SWE Pro | 32.0 | 44.6 |
| 代码 | MiMo Code (mini) | 19.5 | 51.6 |
| 安全 | MiMo Cyber (mini) | 5.7 | 31.3 |
| 通用 | AutomationBench v1.0.6 | 5.0 | 30.3 |
| 通用 | Terminal Bench 2.1 | 27.0 | 37.1 |
| 通用 | Toolathlon-Verified | 25.9 | 35.2 |
| 通用 | OfficeQA | 9.0 | 19.5 |
| 通用 | JobBench | 2.6 | 18.3 |
| 通用 | MiMo General (mini) | 28.5 | 62.2 |
| 视觉 | MiMo Visual Coding (mini) | 61.7 | 64.0 |
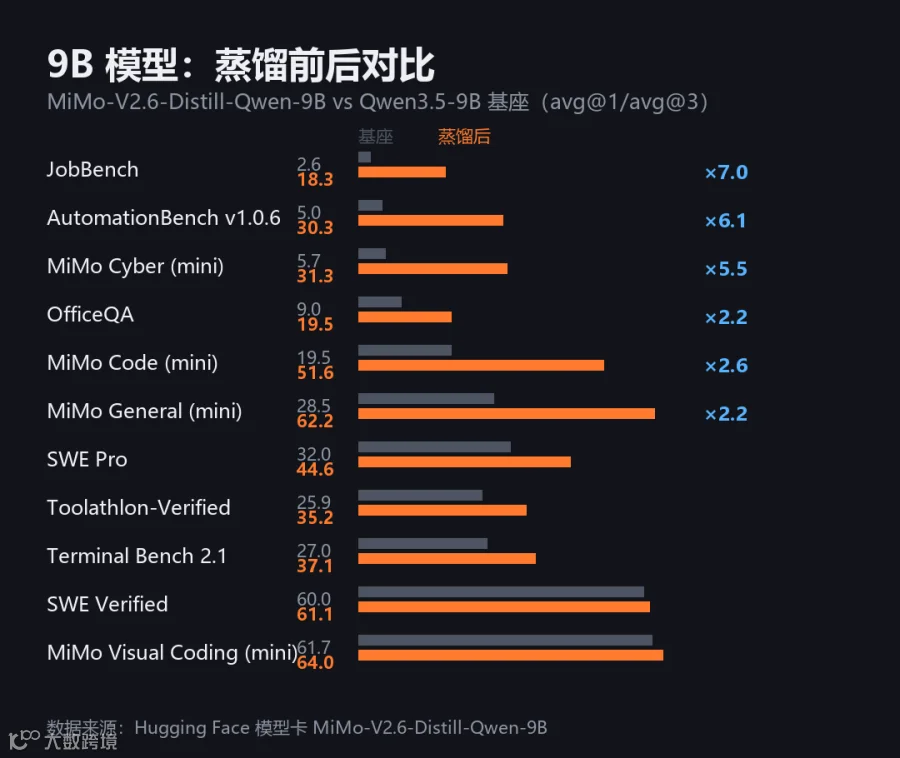
11 项评测:基座与蒸馏后对比,按提升倍数排序
数据显示,在基座已有优势的代码领域(如 SWE Verified),提升幅度有限;而在基座几乎空白的领域,如 JobBench(办公自动化)和 Cyber(网络安全),得分分别提升了 7 倍和 5.5 倍。这证明蒸馏技术的核心价值在于补足小模型的能力短板,使其具备初步的智能体执行能力。
开源基建:超越模型本身的生态价值
小米此次开源的核心竞争力不仅在于模型权重,更在于配套的训练基础设施,旨在降低开发者进行 Agentic RL 研究的门槛。
- 高质量 RL 任务环境:提供 7000+ 覆盖软件工程、漏洞复现、知识工作及网页开发的交互式环境,支持自动判分。
- 端到端 RL 训练框架:基于 verl、uni-agent 和 mini-swe-agent,打通从环境交互到策略优化的全链路。
- 轻量可组合 Harness:解耦系统提示与工具集,支持 Multi-Harness Training,增强模型在不同框架下的泛化能力。
实测表明,以该 9B 模型为起点继续强化学习(RL),各项指标均有显著提升。例如,Cyber 得分从 31.3 进一步提升至 47.0,累计较基座提升超 8 倍。
| 评测指标 | SFT 后得分 | RL 后得分 |
|---|---|---|
| SWE-bench Verified | 61.1 | 66.2 |
| MiMo Cyber Bench | 31.3 | 47.0 |
| Terminal Bench 2.1 | 37.1 | 52.8 |
| MiMo Visual Coding | 64.0 | 72.4 |
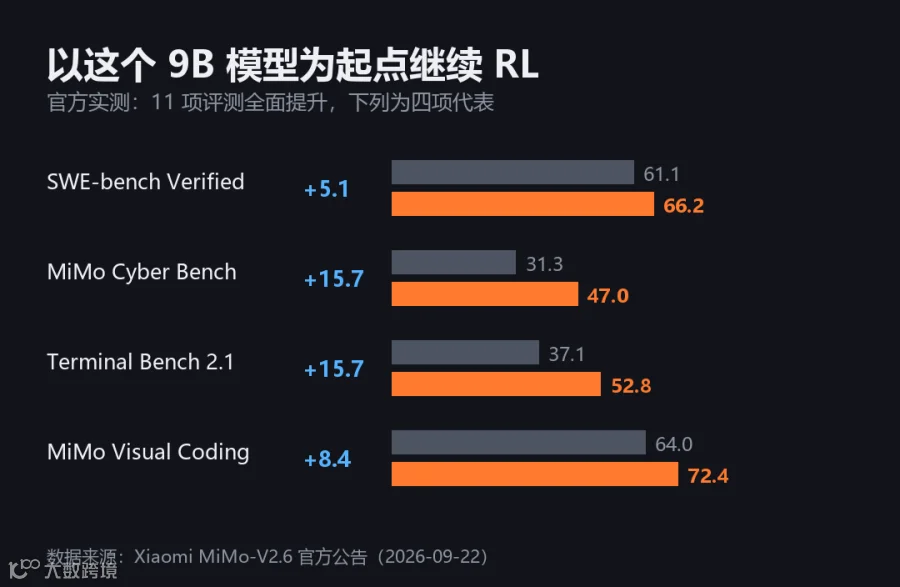
以 9B 模型为起点继续 RL 的四项代表评测
MiMo-V2.6 主模型:成本与性能的平衡
在主模型 V2.6 的训练上,小米披露了详细的工程细节。Pro 版本训练成本约 262 万美元,历时不到 6 天,累计处理 75 万条轨迹。通过扩大 Batch Size、混合多任务环境及优化 Grader 算力,实现了训练效率的大幅提升。
在 Artificial Analysis 综合智能指数上,MiMo-V2.6-Pro 获得 46 分,超越 Kimi K3 和 Qwen3.8 Max,成为当前最强开源模型之一。但在绝对智能水平上,与 Claude Fable 5.1 和 GPT-6 Astra 等闭源顶尖模型仍存在差距。

智能与成本的帕累托前沿:横轴为综合智能指数,纵轴为单任务成本(对数)
凭借同等智能水平下仅为海外模型 1/20 至 1/60 的价格优势,MiMo-V2.6 确立了“高性价比开源模型”的市场定位。
行业启示:小模型的落地意义
MiMo-V2.6-Distill-Qwen-9B 的出现,为中小团队和个人开发者提供了切实可行的落地路径:
- 本地化部署:量化后可在消费级显卡运行,满足代码补全、终端操作等需求,确保数据隐私。
- 垂直领域微调:依托 MIT 许可及完善的 RL 基建,企业可低成本基于自身业务数据进行二次训练。
- 学术研究复现:为学术界提供了可复现的 Agentic RL 研究基准,推动技术透明化。
综上所述,小米此次开源不仅展示了模型能力的提升,更通过提供完整的训练基建,推动了 AI 能力的“下沉”。对于大多数开发者而言,这种可获得性远比单纯的参数规模竞赛更具实际价值。