

Kimi K3.1 Pro 发布:综合智能指数全球第四,开源与闭源差距缩至3分
10月23日,月之暗面正式发布 Kimi K3.1 Pro。独立评测机构 Artificial Analysis 公布了两项关键数据:其一,Kimi K3.1 Pro 在综合智能指数上得分为 55 分,位列全球第四,仅次于 Claude Opus 5.5(58分)、Claude Sonnet 5.5(56分)和 Muse Wonder Full(56分);其二,随着其权重计划于 11 月 4 日前开放,开源模型与最强闭源模型之间的性能差距将从 12 分大幅缩小至 3 分。
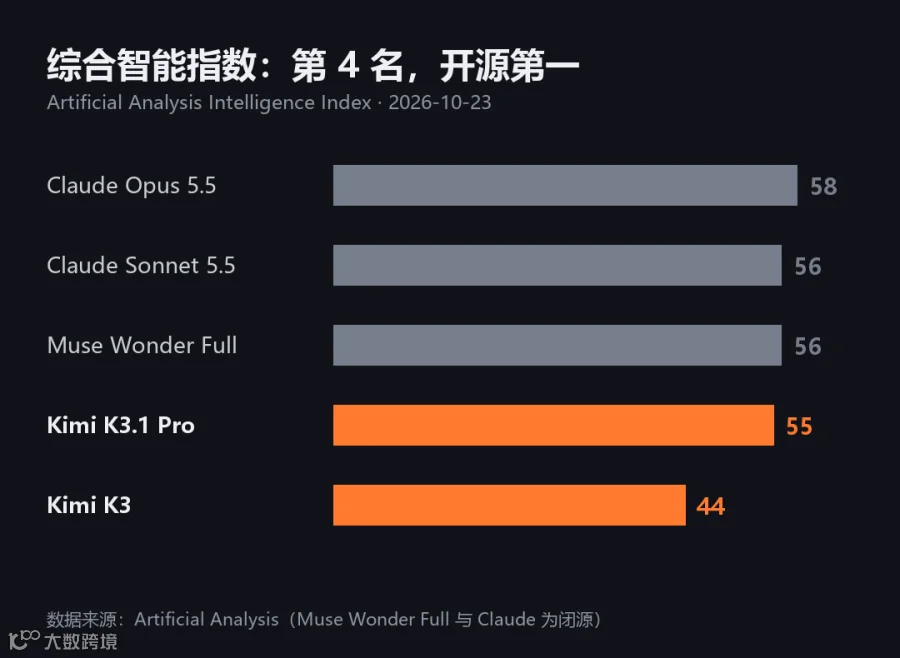
综合智能指数排名:Kimi K3.1 Pro 以 55 分位列第 4,是排名最高的开源模型
技术本质:基于 K3 的深度后训练版本
Kimi K3.1 Pro 并非全新的基座模型,而是 Kimi K3 的后训练(post-training)版本。官方技术博客指出,该版本基座未变,核心变化在于「大幅增加了后训练算力」,通过强化学习(RL)将同一套权重的性能推向新高。结果显示,其综合智能指数较 Kimi K3 的 44 分提升了 11 分。
在规格方面,Kimi K3.1 Pro 总参数达 2.8 万亿,激活参数为 1040 亿,支持 100 万 token 上下文,输入端兼容文本和图像。官方将其定义为「3T 级开源权重模型」,并同步发布了速度为标准版 2–3 倍的 Highspeed 版本。
核心突破:重构技术栈以提升 RL 算力效率
为实现在数百个下游领域的大规模联合强化学习,月之暗面重构了包括 RL 框架、长上下文推理、训练效率、沙箱基础设施、rollout 调度及共享环境质量校验平台在内的全技术栈。其核心目标在于解决行业普遍面临的 RL 边际收益递减问题,确保每一份 RL 算力的投入都能转化为稳定、可预测的性能回报。
评测表现:Agent 类任务提升显著
从各项基准测试来看,Kimi K3.1 Pro 在 Agent 类评测中表现尤为突出,而在纯知识类评测中提升相对温和,这与强化学习擅长处理有明确反馈信号的任务特性相符。
Terminal-Bench 4.0:该测试评估编码智能体在真实、资源受限终端任务上的表现。Kimi K3.1 Pro 得分 65.7%(官方口径),领先 GPT-6 Astra(58.2%),仅次于 Claude Opus 5.5(66.4%)。Artificial Analysis 使用自有 harness 测得分为 67%,相比之下,前代 Kimi K3 仅得 13%,实现了五倍的性能飞跃。
其他关键指标表现如下:
|
|
|
|
|---|---|---|
|
|
|
67% |
|
|
|
1846 |
|
|
|
73% |
|
|
|
52% |
|
|
|
61% |
|
|
|
25% |
其中,GDPval-AA 得分提升 312 Elo,位列全球第三;AutomationBench-AA(SaaS 工作流智能体执行)从 58% 提升至 73%。

Terminal-Bench 4.0 与 SWE Marathon:Kimi K3.1 Pro 的 65.7% 仅次于 Claude Opus 5.5 的 66.4%
幻觉率控制:不同口径下的优化成果
关于幻觉率,官方与第三方评测存在口径差异。官方数据显示,在其内部 Kimi Hallu Bench Hard(压力测试)上,claim-level 幻觉率从 K3 的 23.4% 降至 8.3%,包含事实错误的响应占比仅为前代的 42.4%。而 Artificial Analysis 的 AA-Omniscience 指数显示,幻觉率从 53% 降至 44%,准确率从 48% 升至 51%。两者均证实了模型在事实准确性上的显著提升。
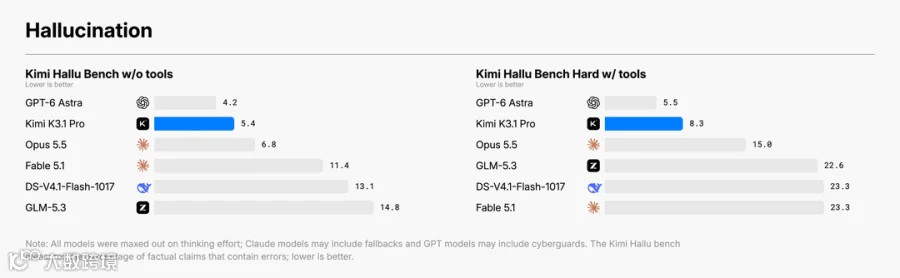
幻觉评测:Kimi Hallu Bench 上越低越好的错误率对比
此外,金融垂直领域基准测试提升明显:Financial Modeling 涨 7.2 分,Financial Research 涨 11.6 分,Business Operation 达到 K3 的约 4.2 倍。
安全策略:主动削弱网络攻击能力
在网络安全方面,月之暗面采取了一项罕见的举措。由于发现增强后训练算力会自然提升模型的漏洞研究与网络攻击能力,团队在中期训练和 RL 阶段主动识别并删除了相关数据。这一决策导致其在内部 xdev-bench-hard(真实漏洞发现与利用任务)上的得分从未经清洗检查点的 90.5% 降至最终发布版的 81.0%,主动牺牲了 9.5 个百分点的性能。
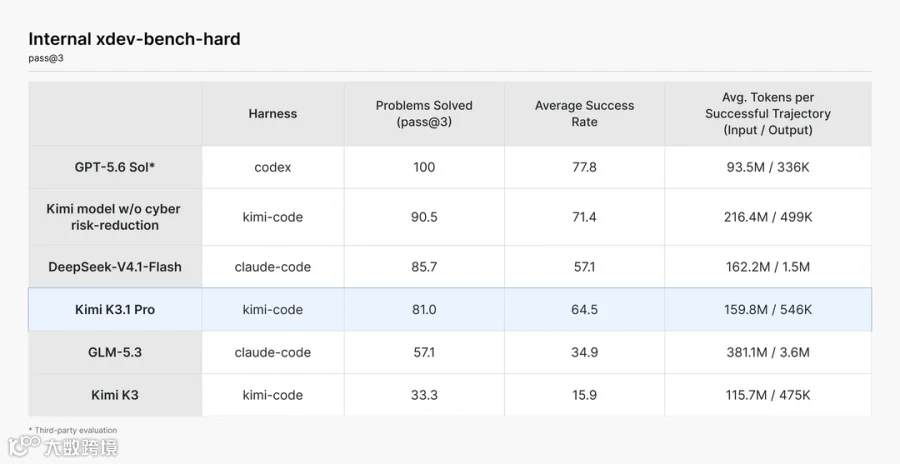
内部 xdev-bench-hard:不做数据清洗的检查点解 90.5%,最终发布版 81.0%
官方表示,此举旨在避免开源权重扩展网络攻击能力的绝对前沿,通过让安全能力渐进扩散而非集中在少数闭源系统中,长远来看有助于提升整体软件生态的安全性。
定价与成本:单价降低,单任务成本持平
Kimi K3.1 Pro 的 API 定价全面下调 33%:输入每百万 token 2 美元,输出 10 美元,缓存命中 0.2 美元。然而,由于模型在智能指数任务上的平均输出 token 数从 K3 的 4.8 万增加至 5.5 万(增幅 14%),抵消了单价下降的影响,使得单任务成本维持在 1.98 美元左右,与前代基本持平。这意味着用户以相同的成本获得了更强的模型能力。
行业意义:开源模型逼近闭源顶尖水平
开源与闭源模型之间 3 分的差距具有重要的行业象征意义。过去 12 分的差距意味着「开源够用但不够强」,而 3 分的差距则表明开源模型已具备极强的竞争力。值得注意的是,此次性能跃升并非依赖更大的基座或参数堆叠,而是通过后训练基础设施(训练流程、RL 环境、沙箱调度等)的工程化优化实现。
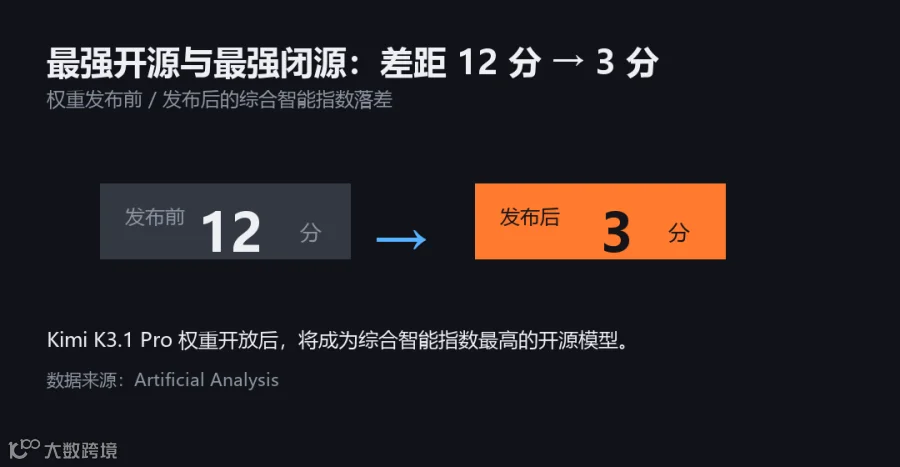
开源与闭源的差距从 12 分收窄到 3 分
尽管在综合排名和知识类评测上仍与最强闭源模型存在细微差距,但 Kimi K3.1 Pro 证明了当基座能力趋同时,后训练基础设施的成熟度成为拉开差距的关键。随着 11 月 4 日权重的正式开放,开源模型首次站在距离最强闭源模型仅 3 分的位置,这标志着「为了省钱牺牲能力」的时代正在终结,用户将获得更多元且高效的选择。