

导读RoPE 用各自的绝对位置旋转 Q/K,让两者的相对位移参与注意力打分。同一组坐标使用相同的旋转频率,两者角度相减时,位置项便成为位置之差。从二维例子到高维分组,可以看清这套机制怎样接入 Transformer,以及为什么能计算更远的位置,仍不代表能用好更长的文本。
本文 2358 字,阅读约 6 分钟
Q/K 比较内容时,顺序从哪里来
绝对位置与相对位置,分别提供什么
RoPE 旋转的是向量中的成对坐标
各自按绝对位置旋转,为何得到相对距离
能计算更长的位置,为什么还需要扩窗方法
Q/K 比较内容时,顺序从哪里来
“小猫追小狗”和“小狗追小猫”,用到的词相同,表达的关系却不同。这里只按词举例,实际模型处理的是分词后的 token。
把这些词分别变成向量,再生成 Q、K、V,Q/K 的点积用于计算匹配分数,V 提供待汇总的信息。对于无位置输入、无掩码的自注意力,交换输入顺序,输出也会按同样的方式交换。这套计算能比较内容,却没有直接给出每个词的先后坐标。
在 decoder-only 模型中,因果 Mask 让不同位置能看到的前缀不同,已经打破了上述对称性。关于无显式位置编码的因果语言模型,研究也观察到它们能在训练后学到位置信息。
因果 Mask 规定某个位置可以访问哪些 token;显式位置编码则直接向网络提供位置表示。理解 RoPE,要接着看:位置表示加在哪里,注意力又怎样使用它?
Q、K、V 到底在算什么?把因果 Mask 放进 attention 的每一步
绝对位置与相对位置,分别提供什么
绝对位置描述“这是序列中的第几个 token”。一种做法是给每个位置准备一条与词向量同维的位置向量,再逐项相加。
例如,同一个词出现在位置 2 和位置 5,词嵌入相同,但加上的位置向量不同。得到的输入随后进入 Transformer,生成的 Q/K/V 也就能受到位置影响。
位置向量可以随训练一起学习,也可以用固定函数计算。原始 Transformer 使用不同频率的正弦、余弦函数:随着位置增长,有些维度变化快,有些变化慢,组合成各位置的数值表示。正弦、余弦的数值由公式确定,模型仍需学习怎样利用它们。
相对位置描述两个位置之间的位移。位置 2 到位置 5、位置 5 到位置 8,都是向后移动 3 步。虽然绝对编号不同,两者的位移关系相同。这里的步数按 token 的位置索引计算。
一种相对位置做法,是根据位移给注意力分数加上一个数,这个附加值称为偏置。例如,两对 token 都相隔 3 步、方向也相同,就可以使用同一个偏置,让这类位置关系得到相同的分数调整。RoPE 则通过旋转向量,让位移参与点积本身。
绝对位置向量也能帮助模型学习相对关系。这里对照的是位置进入计算的方式:RoPE 将相对关系直接写进 Q/K 的点积结构。
RoPE 旋转的是向量中的成对坐标
RoPE,全称 Rotary Position Embedding,即旋转位置编码。先看一个二维向量,它可以画成平面中的箭头:两个数描述箭头在两条坐标轴上的分量。
将箭头旋转一个角度,它的长度不变,两个坐标通常会改变。若原坐标为 a、b,旋转角为 φ,新坐标就是:
a′ = a cosφ − b sinφ
b′ = a sinφ + b cosφ
这里的 φ 由位置决定。对于某一对坐标,设每前进一个位置增加的角度为 θ,那么位置 m 对应的旋转角就是 mθ。Q 和 K 的对应坐标对使用同一个 θ,各自的位置决定最终转多少。标准形式中的基础频率预先设定,内容向量则来自模型的可学习投影。
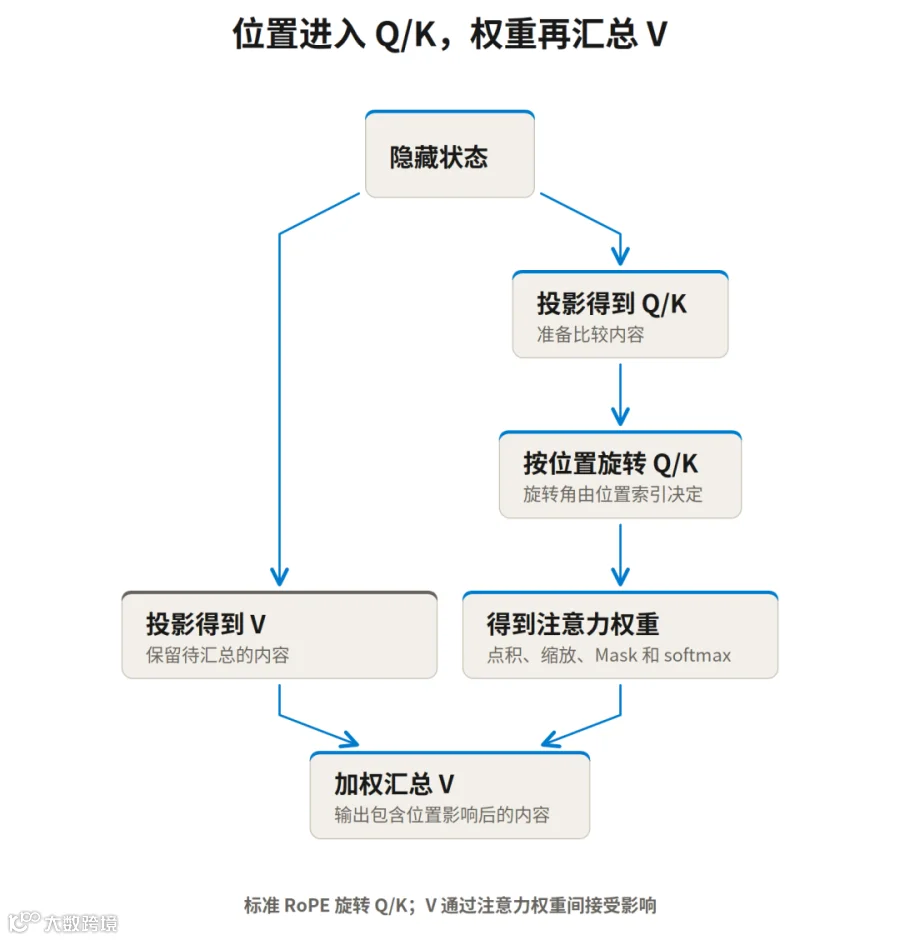
RoPE 在注意力层内,先取得投影后的 Q/K,再按位置旋转其中的坐标对。这一步在各层的注意力计算中重复执行,每层使用自己生成的 Q/K。旋转改变的是向量的数值表示,token 在序列中的位置保持原样。
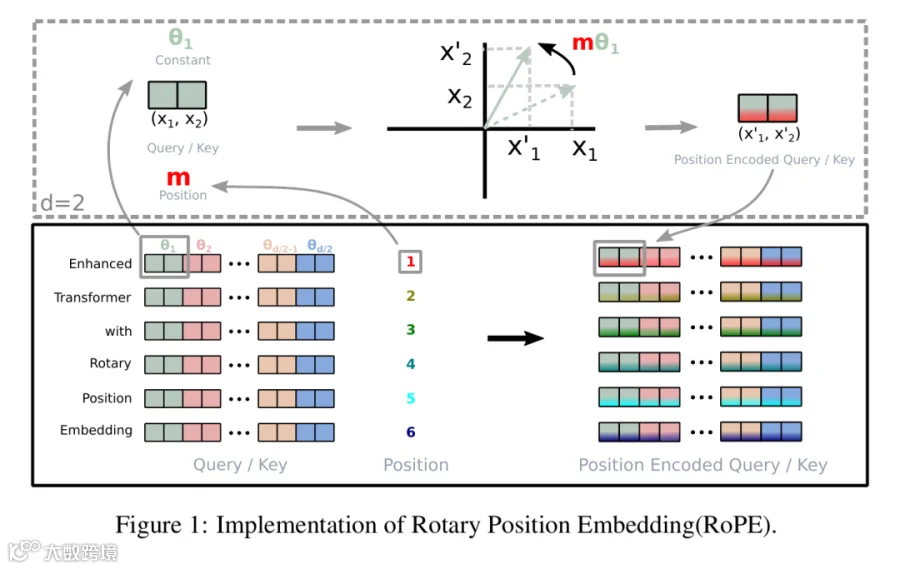 上方展示一对坐标按位置旋转,下方展示高维 Q/K 分组处理;各组使用不同的旋转频率 | 来源:RoFormer 论文 v5,图 1
实际注意力头的向量不止两维。按论文的相邻配对写法,若某个头有 8 维,就分成四对,各自在二维平面里转动,最后仍是 8 维向量。
这些组的转速不同。以论文基础值 10000、8 维的示意为例,四组每前进一步分别转 1、0.1、0.01、0.001 弧度。同一次位置变化,在不同组中对应不同的旋转角度,多组结果共同参与后续点积。
在这里解释的标准用法中,V 不做这一步位置旋转。旋转后的 Q/K 先做点积,再经过缩放、因果 Mask 和 softmax,得到汇总 V 的权重。位置关系通过权重影响 V 的加权聚合。
各自按绝对位置旋转,为何得到相对距离
关键在两个旋转后的向量怎样做点积。
二维向量的点积,等于两者长度的乘积,再乘夹角的余弦。旋转不改变长度,却会改变两者之间的角度。
设未旋转时,Q、K 的方向角分别是 α、β。Q 在位置 m,额外转 mθ;K 在位置 n,额外转 nθ。由于对应坐标对共用 θ,按“K 减 Q”的顺序计算方向角之差,得到:
(β + nθ) − (α + mθ) = (β − α) + (n − m)θ
式中的位置项是 nθ − mθ = (n − m)θ:两个绝对位置相减,留下相对位移;原来由内容决定的角度差 β−α 也保留下来。例如,Q 在位置 4、K 在位置 2,位移就是 −2,表示 K 位于 Q 之前两个位置。
因此,绝对位置决定各自怎样旋转,相对位移决定两者额外产生的角度差。这就把按绝对位置执行的操作,接到了包含相对位置关系的点积上。
换成一个可以算清的教学例子:让未旋转的 Q、K 都取长度为 1 的向量 (1,0),并假设每个位置转 30°。这里的 30°用于演示,不是模型默认配置。
Q 在位置 4 时转了 120°,K 在位置 2 时转了 60°。两者方向角之差为 −60°,几何夹角为 60°;长度都为 1,所以点积就是 1 × 1 × cos60° = 0.5。
将两者都后移 3 步,相当于给两个箭头各加转 90°。Q、K 分别转到 210°和 150°,方向角之差仍是 −60°,点积也仍为 0.5。两幅图中的箭头方向变了,它们之间的夹角保持不变。

高维时,每对坐标按自己的频率完成同样的计算,各组的点积贡献再相加,位置项仍通过 n−m 参与。
这里保持不变的是未旋转的 Q/K。真实模型中,前缀和上下文变化会改变隐藏状态,进而改变 Q/K,不能据此推断整个网络的输出也不变。
相对位移与内容共同决定点积。相隔同样远的两对 token,仍可能得到不同分数;距离增大时,任意一对向量的分数也不保证逐步下降。
能计算更长的位置,为什么还需要扩窗方法
理解了位置怎样进入点积,还剩一个问题:模型训练时只见过较短序列,能否直接把同一套 RoPE 用到更长的输入上?
在位置函数里继续代入更大的索引,数值当然能算出来。这是在位置表示层面直接向训练长度之外外推。
但公式有定义,不代表模型熟悉新的距离组合。Position Interpolation 论文检查了早期 LLaMA:直接使用超出训练范围的位置,可能使语言建模表现严重退化。
位置插值(Position Interpolation)选择先缩放坐标。例如,想把原来 2048 的窗口扩到 4096,就将送入 RoPE 的位置索引除以 2:实际位置 3000 使用坐标 1500;相邻 token 的位置间隔从 1 变成 0.5。
更多 token 仍在输入里,压缩的是位置坐标及其间距。用缩放后的坐标计算旋转角,就能让更长输入所用的位置范围回到原来的训练范围内。
 上图向右延伸到未见位置,下图把更长序列的位置坐标缩半;下图的 4096 标记实际序列位置,送入 RoPE 的坐标已压回原范围。这是机制示意,不是效果曲线 | 来源:Position Interpolation 论文 v2,图 1
坐标变密以后,同样相隔若干 token,产生的位置旋转差也变小了,模型需要适应新的对应关系。论文将插值与进一步训练结合,并分别检查语言建模、信息检索和长文摘要。因此,扩窗效果要看调整后是否经过适应,以及具体任务的验证结果。
RoPE 说明了怎样让相对位移参与内容匹配;把输入变长,还要跨过训练适应和任务验证两道关。位置函数能算到哪里、模型学会处理到哪里、任务实际能利用到哪里,需要分别验证。
参考资料
•Attention Is All You Need,输入位置向量与正弦编码,§3.5: https://arxiv.org/pdf/1706.03762v7
•RoFormer: Enhanced Transformer with Rotary Position Embedding,旋转机制、相对位移与原始示意图: https://arxiv.org/pdf/2104.09864v5
•Transformer Language Models without Positional Encodings Still Learn Positional Information,因果语言模型的隐式位置意识: https://arxiv.org/pdf/2203.16634
•Extending Context Window of Large Language Models via Position Interpolation,位置缩放、适应训练与验证边界: https://arxiv.org/pdf/2306.15595v2
文章仅做学术分享,如有侵权请联系删除,非常感谢!