

一次大模型训练,几万块卡同时在算,每走一步都要互相交换数据。
这时候某个交换机端口拥塞了,或者某个光模块性能开始波动。单看是个很小的故障,放进集群里,就可能让一大片卡停下来等这一条链路。故障拖得越久,空转的算力越多。
集群越大,这种事越难躲。设备成千上万,链路错综复杂,问题藏在哪、会波及哪些任务,靠人一台台去查根本来不及。
这两天在成都举办的 2026 中国计算机大会(CNCC 2026)上,中科曙光发布了 Fabricview 智算网络管理平台,瞄准的就是这个问题。

高速互连之外,还得管得住
曙光高级副总裁李斌在大会演讲里,给这类问题放了一个更大的框架。他的判断是,大规模、高通量的推理集群,Token 生产效率更高;围绕“超节点+超集群”做一体化系统工程,是提升 Token 生产效率的重要方向。
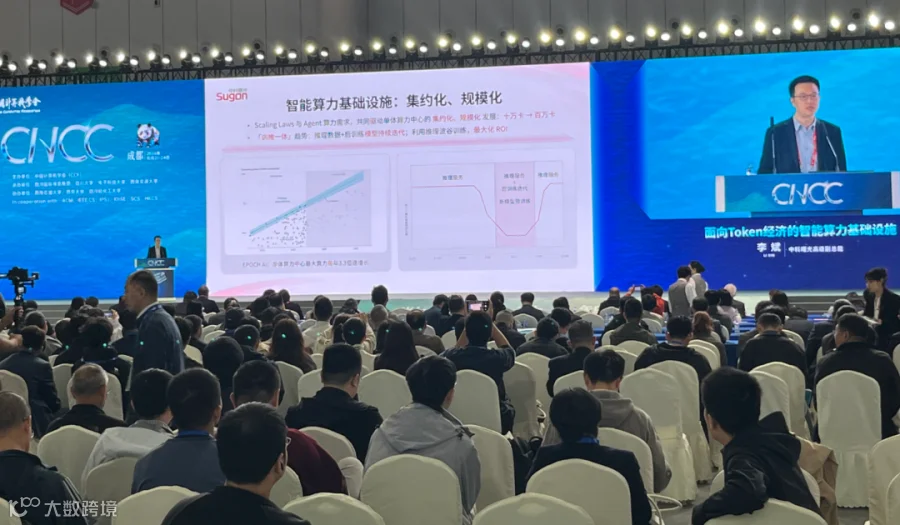
网络在这里的角色,是把成千上万的计算资源连起来。高速互连决定数据传得多快,管理能力决定这套系统能不能一直稳定地跑。两头都得顾上,卡的性能才能真正用出来。
Fabricview 就是冲着管理这一头去的。
百万量级,一个平台收口
它能集中纳管百万量级的设备、端口和光模块。集群规模一上来,交换机、网卡、光模块、链路的数量跟着涨,连接关系也越来越复杂。运维人员真正的难题,是在海量设备和链路里尽快发现异常,并判断它会影响哪些业务。
Fabricview 把分散的网络资产、连接关系和运行信息收进一个平台,用自动发现、全网监测和配置管理,替掉大量人工检查和重复操作。网络从部署、日常维护到运行保障,变成一个连续的管理过程。
再往上一层,是智能运维。平台会把网络状态和运行信息关联起来分析,为故障定位和处置提供依据,还会结合运维知识和项目经验给出分析建议。性能筛查、异常分析这些原本很依赖资深运维经验的活,开始往自动化、智能化走。
十万卡里磨出来的经验
这个产品有个值得说的来历。
曙光的 scaleFabric 高速网络,已经在十万卡级集群里有过工程积累。十万卡这个量级,网络会碰到什么问题、哪些故障最常见、怎么排查最快,都是一个个项目里磨出来的。Fabricview 做的,就是把这些实践经验沉淀成软件能力。
换句话说,scaleFabric 负责把路修好,Fabricview 负责让路一直通畅。网络建设和网络管理放在一起考虑,也正是李斌强调的一体化思路。
卡要买得到,更要用得满
衡量这类产品,最后看两个结果:任务执行效率,服务稳定性。性能异常发现得早,故障排查时间缩短,设备等待和任务中断就少,更多算力就能用在模型训练和 Token 生成上。
现在行业越来越习惯用 Token 衡量算力的产出。规模可以靠堆卡,但堆上去的卡能不能都在干活,很大程度取决于网络。Fabricview 的发布,意味着曙光把网络管理也并进了自己的系统工程体系,高速互联、运行维护和业务需求开始在一套体系里协同。
对正在建大集群的客户来说,这可能比多几张卡更实在。