

目录
-
• 📌 一、背景 -
• 📐 二、流水线深度规划 -
• ⚙️ 三、级内设计约束 -
• 🧩 四、可配置微架构的基石 -
• 🔍 五、组合与流水线的区别:以两级为例 -
• ♻️ 六、组合与流水线的复用:stage 不变 -
• 📊 七、数据验证:四种配置的真实对比 -
• 💡 八、代码复用的本质 -
• 🎯 九、总结
📌 一、背景
在数字芯片设计中,RTL 源代码的流水线深度不是随意定的。级数太少频率上不去,级数太多面积和延迟又吃不消。
更麻烦的是,同一个 RTL 设计在不同阶段往往需要不同的深度:
-
• 设计早期,功能验证优先,可能用纯组合快速迭代; -
• 设计中期,需要平衡频率和面积,可能用 2 到 3 级; -
• 设计后期,追求高频吞吐,可能用 8 到 10 级。
每次改深度,如果都重写 RTL,容易引入 bug,难以维护,代码也无法复用。数字芯片团队经常因此在版本之间反复修改同一段 RTL,既浪费时间,也增加验证负担。更严重的是,不同版本之间的功能不一致,往往在后期才暴露出来,排查成本极高。
🎯 本文目标:一套 RTL 代码,通过参数和边界开关,支持组合与流水线之间自由切换,并说清楚两者的区别和复用原理。
📐 二、流水线深度规划
2.1 深度估算
级数主要受四个因素约束:
基本估算:
比如总延迟 12ns,目标周期 3.3ns,大约需要 4 级。但实际不能简单相除。每级延迟不可能完全相等,还要按逻辑块的自然边界调整。如果硬把一个完整的乘法树从中间切开,跨边界的中间信号会非常多,寄存器开销反而增大。
💡 先按逻辑块切分,再在慢的那一块内部细分。比如乘法树可拆成
booth编码和wallace树两级。
2.2 逻辑块的自然边界
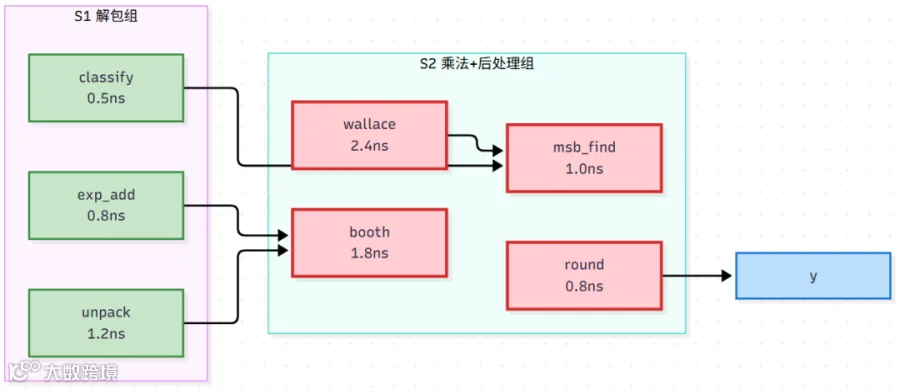
浮点乘法器的三个逻辑块,延迟天然不相等:
-
• S1总延迟约 2.5ns:解包、指数相加、分类,都是小逻辑块; -
• S2总延迟约 6.0ns:Booth 编码、Wallace 树、找最高位、舍入,乘法树占了大部分; -
• S2是瓶颈:比S1慢一倍多,决定整条流水线周期; -
• 跨组连接: S1输出送S2,S2输出到y; -
• 两级不均衡:如果目标是 3ns, S2还需要再拆,否则周期被它锁死在 6ns。
⚙️ 三、级内设计约束
3.1 级内逻辑同质
每一级应是一段边界清晰的组合逻辑:
-
• S1:解包、分类、指数相加; -
• S2:尾数乘法、规格化、打包。
不要在一级里混入性质差异很大的逻辑,否则这一级会被最慢的子模块拖慢。比如把一个小加法器和一个大乘法树放在同一级,加法器只需要 0.5ns,乘法树需要 5ns,整级就被乘法树锁死在 5ns,加法器的资源相当于浪费了。
⚠️ 就像生产线上,前面工位几秒钟,后面工位几分钟,整条线的节拍就被后面锁死了。
3.2 级间信号少
寄存器面积等于跨级信号位宽乘深度。跨级信号越多、位宽越大,寄存器开销越大。每增加一级,就多一组全位宽的触发器,10 级流水线的寄存器面积可能是 1 级的十倍。
减少跨级信号的做法:
-
• 能早算的信号尽早算完; -
• 特殊值标志压缩成少量位; -
• 避免大数组跨级传递。
3.3 每级延迟均衡
这是最核心的约束。如果某一级延迟远大于其他级,整条流水线的时钟周期就被这一级锁死了。其他级再快也没用,它们每拍都有大量空闲,但空闲无法用来处理其他数据。
💡 两级不均衡时,要么拆
S2,要么把S1的一部分逻辑挪到S2前面,让两段更接近。
🧩 四、可配置微架构的基石
要把一套 RTL 变成可变深度微架构,需要四个东西:纯组合 stage、泛化边界寄存器、统一接口、编译期配置。这四样东西各司其职,缺一不可。
4.1 纯组合 stage:S1 解包
   module stage1_unpack (
    input  logic [31:0] a,
    input  logic [31:0] b,
    input  logic        in_valid,
    output fp32_pkg::s1_t out
);
    logic [7:0] ea, eb;

    assign ea = a[30:23];
    assign eb = b[30:23];

    assign out.valid   = in_valid;
    assign out.sign    = a[31] ^ b[31];
    assign out.ma      = (ea == 0) ? {1'b0, a[22:0]} : {1'b1, a[22:0]};
    assign out.mb      = (eb == 0) ? {1'b0, b[22:0]} : {1'b1, b[22:0]};
    assign out.exp_sum = {1'b0, ea} + {1'b0, eb};

    assign out.a_nan   = (ea == 8'hFF) && (a[22:0] != 0);
    assign out.b_nan   = (eb == 8'hFF) && (b[22:0] != 0);
    assign out.a_inf   = (ea == 8'hFF) && (a[22:0] == 0);
    assign out.b_inf   = (eb == 8'hFF) && (b[22:0] == 0);
    assign out.a_zero  = (ea == 0)     && (a[22:0] == 0);
    assign out.b_zero  = (eb == 0)     && (b[22:0] == 0);
endmodule
-
• 只做解包、分类、指数相加; -
• 没有 clk、rst_n,不依赖时钟和复位; -
• 输出只取决于输入,是纯函数; -
• 特殊值标志随包一起透传,下游不需要重新解析原始浮点位。
4.2 纯组合 stage:S2 乘法
   module stage2_mul (
    input  fp32_pkg::s1_t in,
    output fp32_pkg::s2_t out
);
    assign out.valid   = in.valid;
    assign out.sign    = in.sign;
    assign out.prod    = in.ma * in.mb;
    assign out.exp_sum = in.exp_sum;
    assign out.a_nan   = in.a_nan;
    assign out.b_nan   = in.b_nan;
    assign out.a_inf   = in.a_inf;
    assign out.b_inf   = in.b_inf;
    assign out.a_zero  = in.a_zero;
    assign out.b_zero  = in.b_zero;
endmodule
-
• 只做乘法,不掺杂其他逻辑; -
• 可以映射到 DSP 硬核; -
• 上下文原样透传,不重新计算; -
• 单独综合、单独仿真。
4.3 纯组合 stage:S3 规格化 + 舍入 + 打包
   module stage3_norm_round_pack (
    input  fp32_pkg::s2_t in,
    output fp32_pkg::s3_t out
);
    // 找最高位
    logic [5:0] msb_idx;
    always_comb begin
        msb_idx = 6'd0;
        for (int i = 0; i < 48; i++)
            if (in.prod[i]) msb_idx = i[5:0];
    end

    // 规格化
    logic [5:0]  shamt;
    logic [47:0] norm;
    assign shamt = 6'd47 - msb_idx;
    assign norm  = in.prod << shamt;

    // 指数修正
    logic signed [11:0] exp_biased;
    assign exp_biased = $signed({3'b0, in.exp_sum})
                      + $signed({6'b0, msb_idx})
                      - 12'sd173;

    // RNE 舍入
    logic [23:0] mant24;
    assign mant24 = norm[47:24];

    logic guard, sticky, lsb;
    assign guard  = norm[23];
    assign sticky = |norm[22:0];
    assign lsb    = mant24[0];

    logic [24:0] mant_rnd;
    always_comb begin
        if (guard && (sticky || lsb))
            mant_rnd = {1'b0, mant24} + 1'b1;
        else
            mant_rnd = {1'b0, mant24};
    end

    logic [23:0] mant_final;
    logic signed [11:0] exp_final;
    always_comb begin
        if (mant_rnd[24]) begin
            mant_final = mant_rnd[24:1];
            exp_final  = exp_biased + 12'sd1;
        end else begin
            mant_final = mant_rnd[23:0];
            exp_final  = exp_biased;
        end
    end

    // 打包,特殊值优先
    logic [31:0] y_result;
    always_comb begin
        if (in.a_nan || in.b_nan)
            y_result = {in.sign, 8'hFF, 23'h400000};
        else if (in.a_inf || in.b_inf) begin
            if ((in.a_inf && in.b_zero) || (in.b_inf && in.a_zero))
                y_result = {in.sign, 8'hFF, 23'h400000};
            else
                y_result = {in.sign, 8'hFF, 23'd0};
        end
        else if (in.a_zero || in.b_zero)
            y_result = {in.sign, 31'd0};
        else if (in.prod == 48'd0)
            y_result = {in.sign, 31'd0};
        else if (exp_final >= 12'sd255)
            y_result = {in.sign, 8'hFF, 23'd0};
        else if (exp_final <= 12'sd0)
            y_result = {in.sign, 31'd0};
        else
            y_result = {in.sign, exp_final[7:0], mant_final[22:0]};
    end

    assign out.valid = in.valid;
    assign out.y     = y_result;
endmodule
-
• 只做规格化、舍入、打包; -
• 纯组合,无状态; -
• 输出 s3_t,只含valid和y; -
• 三个 stage 拼接后就是一个完整浮点乘法器。
4.4 泛化边界寄存器
   module pipe_reg #(
    parameter int W = 64
) (
    input  logic clk, rst_n,
    input  logic [W-1:0] din,
    output logic [W-1:0] dout
);
    always_ff @(posedge clk or negedge rst_n) begin
        if (!rst_n) dout <= '0;
        else        dout <= din;
    end
endmodule
-
• 一个模块复用于所有边界; -
• 例化时传 $bits(s1_t),自动适配位宽; -
• 避免重复写 always_ff,减少出错; -
• 位宽参数 W泛化,不同边界传不同值; -
• 例化示例: pipe_reg #(.W($bits(fp32_pkg::s1_t))) u_b1 (...);
4.5 统一接口
   typedef struct packed {
    logic        valid;
    logic        sign;
    logic [23:0] ma;
    logic [23:0] mb;
    logic [8:0]  exp_sum;
    logic        a_nan, b_nan;
    logic        a_inf, b_inf;
    logic        a_zero, b_zero;
} s1_t;

typedef struct packed {
    logic        valid;
    logic        sign;
    logic [47:0] prod;
    logic [8:0]  exp_sum;
    logic        a_nan, b_nan;
    logic        a_inf, b_inf;
    logic        a_zero, b_zero;
} s2_t;

typedef struct packed {
    logic        valid;
    logic [31:0] y;
} s3_t;
-
• valid打包进结构体,跟着数据一起走; -
• 边界寄存器只处理一个信号,不需要区分 data 和 valid; -
• valid延迟自动对齐,不会和数据错位; -
• 加字段只改 struct定义,其他模块不动; -
• s1_t约 65 位,s2_t约 65 位,s3_t33 位。
4.6 编译期配置
   generate
    if (REG_EN[0]) begin : g_b1_reg
        pipe_reg #(.W($bits(fp32_pkg::s1_t))) u_b1 (
            .clk(clk), .rst_n(rst_n),
            .din(s1_out), .dout(b1_out)
        );
    end else begin : g_b1_wire
        assign b1_out = s1_out;
    end
endgenerate
-
• REG_EN[i]控制第i个边界是否插寄存器; -
• 1表示插寄存器,该边界变成时序; -
• 0表示直连,该边界保持组合; -
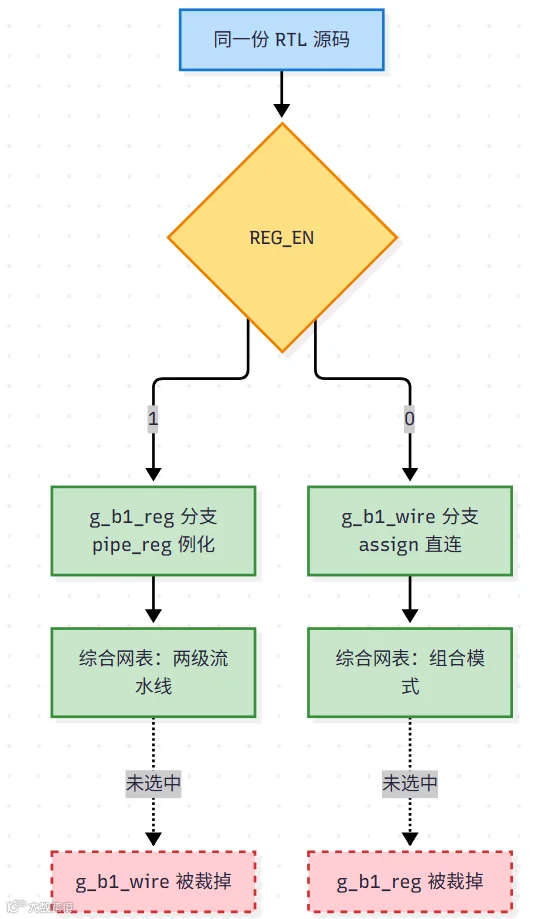
• 综合时只保留一个分支,未选中的被完全裁掉。
🔍 五、组合与流水线的区别:以两级为例
5.1 完整数据通路对比
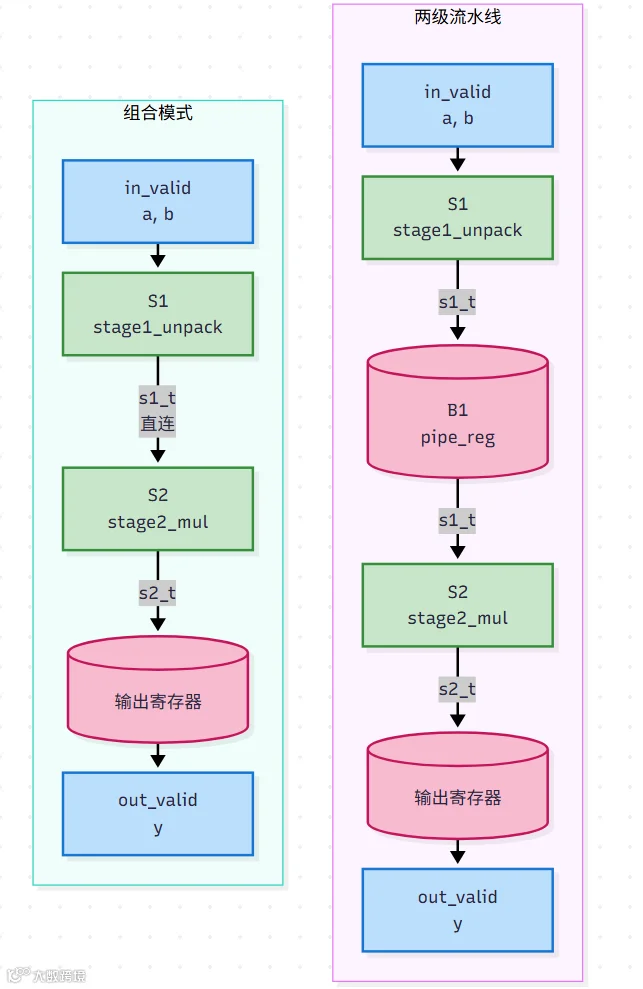
两级流水线和组合模式的完整结构,只在 B1 边界处不同:
-
• S1和S2完全相同:两种模式用的是同一份组合逻辑,综合网表里也是同一套门; -
• B1是唯一区别:流水线模式是pipe_reg,组合模式是直连; -
• 输出寄存器都保留:保证 out_valid和y对齐,延迟都是 1; -
• s1_t和s2_t接口完全相同:valid打包在包内,边界只管寄存一个整体; -
• 延迟差异:流水线 1 拍,组合 0 拍,正好差在 B1这一级。
5.2 RTL 对比:只差两行
   // 两级流水线:B1 是寄存器
always_ff @(posedge clk or negedge rst_n) begin
    if (!rst_n) b1_out <= '0;
    else        b1_out <= s1_out;
end
   // 组合模式:B1 是直连
assign b1_out = s1_out;
-
• 两级流水线:4 行,需要时钟和复位; -
• 组合模式:1 行,不需要时钟和复位; -
• 本质区别: B1有状态还是无状态; -
• stage 模块:两种模式完全相同; -
• 接口定义:两种模式完全相同。
5.3 一个区别,六个连锁差异
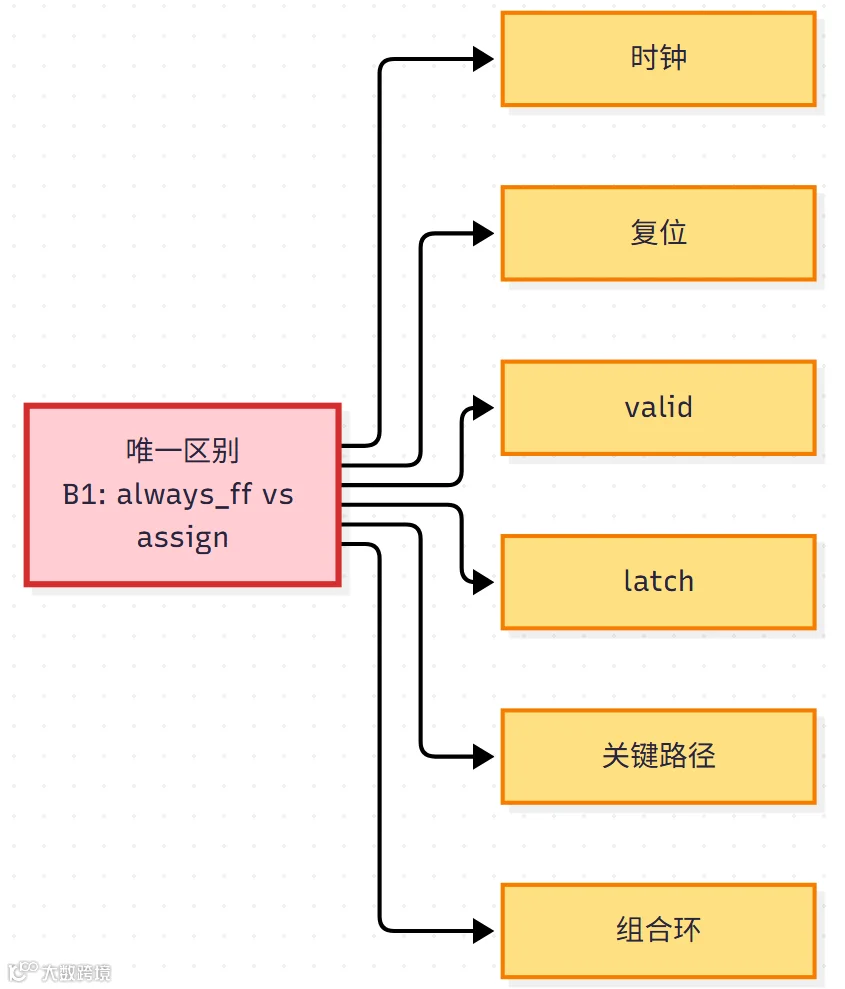
-
• 一个源头: B1是寄存器还是连线; -
• 六个连锁差异:由这一个区别派生; -
• valid无差异:因为打包在struct里,两种模式都不需要单独处理; -
• 组合模式更危险:没有寄存器兜底, latch、长路径、组合环都会直接暴露; -
• stage不受影响:两种模式完全相同,复用不受影响。
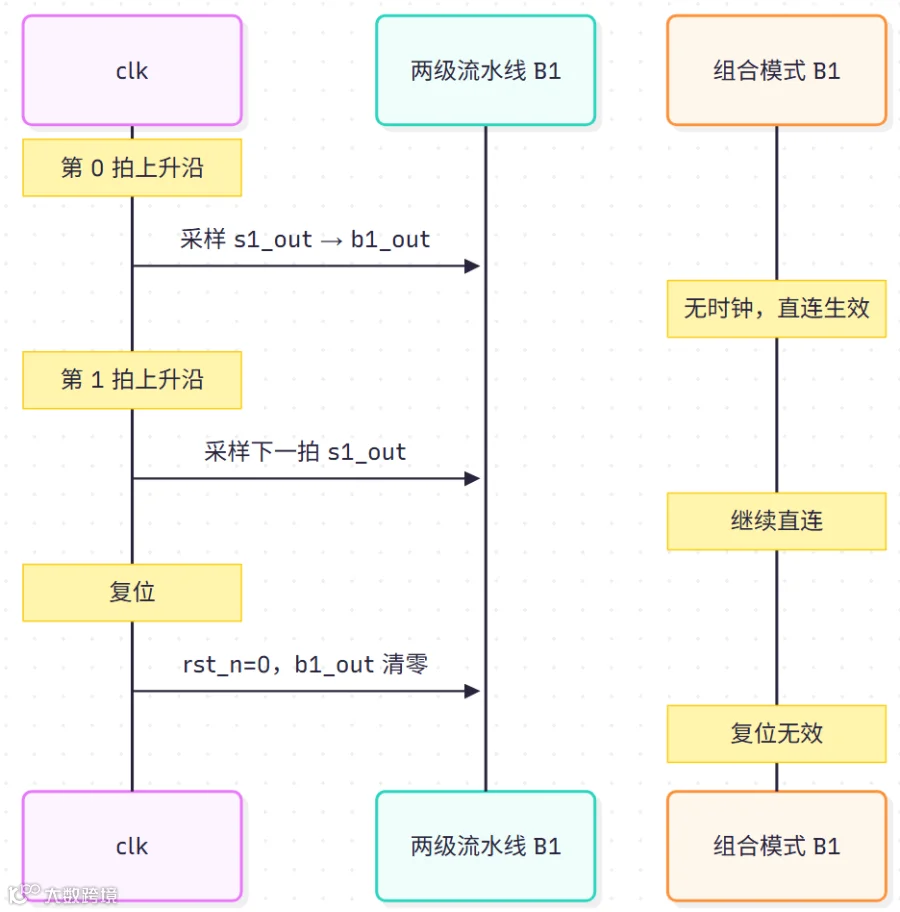
5.4 差异一:时钟与复位
-
• 两级流水线: B1在每个时钟沿采样,复位时清零,保证上电状态确定; -
• 组合模式: B1是纯连线,随时钟和复位无关,信号立即穿过; -
• clk端口保留:因为输出寄存器还需要时钟,顶层接口不因模式而变; -
• rst_n端口保留:组合模式下对B1无效,但对输出寄存器有效; -
• 综合裁剪:组合模式下 B1的always_ff分支被完全裁掉,不消耗触发器。
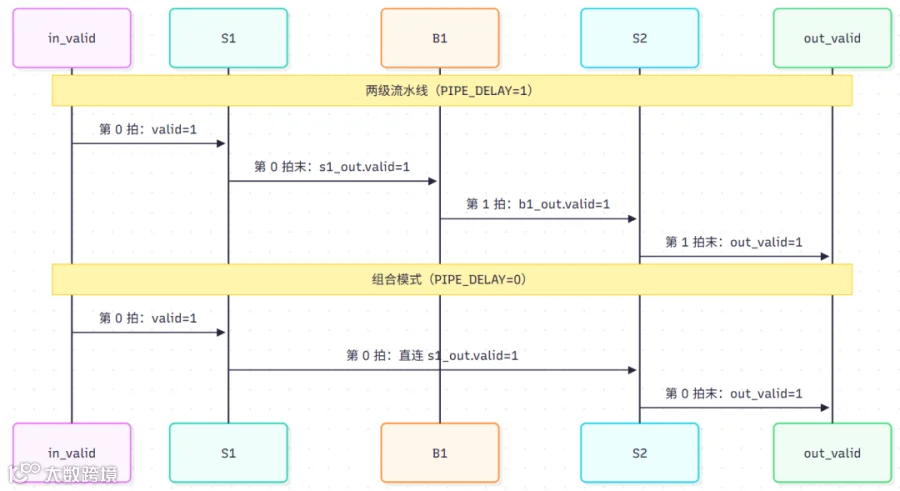
5.5 差异二:valid 对齐
-
• 两级流水线: valid被B1打一拍,和data一起延迟; -
• 组合模式: valid直通,和data同一拍; -
• 共同点:都不需要单独处理 valid,因为打包在struct里; -
• 打包的价值:边界是寄存器就自动打拍,是连线就自动直通,无需区分; -
• 延迟公式: PIPE_DELAY = popcount(REG_EN),由配置自动推导。
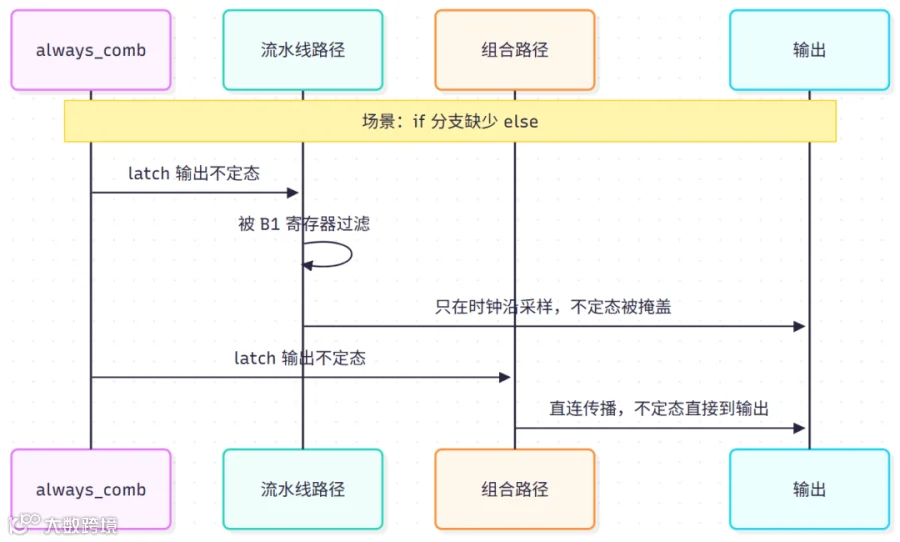
5.6 差异三:latch 行为
-
• 两级流水线:latch 的不定态被寄存器过滤,仿真可能"看起来正常",隐患被推迟到后期; -
• 组合模式:latch 的不定态直接传播到下游,输出错误值,问题立即暴露; -
• 仿真风险:组合模式可能仿真和综合不一致,因为仿真器对 latch 的建模和综合不同; -
• 防范方法: always_comb所有分支都赋值,包括else和default; -
• 默认值:在 always_comb开头给所有输出赋默认值,是最稳妥的写法。
5.7 差异四:关键路径

-
• 两级流水线: B1把路径切成两段,周期取最大值 6.0ns; -
• 组合模式: S1和S2串联,周期必须 8.5ns; -
• 频率差距:组合模式频率只有流水线的 70%,这是流水线最核心的收益; -
• 两级不均衡: S2比S1慢,所以周期由S2决定,S1有空闲; -
• 重新切分:如果 S2太慢,可以把S2再拆一级,让周期降到 4ns 左右。
5.8 差异五:组合环

-
• 两级流水线: B1寄存器切断反馈,环被打破,反馈走的是上一拍的值; -
• 组合模式: s2_out → S1 → S2 → s2_out直接成环,同一拍内无限循环; -
• 仿真报错: Zero-delay loop detected,仿真器检测到死循环后终止; -
• 综合报错:组合环被综合工具拒绝,无法生成网表; -
• 设计原则:组合模式下必须避免反馈,任何反馈都要经过寄存器。
5.9 差异汇总
5.10 结构实证:时钟接入模块数随流水级数增加
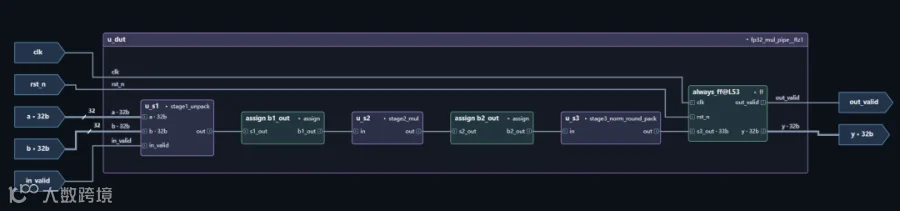
前面从逻辑和行为上分析了两者的差异。从综合/elaboration 后的连接图上,可以更直观地看到时序化的程度:流水级数越多,接入时钟信号的模块越多,组合路径被寄存器切分得越细。
0 级流水线(纯组合)
-
• 时钟只接入输出寄存器:组合逻辑 S1 → S2之间没有额外寄存器; -
• 组合路径最长: S1和S2串联,关键路径为两者之和; -
• 时序单元最少:只有输出寄存器一组触发器; -
• 时钟负载最小:时钟树只驱动输出寄存器; -
• 对应 REG_EN=2'b00:所有边界直连。
1 级流水线(插入 1 个边界寄存器)

-
• 时钟接入输出寄存器 + 1 个边界寄存器:组合路径被切成两段; -
• 关键路径缩短:从 S1+S2变为max(S1, S2); -
• 时序单元增加一组:边界寄存器接入时钟; -
• 时钟负载增加:时钟树多驱动一组触发器; -
• 对应 REG_EN=2'b01或2'b10:一个边界插寄存器。
2 级流水线(插入 2 个边界寄存器)

-
• 时钟接入输出寄存器 + 2 个边界寄存器:组合路径被切成三段; -
• 关键路径进一步缩短:每段只包含一个 stage; -
• 时序单元再增加一组:第二个边界寄存器接入时钟; -
• 时钟负载继续增加:时钟树驱动三组触发器; -
• 对应 REG_EN=2'b11:两个边界都插寄存器。
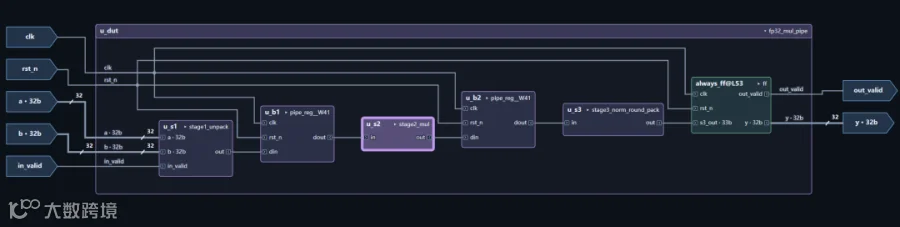
3 级流水线(插入 3 个边界寄存器)
-
• 时钟接入输出寄存器 + 3 个边界寄存器:组合路径被切成四段; -
• 关键路径最短:每段只包含一个更细的逻辑块; -
• 时序单元最多:三组边界寄存器全部接入时钟; -
• 时钟负载最大:时钟树驱动四组触发器; -
• 频率潜力最高:但面积和时钟功耗也最大。
从这四幅图可以清楚看到:每增加一级流水,就多一组边界寄存器接入时钟,组合逻辑被进一步隔离。这正是 REG_EN 位向量控制边界寄存器的物理体现,也是“级数越多、时序化程度越高、关键路径越短”的结构证据。
♻️ 六、组合与流水线的复用:stage 不变
6.1 复用的是什么
复用的核心:stage 和接口完全相同,只有边界的写法不同。 也就是说,真正随模式变化的只有边界那几行代码,其他所有 RTL 都不需要改。
6.2 为什么 stage 能复用
   module stage2_mul (
    input  fp32_pkg::s1_t in,
    output fp32_pkg::s2_t out
);
    assign out.prod = in.ma * in.mb;
endmodule
-
• 没有 clk:不依赖时钟,任何模式都能用; -
• 没有 rst_n:不依赖复位,无状态; -
• 没有 always_ff:不存储状态,纯函数; -
• 输出只取决于输入:相同的输入永远得到相同的输出; -
• 可以任意拼接:放在哪里都一样,与上下文无关。
如果 stage 内部有 always_ff,它就被绑定成"一级流水线",无法在组合模式下使用。 这是复用失效的最常见原因。
6.3 用 generate 统一两种模式
   module fp32_mul_pipe #(
    parameter bit [1:0] REG_EN = 2'b11
) (
    input  logic        clk,
    input  logic        rst_n,
    input  logic        in_valid,
    input  logic [31:0] a,
    input  logic [31:0] b,
    output logic        out_valid,
    output logic [31:0] y
);
    fp32_pkg::s1_t s1_out, b1_out;
    fp32_pkg::s2_t s2_out, b2_out;
    fp32_pkg::s3_t s3_out;

    stage1_unpack u_s1 (
        .a(a), .b(b), .in_valid(in_valid), .out(s1_out)
    );

    generate
        if (REG_EN[0]) begin : g_b1_reg
            pipe_reg #(.W($bits(fp32_pkg::s1_t))) u_b1 (
                .clk(clk), .rst_n(rst_n),
                .din(s1_out), .dout(b1_out)
            );
        end else begin : g_b1_wire
            assign b1_out = s1_out;
        end
    endgenerate

    stage2_mul u_s2 (.in(b1_out), .out(s2_out));

    generate
        if (REG_EN[1]) begin : g_b2_reg
            pipe_reg #(.W($bits(fp32_pkg::s2_t))) u_b2 (
                .clk(clk), .rst_n(rst_n),
                .din(s2_out), .dout(b2_out)
            );
        end else begin : g_b2_wire
            assign b2_out = s2_out;
        end
    endgenerate

    stage3_norm_round_pack u_s3 (.in(b2_out), .out(s3_out));

    always_ff @(posedge clk or negedge rst_n) begin
        if (!rst_n) begin
            out_valid <= 1'b0;
            y         <= 32'd0;
        end else begin
            out_valid <= s3_out.valid;
            y         <= s3_out.y;
        end
    end
endmodule
-
• REG_EN[0]控制B1:S1和S2之间; -
• REG_EN[1]控制B2:S2和S3之间; -
• stage不变:三个 stage 模块完全相同; -
• 接口不变: s1_t、s2_t、s3_t完全相同; -
• 综合裁剪:未选中的分支被完全裁掉,不消耗任何资源; -
• 延迟自动推导: PIPE_DELAY = popcount(REG_EN)。
6.4 generate 的编译期裁剪
-
• 一份源码: rtl/目录只有几个文件,不需要为每种模式维护一份; -
• 两种网表: REG_EN选择分支,综合出不同结构; -
• 零浪费:未选中的分支被编译器完全裁掉,不留任何痕迹; -
• generate是编译期:不是运行时 MUX,不消耗额外面积和延迟; -
• 配置固定: REG_EN一旦确定,综合结果就固定,不会运行时改变。
6.5 复用的三个前提

-
• stage纯组合:任意拼接,不绑定深度,组合和流水线共用; -
• 接口稳定:只依赖 struct,与模式无关,改边界不改接口; -
• valid打包:边界自动处理,不需要单独赋值,延迟自然对齐; -
• 三个前提缺一不可:任何一个不满足,复用就失效,就要维护多份 RTL; -
• 收益:一份代码支持两种模式,验证和综合都只需维护一套。
6.6 如果 stage 含寄存器会怎样
   // 错误:stage 内部有寄存器
module stage2_mul (
    input  logic clk,
    input  fp32_pkg::s1_t in,
    output fp32_pkg::s2_t out
);
    always_ff @(posedge clk) out.prod <= in.ma * in.mb;
endmodule
stage 内部一旦有寄存器,它就变成"固定一级",无法在组合模式下工作。 即使把 REG_EN=0,这一级仍然存在,延迟无法去掉。
6.7 如果 valid 不打包会怎样
   // 错误:valid 独立传递
module stage2_mul (
    input  logic in_valid,
    input  fp32_pkg::s1_t in,
    output logic out_valid,
    output fp32_pkg::s2_t out
);
    assign out.prod = in.ma * in.mb;
    assign out_valid = in_valid;
endmodule
valid 不打包,每个边界都要单独处理 valid,改深度时要同步改多处,容易错位。 尤其是流水线有气泡或反压时,valid 和 data 一旦不同步,结果就会写到错误的位置。
📊 七、数据验证:四种配置的真实对比
7.1 TB 核心逻辑
   #include "Vfp32_mul_pipe.h"
#include "verilated.h"
#include <cstdio>
#include <cstring>
#include <cstdint>
#include <random>
#include <vector>

#ifndef PIPE_DELAY
#error "PIPE_DELAY must be defined by CMake"
#endif

static uint32_t rand_fp32(std::mt19937 &rng) {
    uint32_t sign = rng() & 1;
    uint32_t exp  = 100 + (rng() % 55);   // 避免溢出和下溢
    uint32_t mant = rng() & 0x7FFFFF;
    return (sign << 31) | (exp << 23) | mant;
}

static uint32_t sw_mul(uint32_t a, uint32_t b) {
    float fa, fb;
    std::memcpy(&fa, &a, 4);
    std::memcpy(&fb, &b, 4);
    float fc = fa * fb;
    uint32_t c;
    std::memcpy(&c, &fc, 4);
    return c;
}

int main(int argc, char **argv) {
    Verilated::commandArgs(argc, argv);
    auto *top = new Vfp32_mul_pipe;

    std::mt19937 rng(20260225);
    const int N = 200;

    std::vector<uint32_t> qa(N), qb(N), exp_y(N);
    for (int i = 0; i < N; i++) {
        qa[i]    = rand_fp32(rng);
        qb[i]    = rand_fp32(rng);
        exp_y[i] = sw_mul(qa[i], qb[i]);
    }

    // 复位
    top->clk = 0; top->rst_n = 0;
    top->in_valid = 0; top->a = 0; top->b = 0;
    for (int i = 0; i < 4; i++) {
        top->clk = 0; top->eval();
        top->clk = 1; top->eval();
    }
    top->rst_n = 1;

    int errors = 0;
    int valid_checked = 0;
    int out_count = 0;
    int first_out_cycle = -1;
    int last_out_cycle  = -1;

    const int max_cycles = N + PIPE_DELAY + 20;
    int cycle = 0;

    for (; cycle < max_cycles; cycle++) {
        top->clk = 0;
        if (cycle < N) {
            top->in_valid = 1;
            top->a = qa[cycle];
            top->b = qb[cycle];
        } else {
            top->in_valid = 0;
            top->a = 0;
            top->b = 0;
        }
        top->eval();
        top->clk = 1;
        top->eval();

        int out_idx = cycle - PIPE_DELAY;
        if (out_idx >= 0 && out_idx < N) {
            valid_checked++;
            if (top->out_valid != 1) {
                printf("[ERR] cycle=%d idx=%d out_valid=%d\n",
                       cycle, out_idx, (int)top->out_valid);
                errors++;
            } else if ((uint32_t)top->y != exp_y[out_idx]) {
                if (errors < 10) {
                    printf("[ERR] cycle=%d idx=%d got=%08x exp=%08x\n",
                           cycle, out_idx,
                           (uint32_t)top->y, exp_y[out_idx]);
                }
                errors++;
            }
        }

        if (top->out_valid) {
            out_count++;
            if (first_out_cycle < 0) first_out_cycle = cycle;
            last_out_cycle = cycle;
        }

        if (out_count == N) break;
    }

    int total_cycles = cycle + 1;
    int fill_cycles  = first_out_cycle + 1;
    int drain_cycles = total_cycles - (last_out_cycle + 1);
    int steady       = total_cycles - fill_cycles - drain_cycles;

    printf("=== PIPE_DELAY=%d ===\n", PIPE_DELAY);
    printf("N=%d, Checked=%d, Errors=%d\n", N, valid_checked, errors);
    printf("latency        : %d\n", PIPE_DELAY);
    printf("fill_cycles    : %d\n", fill_cycles);
    printf("steady_cycles  : %d\n", steady);
    printf("drain_cycles   : %d\n", drain_cycles);
    printf("total_cycles   : %d\n", total_cycles);
    printf("throughput     : %.3f result/cycle\n",
           (double)out_count / total_cycles);

    top->final();
    delete top;
    return errors ? 1 : 0;
}
-
• PIPE_DELAY由构建系统传入:不写死,换配置不用改 TB; -
• 随机正常浮点数:避免溢出和下溢,专注验证乘法通路; -
• 与软件 float逐拍对比:任何一拍出错都会被捕获; -
• 跑到最后一个输出就停:总拍数等于实际运行拍数; -
• 统计 fill、steady、drain:完整反映流水线的填充和排空; -
• 四种配置共用同一套 TB:只改 PIPE_DELAY,TB 代码完全不变。
7.2 四种配置的真实输出
   === PIPE_DELAY=0(1 级)===
N=200, Checked=200, Errors=0
latency        : 0
fill_cycles    : 1
steady_cycles  : 199
drain_cycles   : 0
total_cycles   : 200
throughput     : 1.000 result/cycle

=== PIPE_DELAY=1(2 级)===
N=200, Checked=200, Errors=0
latency        : 1
fill_cycles    : 2
steady_cycles  : 199
drain_cycles   : 0
total_cycles   : 201
throughput     : 0.995 result/cycle

=== PIPE_DELAY=2(3 级)===
N=200, Checked=200, Errors=0
latency        : 2
fill_cycles    : 3
steady_cycles  : 199
drain_cycles   : 0
total_cycles   : 202
throughput     : 0.990 result/cycle
7.3 数据说明什么
公式精确吻合:
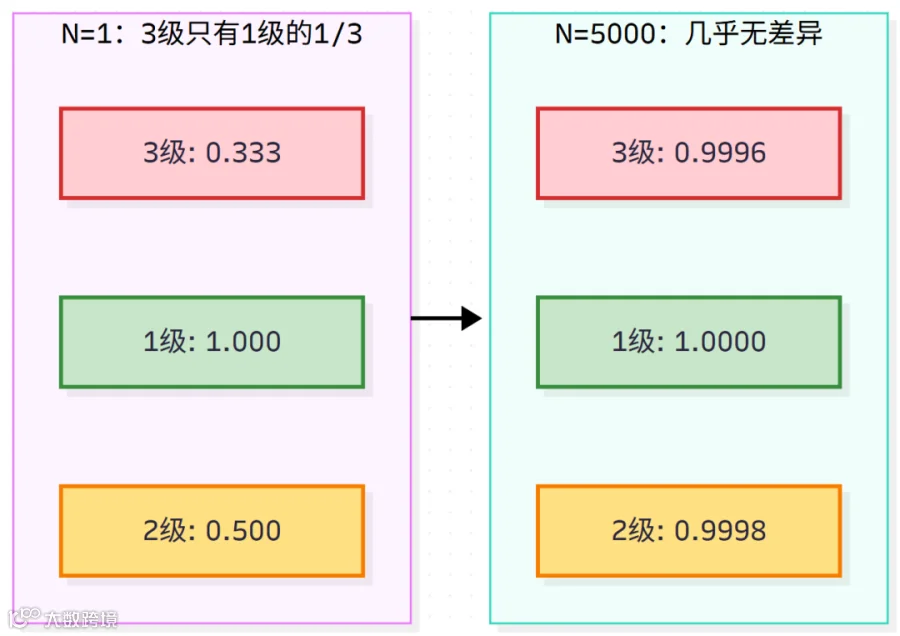
7.4 吞吐随 N 的摊薄曲线
-
• N小时级数差异显著:填充开销占比大,3 级吞吐只有 1 级的 1/3; -
• N大时趋近 1:填充被摊薄,3 级吞吐也接近 1.000; -
• 级数越多吞吐越低:每周期整体吞吐递减,因为填充开销被摊到总拍数里; -
• 频率才是级数的真正收益:但仿真器不模拟门延迟,无法直接给出频率数据; -
• 流式场景: N远大于latency时,所有配置吞吐都趋近 1,级数差异可忽略。
💡 八、代码复用的本质
8.1 把"变"和"不变"分离
复用的本质:把不随配置变化的部分固定下来,把变化的部分参数化。 这样只需要维护一份计算逻辑,所有配置都从这一份派生。
8.2 三个层次的复用
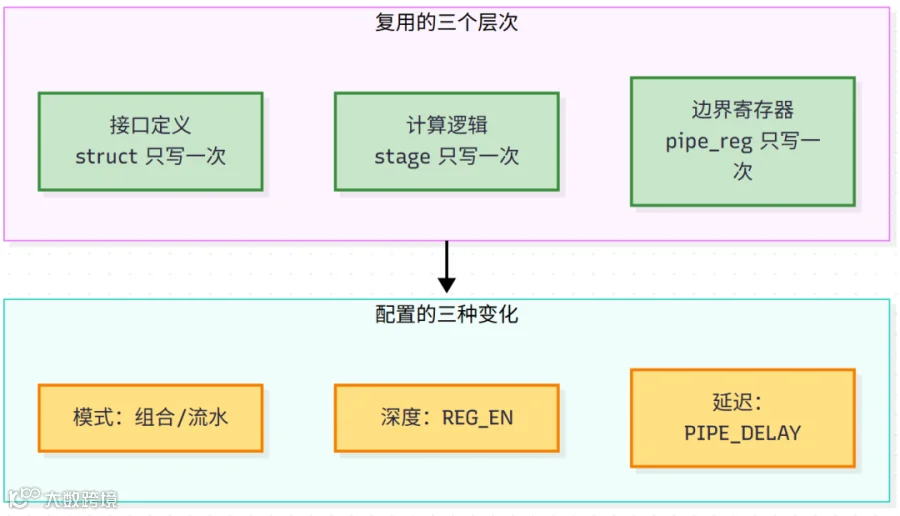
-
• 不变的三个东西:计算、寄存器、接口; -
• 变化的三个东西:深度、延迟、模式; -
• 复用 = 固定不变的,参数化变化的; -
• stage不受模式影响:组合和流水线共用同一份,不需要维护两套; -
• 边界是唯一变化点: always_ff或assign,只有这一行随模式变。
8.3 三个前提条件
🎯 九、总结
🎯 组合和流水线的唯一区别,是边界
B1用assign还是always_ff。但一个区别引出六个连锁差异:时钟、复位、valid、latch、关键路径、组合环。
组合模式不需要时钟和复位,但必须重点防范
latch、长路径和组合环,因为没有寄存器兜底。两级流水线把S1和S2分开,关键路径取max(S1, S2);组合模式把S1和S2串联,关键路径是S1 + S2,频率只有流水线的 70%。
从结构连接图可以直观看到:流水级数越多,接入时钟信号的时序模块越多,组合路径被寄存器切分得越细,关键路径越短,时序化程度越高。
valid打包进struct是复用的关键。它让边界寄存器只处理一个信号,valid跟着数据走,延迟自动对齐,两种模式都不需要单独处理valid。
stage和接口在两种模式下完全相同,唯一变化的是边界。这就是代码复用的本质:把不随配置变化的部分固定,把变化的部分参数化。三个纯组合stage、一个泛化pipe_reg、一个统一struct、一个REG_EN开关,四样东西组合起来,就实现了组合和流水线之间的自由切换,而计算逻辑只写了一次。
四种配置的仿真结果完全一致,
Errors=0。total = N + latency、fill = latency + 1、throughput = N / (N + latency)精确吻合。小N时级数差异显著,大N时趋近 1,填充开销被摊薄。