

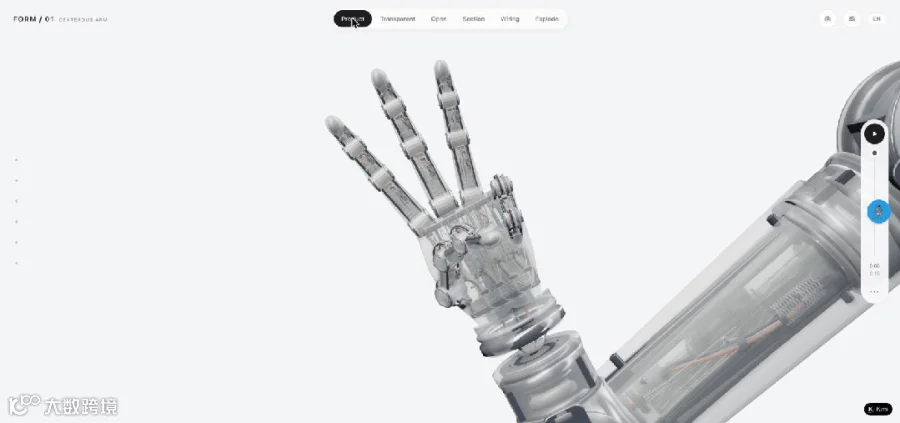
有人用它,把一只机械手拆成了 2317 个零件,做成一个能在网页上自由旋转、点一下还能爆炸拆解开的 3D 站,前后就两个多小时。
这是昨晚半夜刷屏的 Kimi K3.1 Pro 干的活。月之暗面一句“3T 级开源权重模型”甩出来,中文区当场炸了,一派喊超越 OpenAI、还开源,另一派冷笑,不就是蒸馏别人家的嘛。
我两边都不站。这篇我干件没人认真干的事:把官方到底宣称了啥、社区这两天真做出了啥、那些跑分有几分能信、以及你今天花多少钱能用上,一次给你摊开。看完你自己判断,别被任何一方带着跑。
先说一句最容易踩的坑:今天发的是 K3.1 Pro,不是 K3。K3 是今年七月那款。你现在搜到的很多所谓“K3.1 Pro 实测”,比如那个著名的大V画鹈鹕、还有一刀生成 Minecraft 的那条,核对下来都是七月 K3 的旧活,被人翻出来当新的发。认准 K3.1 Pro 这个名,别被旧闻忽悠。
一、它到底是个啥,大白话讲一遍
规格翻译成人话,三句说完。
参数两万八千亿,但每次干活只调动其中一千多亿。这叫 MoE,混合专家。你把它想成一个两千多人的公司,每来一个活,只派最对口的那一百多号人上,剩下的人歇着。又聪明又不至于太烧钱,这是现在大模型都在走的路子,Kimi 这版把规模堆得特别大。
上下文一百万 token,好几本书一次塞进去它都记得住。你把一整个项目的代码、一摞合同、一季度的流水全扔进去,它不会看了后面忘前面。
最关键的是定位变了。以前大模型卷谁更会聊天、谁情商高,K3.1 Pro 卷的是另一件事:谁能把一摊活从头干到尾,中间不用你一直盯着。官方把这个叫 Agent 能力,主推三个场景:在 Unreal、Unity、Godot 这些游戏引擎里做完整游戏,在 Blender、CAD 里写脚本做 3D 建模,还有做金融表格的分析。它要抢的不是你刷手机聊天的那点时间,是你坐在电脑前干活的那几个小时。
这个方向我是真认可。会聊天、会写文案的模型已经够多了,卷到头了。能实打实替你把一件复杂的活干完的,才是普通人真正缺的那块。尤其对我们这种一个人当一个团队使的,谁能帮我省下外包的钱和来回沟通的时间,谁就值钱。
二、社区这两天真做出了啥,带人带链接
先上实在的。发布这一天,中文区已经有人拿它干出活了,下面这些都是真人发出来的实测,不是我替你测的,我把人、把效果、把能找到的链接都给你,你想看就直接去搜他们的号,自己判断。
最出彩的是 3D 这一块,几乎是这波的门面。
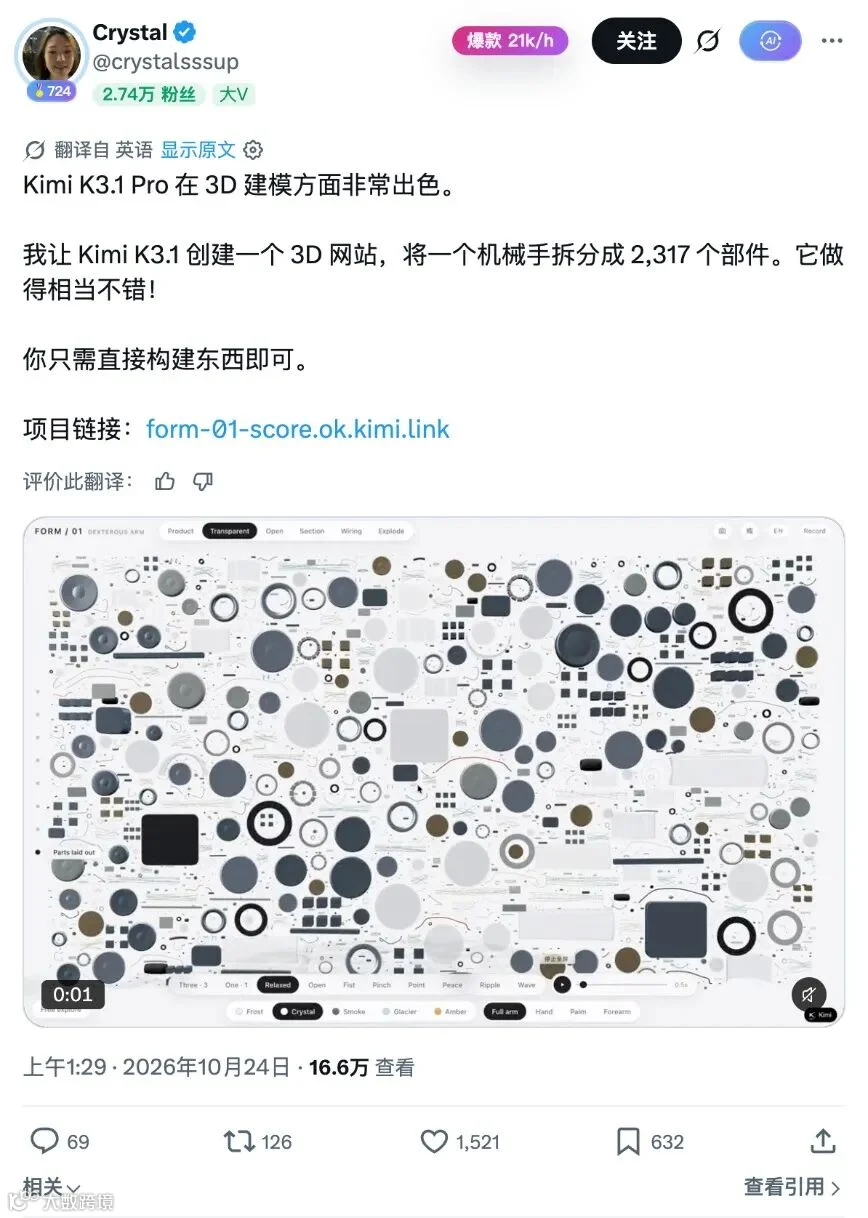
开头那个机械手,是 @crystalsssup 做的。作者让 K3.1 Pro 把一只机械手拆成 2317 个独立部件,做成了一个能在浏览器里跑的交互 3D 网站:能透视看内部结构、能看到每根布线怎么走、点一下还能像爆炸图一样一键拆解开。前后约两个多小时,用了多个代理一起并行跑。这条帖子十五万浏览、将近六百收藏,是这波传得最广、也最硬的一个案例。放在以前,这种活得请专业的三维建模师,按天收费,现在变成一句话指挥模型,这个落差是实打实的。
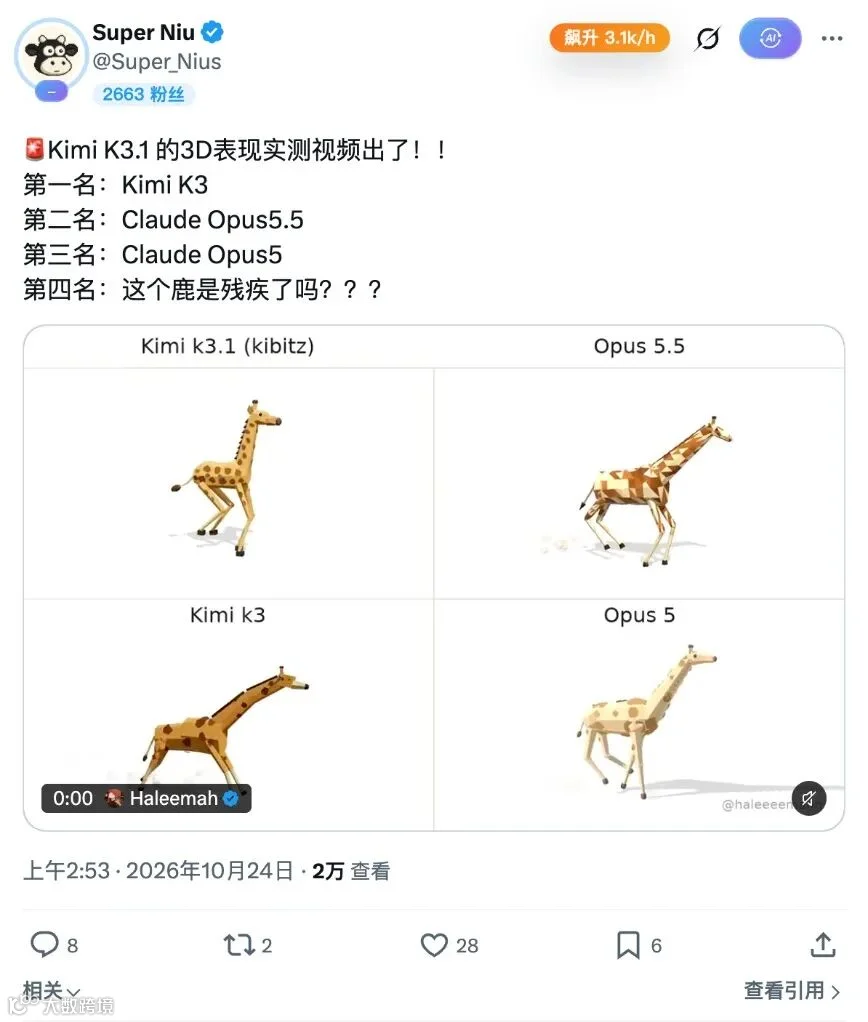
3D 横评也有人做。英文区博主 Haleemah 让 K3.1 Pro、Opus 5.5、七月的老版 K3、还有 Opus 5 同时建一只 3D 长颈鹿,四个一起放出来看,@Super_Nius 把它转到中文区排了名:Kimi 这新版第一,老版 K3 那只垫底,他的吐槽是“这个鹿是残疾了吗”。@bourneliu66 发的是 3D 相机建模的对比,评价是仅次于 Opus 5.5,把 GPT-6 Astra 甩开一大截,尤其金属外壳和玻璃镜片的质感最准,反光和透光都对。@ai_funss 发了一个它渲的可口可乐易拉罐,拉环、罐身的金属光泽、还有标签的曲面,都挺像那么回事。
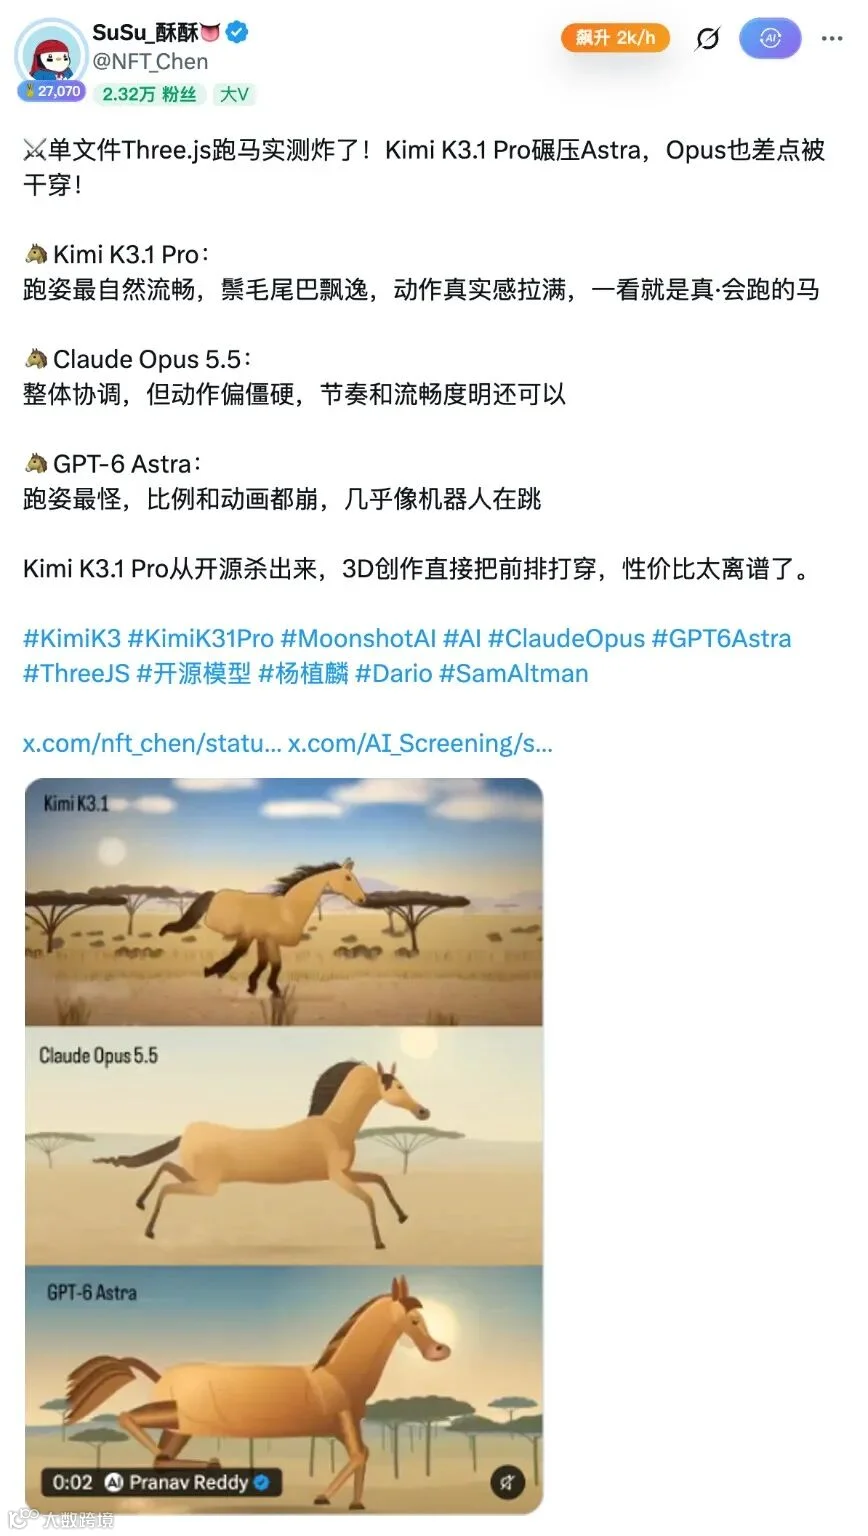
前端和动画这块也热闹。@NFT_Chen 转了一条 Pranav Reddy 做的单文件 Three.js 跑马对比,他的评价是 Kimi 跑姿最自然、四条腿的节奏对、鬃毛和尾巴会跟着飘,整体压过了 GPT-6 Astra,Opus 动作偏僵。@AndyL5cc 也发了 Three.js 奔跑骏马和骑自行车的机械鹈鹕,说效果跟 Gemini 4 Argon 差不多在一个水平,唯一的遗憾是想加个氮气加速的特效没做出来。@_ninetyhe 发了个布料物理的网页,去拉扯晾衣绳上挂着的那块布,布会跟着真实地形变、起褶、回弹,他的原话很直接:要真能做到这样,还订阅啥 GPT 和 Claude。
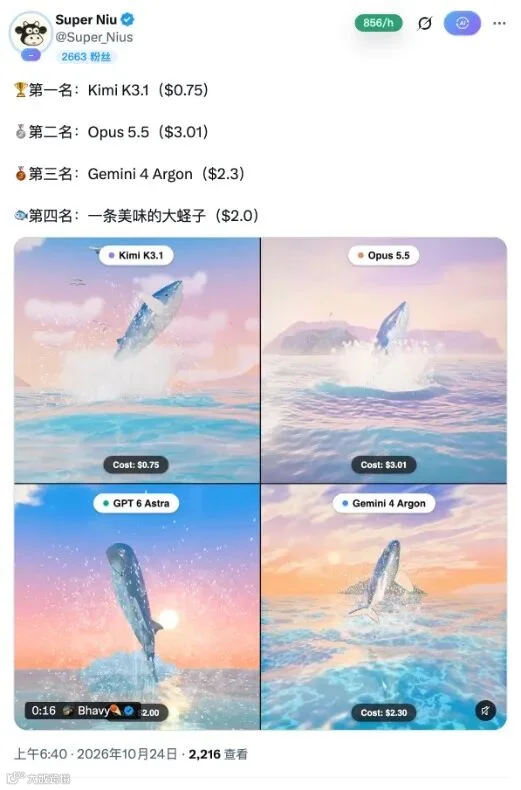
还有一个算钱的对比挺有意思。英文区的 Bhavy 让四个模型用同一句话生成一段鲸鱼跃出海面的动画,@Super_Nius 转过来按效果排了名:第一名 Kimi K3.1,花了 0.75 美元;第二名 Opus 5.5,3.01 美元;第三名 Gemini 4 Argon,2.3 美元;GPT-6 Astra 垫底,被他吐槽成“一条美味的大蛏子”。效果最好,成本还只有 Opus 的四分之一,这条比任何跑分都直观。
但翻车的也有,我一并给你,不然就成了吹。还是 @AndyL5cc,他转了一组 Kai 做的对比,拿 K3.1 Pro Max 跟 GPT-6.1 Sol 做同一道鹈鹕骑车题,结果鹈鹕的脚和踏板怎么都对不上,他原话是“这看得我一脸懵逼”,还反问这用的真是 K3.1 Pro Max 吗。他另一条发的是 K3.1 Pro 跟 DeepSeek V4.1 Flash 比前端动画,本以为新旗舰会稳压一头,结果 DeepSeek 照样能打,他给的结论是各有千秋。所以别看了几张神图就以为它场场赢,同一个模型换道题、换个对手,结果就可能不一样。

顺带说个我扒原帖时发现的事。中文区这两天传得最凶的几条对比视频,你点开看角落里的署名,大多出自英文区博主之手,中文博主转过来,配上自己的排名和点评。这不是坏事,好东西本来就该传,但你转发的时候心里得有数:这些“碾压”“垫底”的评价,很多是二手的,原作者自己未必这么下结论。
我做电商代运营的,看到这些第一反应就是算账。商品的 3D 展示、详情页里那些转一转、点一点就有反馈的动效,以前要么找外包做、要么买现成模板,现在是不是能自己一句话让它生一个。这个方向,做电商、做设计、做独立站的朋友,真值得今天就上手试一把,哪怕先拿一个商品练手。
但有一块我得专门泼盆冷水,就是游戏。官方把游戏吹得最响,说能做跑酷、能做赛车、能做完整的可玩 demo。我在中文区翻了这两天,没找到一个真把完整游戏做出来、能上手玩的实测,刷到的基本都是在转述官方那几句宣传语,配上官方给的演示图。所以游戏这块,现在只有官方的一面之词,先当它没发生,等有人真做出来能玩的再说,别信一句口号就冲进去。
三、官方宣称的成绩,我逐条标清楚哪是自己说的
看完作品再看跑分。这节丑话说前头:下面绝大部分数字,是月之暗面自己测、自己发的,有好几项还是它自家出的内部考卷。 自己出题、自己答、自己打分,参考可以,别当判决书使。
我帮你把每条跑分到底在测啥也说清楚,不然光看数字没意义。
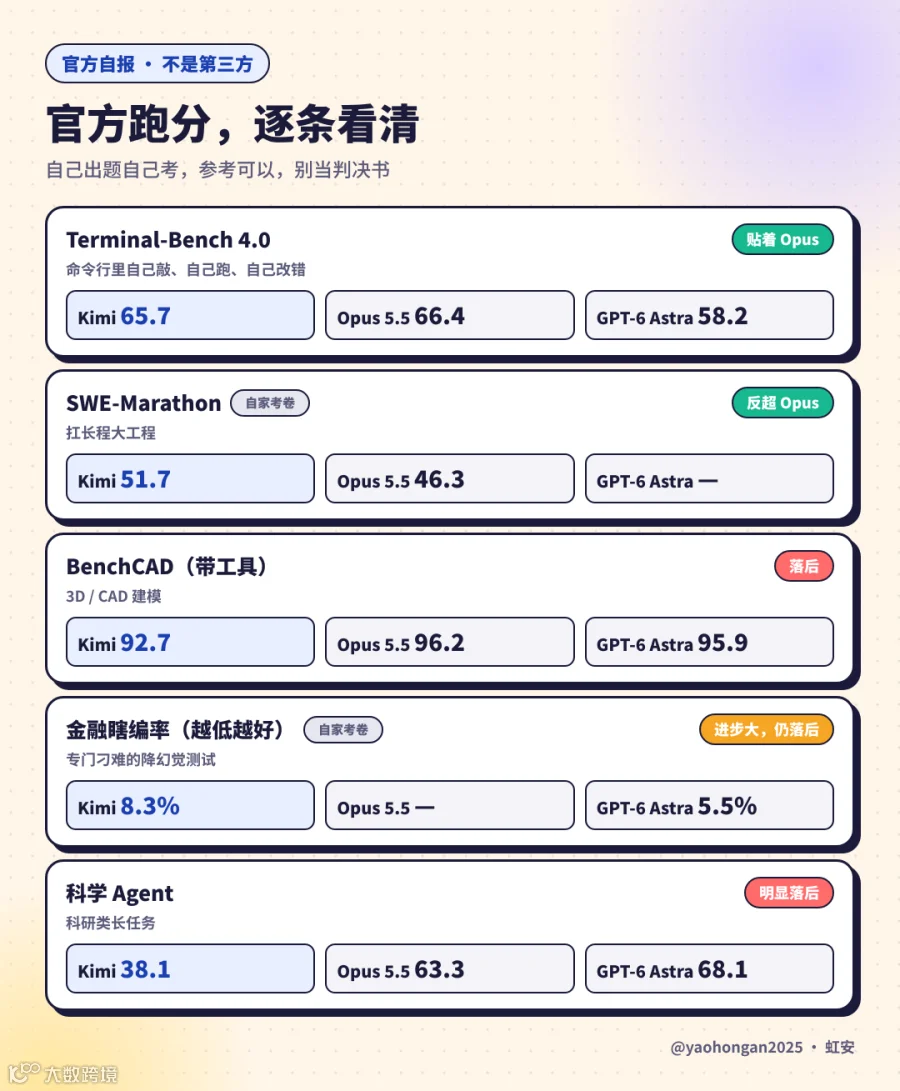
编程这块,官方自报的是代理编程测试 Terminal-Bench 4.0 拿了 65.7。这个测试测的是模型能不能像个程序员一样,在命令行里自己敲命令、自己跑、自己改错,不是光写几行代码。对比看,Claude Opus 5.5 是 66.4,GPT-6 Astra 是 58.2,Kimi 这个分数确实挤进了第一梯队,贴着 Opus。它自家还有个长程编程测试 SWE-Marathon,测的是能不能扛住一个要改几十处、持续很久的大工程,K3.1 Pro 报 51.7,反超了 Opus 的 46.3,不过这是它自己的考卷,看看就好。
3D 和 CAD,官方自报带工具的 BenchCAD 拿 92.7。但注意,这一项它反而是落后的:Opus 5.5 是 96.2,GPT-6 Astra 是 95.9,都比它高。有意思的是,社区实际做 3D 的反馈又普遍说 Kimi 好,这说明跑分和真实手感不一定对得上,这也是我一直强调别只看分的原因。
金融降幻觉,官方自报在它自家那个专门刁难模型的测试里,瞎编率从上一代的 23.4% 降到了 8.3%。降幅听着很猛,但同一个测试里 GPT-6 Astra 只有 5.5%,比它还低,Kimi 在这块还是落后的。所以别一看到“幻觉大降”就以为天下第一,它是进步大,不是最好。
最该夸的,是它主动报短。官方自己承认,科学 Agent 那个测试只拿了 38.1,被 GPT-6 Astra 的 68.1、Opus 的 63.3 甩开一大截,差了快一倍。它还主动说,为了开源安全,特意把训练数据里跟网络攻击相关的那部分删掉了,结果导致那块的能力从没删版的 90.5 掉到了 81。一个厂商,在自己的发布材料里肯把短板明明白白摆出来、还解释为什么,这点我是真心服。会吹的多,肯自己说哪里不行的少。
一句话总结这节:它确实冲进了第一梯队,这是真的;但“全面超越 OpenAI”是喊出来的口号,“编程干活贴着最强、3D 和科学任务还落后、降幻觉还追不上 GPT-6”,才是官方自己那堆数据画出来的真样子。下一节你会看到,第三方复测的结果,跟这个画像基本对得上。
四、真正的第三方成绩出来了,跟你想的不太一样
这节最有料,也是我写这篇时差点翻车的地方,一并交代给你。
一开始我刷到一篇英文报道,说 K3.1 Pro 在第三方机构 Artificial Analysis 的网络安全榜上拿了 64%、公开模型第一。我第一反应是去 AA 官网查,榜上当时压根没有 K3.1 Pro,我差点就把它当成假数据写进来。结果几个小时后,AA 官方账号自己发了完整测评,64% 是真的,只是官网榜单还没来得及更新。所以新模型刚发布那几天,“查不到”不等于“是假的”,最靠谱的是去看测评机构自己账号发的原帖。
AA 这次是自己掏钱调 API 一项一项跑的,不是转述官方,我把关键几条给你。
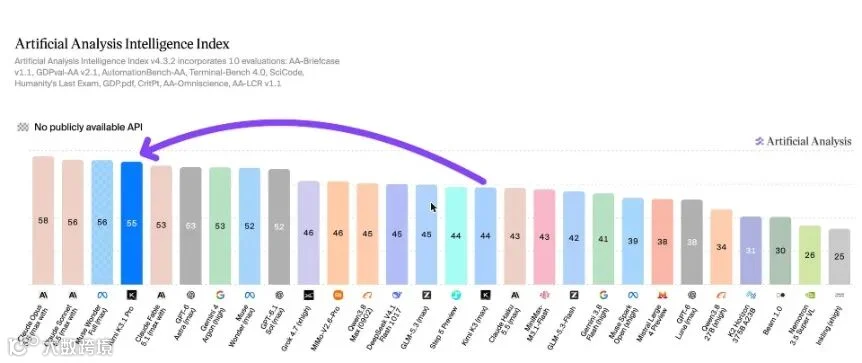
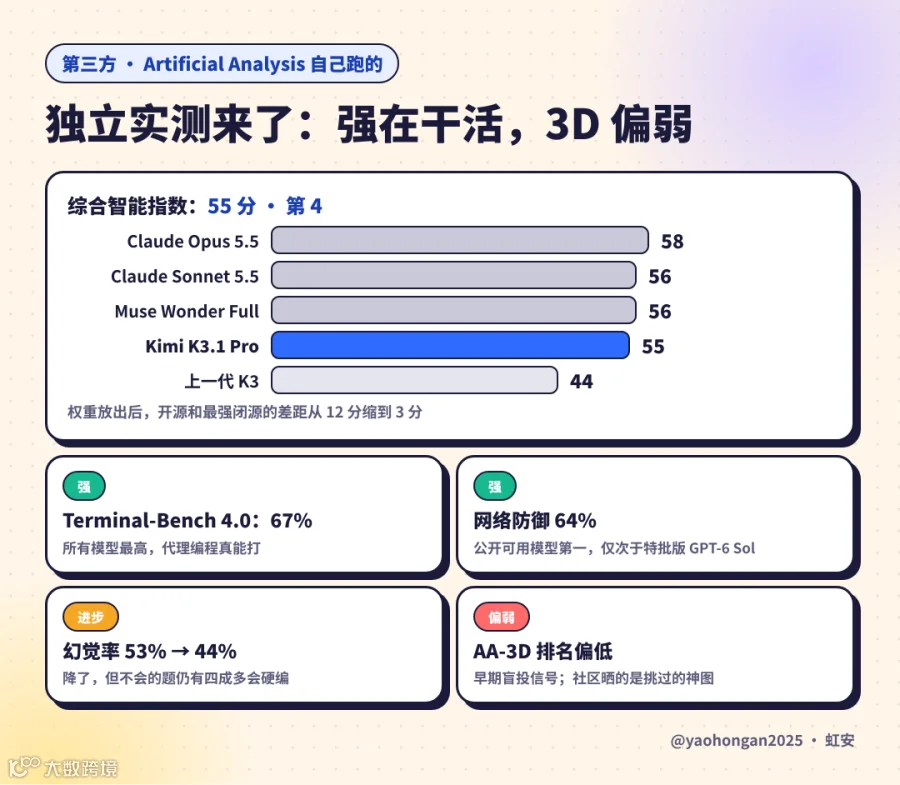
综合智能指数 55 分,排第 4。前面只有 Claude Opus 5.5 的 58 分,Claude Sonnet 5.5 和 Muse Wonder Full 的 56 分,比上一代 K3 的 44 分涨了 11 分。AA 的原话是,等它权重放出来,开源模型和最强闭源模型的差距,会从 12 分一下缩到 3 分。
干活能力是真强。代理编程测试 Terminal-Bench 4.0,AA 自己复测是 67%,所有模型里最高,比 Kimi 官方自报的 65.7 还高一点。衡量真实办公任务的 GDPval-AA 排第 3,只在 Opus 5.5 和 Muse Wonder Full 后面。
网络防御拿了 64%,能公开用的模型里排第一,只输给一个要 OpenAI 特批才能用的 GPT-6 Sol 版本,那个是 69%。而且整个测试它一次安全拒答都没触发。
幻觉降了,但没降到能闭眼信。AA 那个专门惩罚瞎答的测试里,它的幻觉率从 53% 降到 44%。降了九个点是真进步,但反过来说,碰到它不会的题,还是有四成多会硬编一个答案给你,这个心里得有数。
最反直觉的是 3D。社区里刷屏的全是 3D 神作,但 AA 说,从目前收集到的盲投来看,K3.1 Pro 在它的 AA-3D 榜上排名会偏低,上一代 K3 在这个榜上是 22 个模型里第 12。这跟官方自己报的 BenchCAD 落后也对得上。怎么理解?社区晒出来的,是作者挑过的最好那几张;盲测是同一道题一对一公平比,谁好看投谁。所以 3D 这块,它能出神作,但不代表它稳定地比别家强。

还有一个开发者常看的 Code Arena WebDev 榜,专门测做网页前端的能力,K3.1 Pro 排到了第八,能当个参考,说明它前端是真有两把刷子,和社区那些 Three.js 作品对得上。
我费这么多话说跑分,核心就一个意思:一个新模型刚发布的头几天,是信息最乱的时候,官方自报的、媒体转述的、测评机构自己测的、再加上榜单没更新造成的误会,全搅在一起分不清。你这两天刷到任何“第几名、碾压谁、登顶”的截图,先别急着转,也别急着骂假,先问一句:这个数到底是谁测的,原帖在哪,能不能点进去看到原文。拿不准的,宁可多等半天。
五、最实在的:今天花多少钱,到底能不能用上
吹得再响,落到你我身上就一个问题:今天能不能用、花多少钱。这块我去官网一项一项摸了一遍,把能核实的给你说清楚,有出入的地方我也直说。
先说免费号。发布当天基本用不顺。你在模型列表里是能选到 K3.1 Pro 的,没给你锁死,但一发消息就容易弹出来一个提示,大意是“当前使用人数过多,订阅会员可进优先队列”,高峰期就一直给你排队、转圈。所以严格讲不是“免费完全用不了”,是“免费能选,但赶上这两天的高峰你大概率排不上”。等过阵子热度下去、人少了,免费号能不能顺畅用,还得再看。
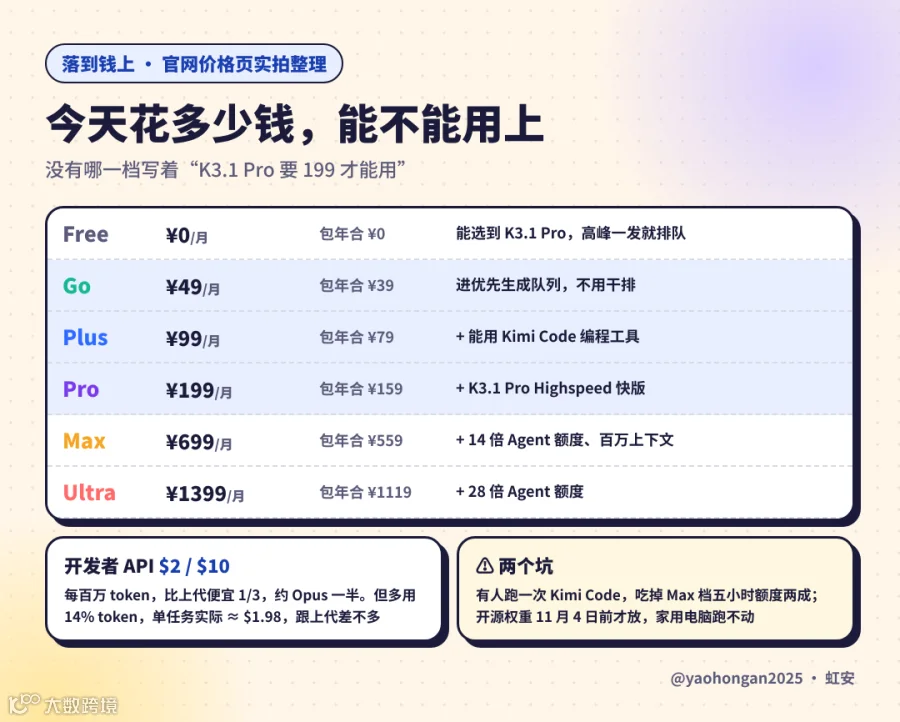
想现在就顺畅用上,得开会员。我去官网价格页看了,会员一共五档:Go、Plus、Pro、Max、Ultra,包月分别是 49、99、199、699、1399,包年折下来一个月 39、79、159、559、1119。怎么选看三条线就够了:最低的 Go 就能进优先生成队列,不用干排队;想用它的编程工具 Kimi Code,至少得 Plus;想用那个速度快两三倍的 Highspeed 高速版,至少得 Pro。

这里我得诚实说一句:网上有人说“至少得开 199 那档才用得上 K3.1 Pro”,我对着官网价格页一条条看,没有哪一档写着 K3.1 Pro 要 199 才解锁,免费号也能在列表里选到它,只是高峰排队、慢;199 买的是 Highspeed 快版、4 倍 Agent 额度和多任务并行,不是买“能不能用”的入场券。各档具体怎么限速、限量,网页端和 App 端可能还有出入,这个我不替你拍死,你开之前自己在界面上再确认一眼当天的说明,以你看到的为准。
再插一条很有用的真实成本吐槽。有人用它的编程工具 Kimi Code 跑了一次测试任务,就那么一次,直接吃掉了 699 那档(也就是 Max 档)套餐五小时额度的两成。换句话说,这种套餐你一天也就经得起五六次这种规模的任务。所以别光看它 API 单价便宜就以为能随便造,真拿它当编程代理猛干一天活,额度烧得飞快,心里得有这个数,不然月底一看账单该肉疼了。
开源这两个字也得泼点冷水,别被“开源免费”四个字晃了眼。它说的是开源权重,但权重要等到 11 月 4 日前才正式放出来,今天还没开,你现在下载不到。就算放了,两万八千亿参数的模型,你自己家那台电脑、甚至一般小公司的服务器都根本跑不动,那是给大公司和云厂商用的。开源对你我这种普通用户真正的好处,不是“我能自己跑一个”,而是往后各种第三方平台会把它接进去、相互压价,用的成本会被打下来,但这个得等生态起来,不是今天就能吃到的。
开发者这边反而是最实在、今天就能吃到红利的。它的 API 价格是每百万 token 输入两美元、输出十美元,比上一代 K3 的三美元、十五美元便宜了三分之一,差不多是 Opus 5.5 价格的一半。有人拿同一道 3D 建模的题做了对比:用 Kimi 花了 5.71 美元、十五分钟跑完,用 Opus 花了 17.13 美元、三十二分钟。快了差不多一倍,钱只花了三分之一。对靠 API 写代码、搭应用的人来说,这笔账太好算了,今天就能切过去试,这是目前性价比最清楚的一种用法。
不过 AA 算了一笔更细的账,我也补上:它单价是降了三分之一,但干同样的活要多写 14% 的字,所以按 AA 的测试任务算,每个任务实际花 1.98 美元,跟上一代 K3 的 2 美元几乎一样。也就是说,它省钱主要是比 Opus 省,不是比自家上一代省,这点别被“降价三分之一”带偏了。
六、想上手的话,我给你几条少踩坑的实在建议
光知道它行不行还不够,真要用,下面几条能帮你少走弯路、少烧冤枉钱。
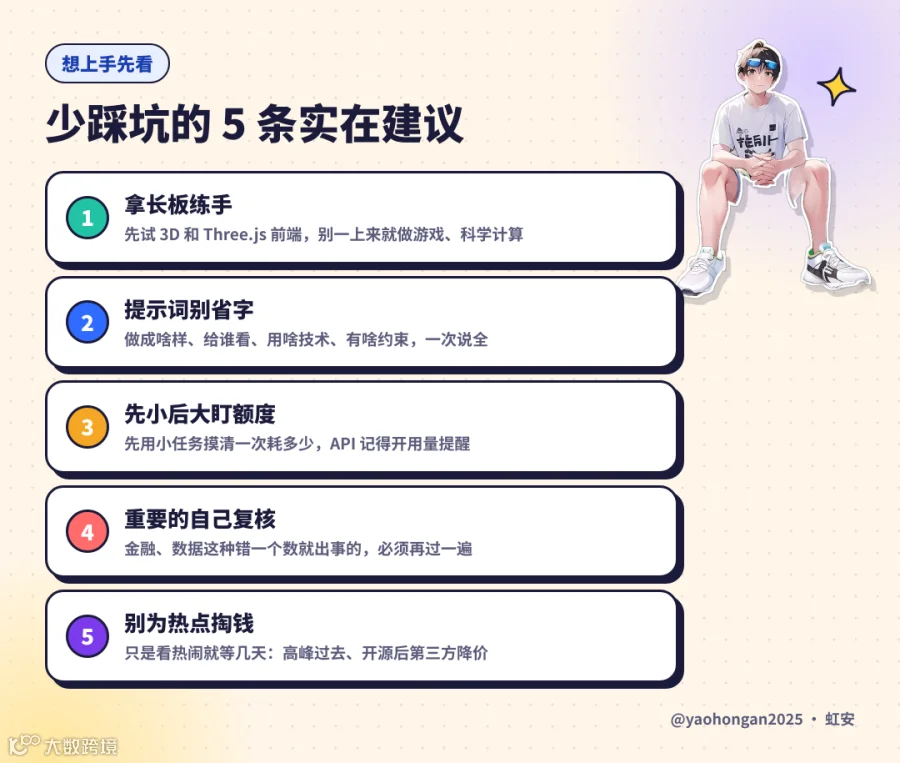
第一,拿它的长板练手,别拿短板。它现在社区口碑最好的是 3D 和前端,你第一次试就奔这两个去:让它用 Three.js 做个会动的小东西,或者捏个 3D 模型放网页上。成就感来得快,也最能看出它跟你以前用的模型差在哪。别一上来就让它做游戏或者搞科学计算,那是它自己都承认的弱项,容易失望。
第二,提示词别省字。它主打的是能自己把活干完,那你就得把活交代清楚:要做成啥样、给谁看、用什么技术、有哪些约束,一次说全。你给的越具体,它一条龙干下来的结果越接近你要的;你给一句含糊的,它只能猜,来回返工反而更烧额度。
第三,盯紧额度,先小后大。前面说了,一次像样的代理任务能吃掉套餐额度的两成。所以第一天别拿它干你最重要那个大工程,先用小任务摸清楚它干一件活大概耗多少,心里有谱了再往上加码。API 用户尤其要在后台把用量提醒设上。
第四,重要的东西一定自己复核。它降幻觉是进步了,但还没到能闭眼信的地步,金融、数据这类错一个数就出事的活,务必自己再过一遍。把它当一个很能干但偶尔会想当然的助手,别当成不会错的权威。
第五,别急着为热点掏钱。如果你只是想看看热闹、试试水,完全可以等几天。高峰过去免费号能排上,11 月开源后第三方平台大概率会出更便宜的接入方式,那时候再用,又省钱体验又好。
七、那个绕不开的“蒸馏”争议,我中立说两句
每次国产模型一冒头、一变强,这顶“蒸馏别人家的”帽子就准时飞过来。这次也没跑掉。我不替任何一方站台,把两边的话都给你摆出来,你自己掂量。
挺它的人说得挺硬气:之前全网群嘲 Kimi 是蒸馏的、是套壳的,现在它好几个实例的表现都超过了 GPT-6 Astra,第三方的智能指数也排到第四了,那现在还有人喷吗?能蒸馏出这个水平,本身也是本事。
质疑的人也有依据:OpenAI 此前确实公开提到过相关的指控。但我必须把话说清楚,指控不等于坐实,到今天为止,这件事没有任何官方定论,也没有拿得出手的实锤。你拿一个悬而未决的指控,当成已经定罪的事实去骂街,这不客观,也不公平。
还有一个我觉得更值得想的质疑,比站队有意思。有人问:拿“能不能捏一个 3D 模型、做一只会跑的长颈鹿”来判断一个大模型行不行,这件事本身合理吗?模型又没真的见过长颈鹿怎么跑步,它做出来好看,更多是见过海量类似的图和代码。这话我觉得在理。这些演示确实好看、直观、特别适合在推特上传播,但它测的是“做某个特定东西”的能力,不等于这个模型方方面面都强。你看演示图一乐、收藏起来当灵感可以,别真把一张长颈鹿截图当成你选模型的唯一依据。
我的态度就一句话:它这次拿出来的真实力,配得上大家认真看一眼、认真试一把,但也完全没必要把它捧成神。是骡子是马,再等几天,等真正独立的横向实测陆续出来,自然就见分晓了,急不得。
八、所以,你到底该不该凑这个热闹
分人,别一股脑跟风。我按几种人给你掰开说。

做开发、写代码、搭 Agent 的,值得今天就试。第三方实测里它最强的就是这块,API 价格又是 Opus 的一半,这笔账好算。做 3D 的也可以试,但按 AA 的盲测,别指望它每次都稳赢。先别一上来就拿它干大工程,用它的 API 或者 Kimi Code 挑一个你平时真会遇到的小活练手,亲自感受一下手感和烧额度的速度,再决定要不要大规模切。
做内容、做自媒体的,这波本身就是顶好的素材。它会捏 3D、会做酷炫动效,你拿它随便做一个出来,录个屏、配两句讲解,就是一条能蹭上当下热度的内容。热点就这几天,手要快。
做金融、做数据分析的,可以关注它降幻觉这个进步,但务必拿你自己的真实数据、小范围地试,别直接上生产。记住它这块还落后 GPT-6,官方自己都承认了,别把活全交给它然后不检查。
普通用户,平时就是聊聊天、写写东西、查查资料的,我劝你先别冲动开会员。真没必要为了凑这两天的热闹掏钱。等高峰过去、免费号能排上队了,或者等 11 月开源之后第三方平台降了价,你再用,一点都不迟,体验还更好。
说到底,Kimi 这次是真争气。开源模型第一次离最强的闭源这么近,价格还砍了一大截,这对我们所有用 AI 的人都是好事,因为它实打实地逼着那几家闭源的往下降价,我们是受益的一方。但“人人今天都能免费用上一个开源版的 Opus”,这是一句漂亮的口号,不是今天的事实。东西是真好,门也才刚推开一条缝,别被口号推着跑,也别被冷笑拦着不敢看。
最后问问你:你今天挤进 K3.1 Pro 了吗,拿它干了点啥,成了没?评论区聊聊,我挺好奇真实的上手体验到底跟这些演示差多少。