做研究的人都有个体感:现在写东西越来越快,但"想清楚东西对不对"的速度没变。
谷歌管这叫"验证瓶颈"(validation bottleneck):AI 让内容生产暴涨,人类的验证能力原地踏步。10 月 14 日,他们把内部打磨了一年的审稿系统 Deep Review 公开发布了,每人每周送两次免费审稿。
而这个系统不是实验室原型,是在四个顶级会议上真刀真枪预审过 16,000 多篇论文的老兵。我把它的一年成绩单和技术细节都挖了一遍,讲给你听。
一、先看它要解决多大的窟窿
数字最诚实。2023 年,ICLR、NeurIPS、ICML 三个顶会加起来约 24,000 篇投稿;2026 年,这个数字变成了 75,000 以上,四年翻了三倍多。而每篇稿子都需要多个高质量评审。投稿指数级涨,合格的审稿人是线性培养的,窟窿只会越来越大。
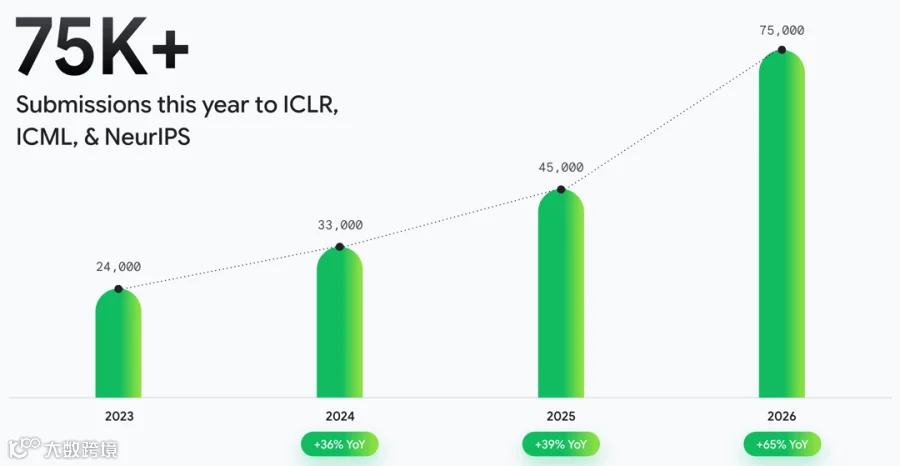
▲ 三大 AI 顶会投稿量:2023 年 24,000 → 2026 年 75,000+(图源:Google 原文,下同)
二、一年的试点成绩单,比想象中硬
Deep Review 的前身是内部实验项目 PAT(Paper Assistant Tool)。过去一年多,谷歌和 STOC 2026、ICML 2026、NeurIPS 2026、ICLR 2027 四个旗舰会议合作:作者在截稿前几周可以自愿把稿子丢给 PAT,拿到详细的预审反馈。
机制设计上有个关键点:这套反馈和官方评审完全解耦,不收集任何训练数据,试点结束论文立即删除。所以它是纯粹的"投稿前压力测试",不是变相的数据采集。
四站的成绩单:
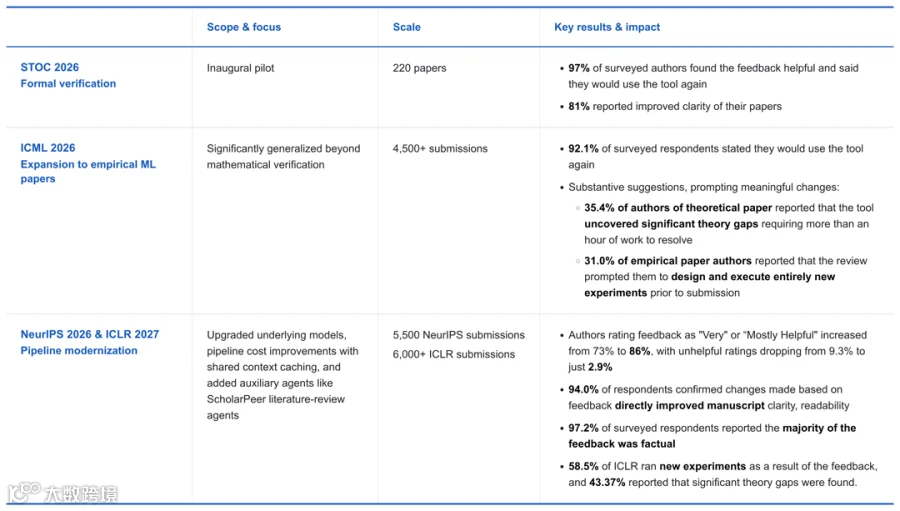
▲ 四站试点汇总:STOC 220 篇 → NeurIPS/ICLR 合计 11,500+ 篇
挑几个最扎眼的:
STOC 首站,97% 的作者反馈"有帮助,还会再用"。ICML 站,92.1% 愿意再用;35.4% 的理论论文作者说,工具挖出了需要一小时以上工作量才能补齐的重大理论缺口;31.0% 的实验论文作者说,反馈促使他们在投稿前设计并执行了全新的实验。NeurIPS 和 ICLR 站,"非常或大体有帮助"的比例从 73% 升到 86%,"无帮助"从 9.3% 降到 2.9%;94% 的受访者确认反馈是事实性的;58.5% 的 ICLR 作者因为反馈跑了新实验,43.37% 被指出重大理论缺口。
注意这些数字的分量:这不是"帮我润色了语言"级别的反馈,是把理论漏洞和新实验需求从稿子里逼出来了。而且他们提到,接入了 Gemini 4 Argon 之后,底层能力还在继续涨。
三、技术上凭什么:四阶段 agent 管线
为什么单次大模型调用审不了长论文?谷歌的解释很直白:token 推理预算会被耗尽、长上下文跨节依赖会被忽略、细致的主张会被不加深究地接受。
Deep Review 的解法是拆开干:

▲ 四阶段管线:分段 → 自适应预算 → 并行深审 → 全局综合与接地核查
第一步,文档分段。一个 segmenter agent 把文档自动拆成逻辑段落(引言、方法、实验),允许重叠,必须全覆盖。
第二步,自适应预算。不是每节都给同样的算力。管线看信息密度动态分配,密集数学证明的节给高算力,引言和 related work 给轻算力。这个"该省省该花花"的设计很反直觉但很关键:均匀用力才是浪费。
第三步,深度并行验证。专门的推理 agent 并行审查每一段。每个 agent 都能访问全文上下文来追踪交叉引用,但火力集中在自己那一段。既保证单个评审 swarm 的任务可消化,又保证并行 swarm 之间协调。
第四步,全局综合与 agentic 接地。一个综合 agent 合并各段报告,做跨节一致性检查,必要时重跑逻辑检查;最后做外部接地核查和工具调用,作为防幻觉的最后一道闸。
四、不止论文:设计文档、PPT、合同都能审
谷歌的判断是,验证论文证明成立的推理机制,同样可以拿去查其他"主张必须有证据支撑"的文档。所以 Deep Review 现在支持三类新场景:
设计文档:抓未言明的架构假设、找边界情况、给具体改进建议。演示文稿:检查幻灯片之间逻辑是否顺、要点和图表是否对得上。法律和金融文档:跨条款和数据表查内部一致性,标出模糊措辞和下游后果,把主张和支撑证据对上。
顺手他们还发了个 Antigravity 里的"Teamwork 深度文档评审模式",多 agent 层级架构带自纠偏和分段评分卡,一条 /teamwork-preview 命令就能调用。
五、怎么用,以及边界在哪
入口有三个:Google Research 门户(每人每周 2 次免费评审)、接 Gemini API key 的 Deep Review API(适合写进 CI 和起草流程的高频用户)、以及预印本论文可读方法论。目前支持 PDF 和纯文本,多文件输入在路上。
隐私政策值得单独说一句:上传的文档永远不会被用来训练、微调或改进谷歌模型,只存储一年用于在用户界面里展示。
六、我的几点想法
第一,这个项目最有说服力的不是技术,是部署伦理设计。自愿参与、与官方评审解耦、不留存数据、事后删除,每一条都是和会议主办方谈出来的信任条款。做学术工具的公司都值得抄这套做法,比事后发道歉声明便宜得多。
第二,94% 的"事实性"反馈率是个值得盯的指标。审稿 agent 最大的风险不是没用,是"看起来很专业地胡说"。他们选择在管线末端加外部接地核查和工具调用,而不是指望模型自觉,这个工程取向是对的。但反过来说,剩下 6% 的幻觉落在谁头上,就是一个责任问题了。
第三,对写论文的人,这个工具的用法可能有微妙变化。官方定位是起草期的迭代改进工具,但在"评审前压力测试"这个用法上,它实际上重构了信息不对称:以前只有大厂实验室和名校 PI 的学生能拿到投稿前的高质量内部预审,现在每人每周两次。审稿网络的特权正在被拉平,这是好事。
第四,拉长时间线看,75,000 篇投稿这个数字本身迟早也会被 AI 改写。当验证能力追上来之后,投稿量的天花板会再次上移。审稿 agent 解决的是当下的窟窿,而它参与创造的是下一个窟窿。这个循环大概不会停。
工具入口在 Google Research 的 Deep Review 门户,论文投出去之前,值得一试。
参考:Google Research Blog, "Analyzing technical documents with Deep Review", 2026-10-14。文中数据与图表来自原文,图片版权归 Google 所有。
1.20K-40K!深圳扬奇医芯招双目结构光算法工程师
2.AI教父Hinton诺奖演讲首登顶刊!拒绝公式,让全场秒懂「玻尔兹曼机」
3.GitHub没了?CEO辞职,微软接管,开发者天塌了
4.AI颠覆数学研究!菲尔兹奖得主、华裔数学家领衔11篇顶刊论文|陶哲轩转赞
5.AI OS,下一个二十年的超级平台
6.全球首个IMO金牌AI诞生!谷歌Gemini碾碎奥数神话,拿下35分震惊裁判