
刚刚,月之暗面正式推出Kimi K3.1 Pro,3万亿参数模型
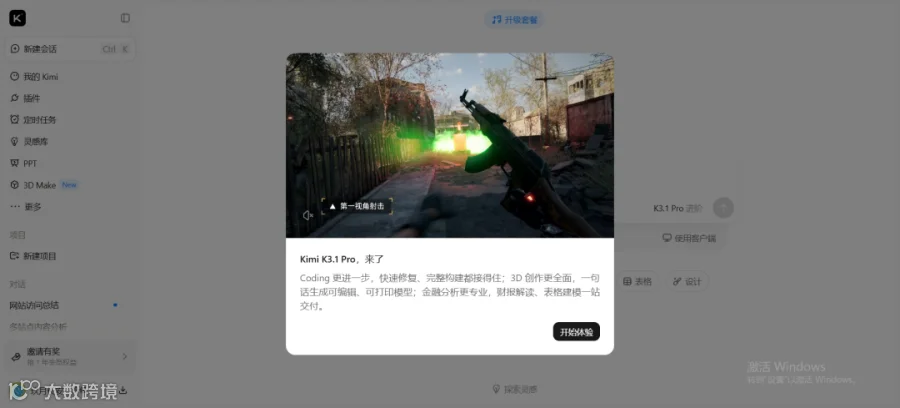
10 月 24 日凌晨,月之暗面 Kimi 正式发布 Kimi K3.1 系列的首个模型 K3.1 Pro,这是迄今能力最强的 3 万亿级参数模型,支持 100 万上下文。

同步推出的还有高速版 Kimi K3.1 Pro Highspeed,官方称其在同等智能水平下,输出速度约为前者的 2 至 3 倍。
一个模型两个版本,同步开源模型权重
Kimi K3.1 Pro 与 K3.1 Pro Highspeed两款旗舰模型。
官方表示,完整模型权重将于 11 月 4 日前发布。
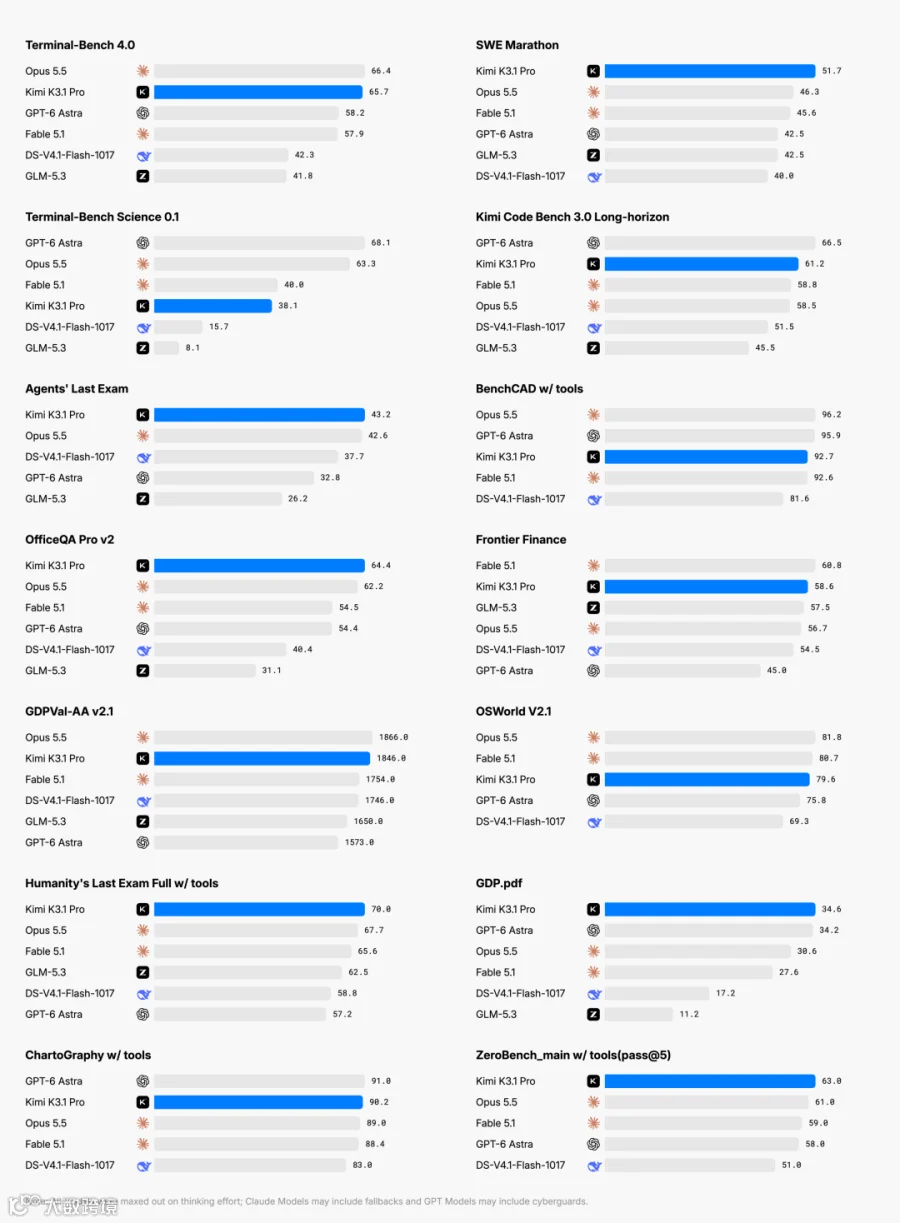
在代码、Agent(智能体)和知识类基准上,K3.1 Pro 达到或接近最强闭源模型的水平。

把此前偏重对话的模型能力,向编程、工具调用与专业工作流延伸。
代码与 3D 是重点,金融场景同步补强
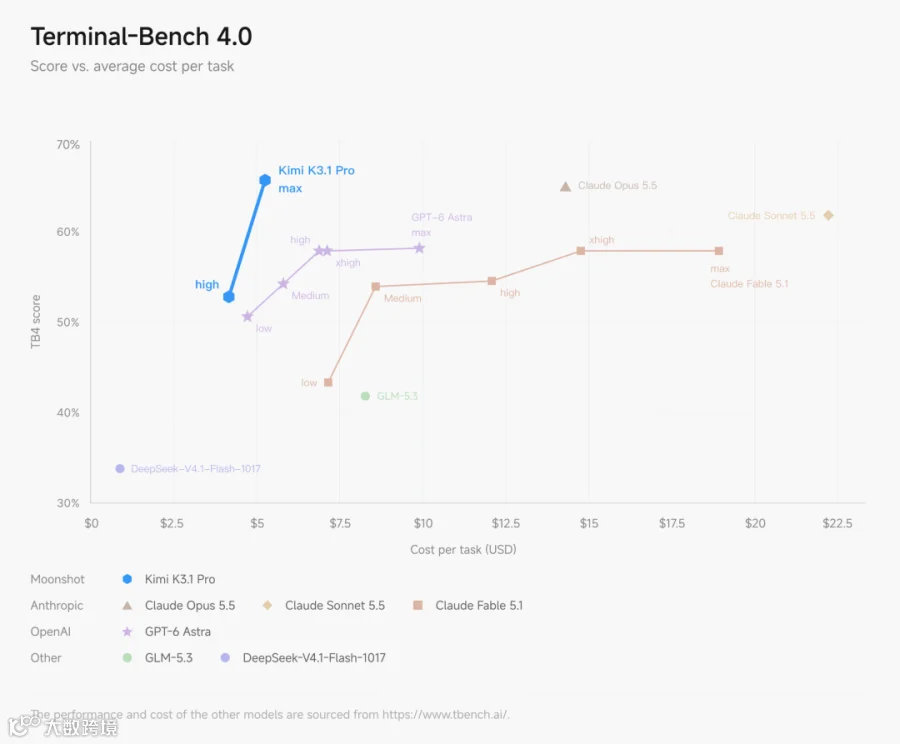
在考察编程智能体的 Terminal-Bench 4.0 中,K3.1 Pro 得分 65.7%,高于 GPT-6 Astra 的 58.2%,与 Claude Opus 5.5 的 66.4% 仅有微弱差距。
内部基准 Kimi Code Bench 3.0 Long-horizon 上,它得分 61.2%,高于 K3 的 55.95%。
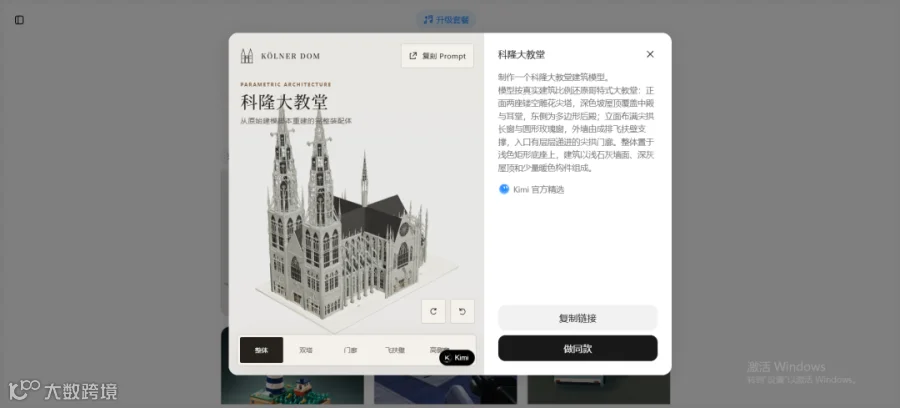
3D 创作是另一处明显变化,官方称 K3.1 Pro 能使用 Unity、Unreal Engine、Godot 等游戏引擎,并结合网络搜索与 3D 生成完成完整体验;给一段文字描述、一张草图或参考图,它可以推断物体的形状、比例和空间关系,重建为可用的 3D 模型。

在考察由 CAD 代码重建 3D 模型的 BenchCAD 基准中,K3.1 Pro 借助工具得分 92.7%,接近 Claude Opus 5.5 的 96.2% 与 GPT-6 Astra 的 95.9%。

Kimi已上线 3D Make 功能,支持在线预览与编辑,成品可用于 3D 打印,也能导出视频或实况照片。
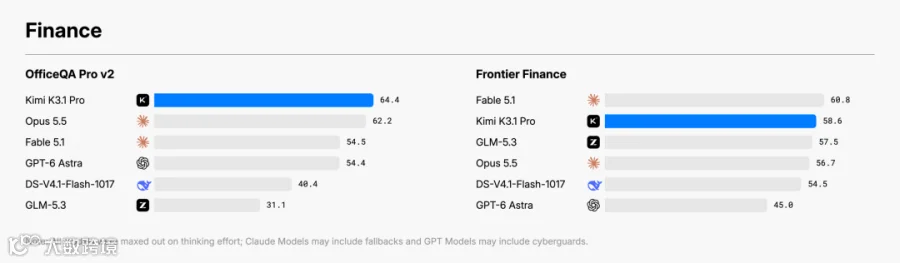
金融方面,K3.1 Pro 在基于真实金融文档的 OfficeQA Pro v2 上得分 64.4,官方称取得当前最优成绩。3 个内部金融基准也全面超过 K3:财务建模基准提升 14%,金融研究基准提升 20%,商业运营基准得分约为 K3 的 4.2 倍。
事实准确性提升与 API 定价
在内部压力测试 Kimi Hallu Bench Hard 中,新模型的单项事实陈述错误率从 K3 的 23.4% 降至 8.3%;包含至少一处事实错误的回答比例,仅为前代的约 42.4%。
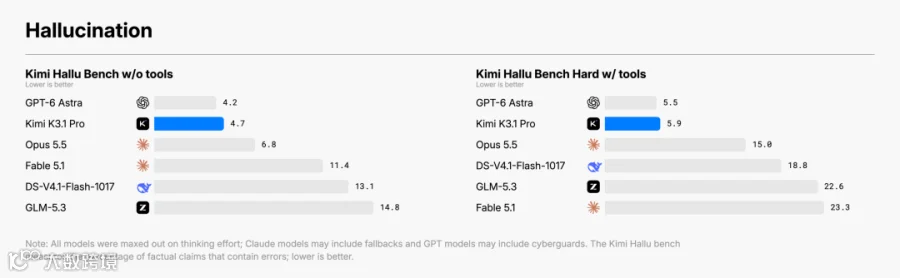
该测试样本刻意聚焦模型容易出错的情形,所报错误率不代表日常使用的整体水平。
kimi-k3.1-pro,为每百万 Token 输入 1.3 元(命中缓存)和 13 元(未命中缓存),输出 68 元;
高速版 kimi-k3.1-pro-highspeed 价格为 2 倍。