

Tensor Machines 宣布推出一款开源AI硬件基准测试工具,旨在帮助数据中心运营者回答最紧迫的经济问题:他们已经购买的硬件和电力,实际产出了多少有效的AI工作量?该基准测试将硬件行为与工作负载性能纳入一个可重复的评估框架,衡量产出有效AI输出所需的能耗和成本。

GPU规格和每小时租赁价格无法告诉运营者一个系统能够持续承担多少工作。PUE(电力使用效率)等设施指标描述了能源开销,但无法衡量设备实际产出的AI工作量。Tensor Machines 围绕满足工作负载服务要求的输出来开发这一基准测试,为运营者提供了一种评估其基础设施生产力的方法。
"GPU的经济价值来自它所交付的有效工作量,"Tensor Machines 创始人兼CEO Muneeb Rasool 表示。"运营者需要知道这些输出的成本是什么,以及这个答案如何随工作负载、功率设置和硬件状态而变化。我们正在开放这一基准测试,能够衡量这些状态并更好地利用他们已有的基础设施。"
有效输出为何重要
在NVIDIA GPU上运行其基准测试时,Tensor Machines 观察到了仅靠硬件规格或每小时价格无法揭示的差异:
同一GPU型号可以产出不同量的AI输出: 在某一项推理工作负载中,最快结果每秒交付的token数比最慢结果高出近15%。在同等每小时GPU价格下,这一差异意味着较慢结果的token成本高出近15%。
更多功耗并不能按比例带来更多性能: 在一项计算比较中,一台运行在更高功率上限的GPU多消耗了约36%的电力,而FP16计算吞吐量仅比同类高出21%。
性能差距可能随工作负载而变化: 一组在某项推理工作负载中比同类低约12%的硬件,在另一项工作负载中仅显示约1%的差距。单一排名可能会遗漏硬件最有用的场景。
这些发现特定于所测试的工作负载和运行条件。
一种可重复评估运行选择的方法
Tensor 的基准测试方案施加不同负载,并记录硬件如何消耗电力、升温、维持性能以及恢复。该基准测试旨在将这种物理响应与满足服务要求的请求比例、每个被接受输出token的能耗以及该输出的成本关联起来。
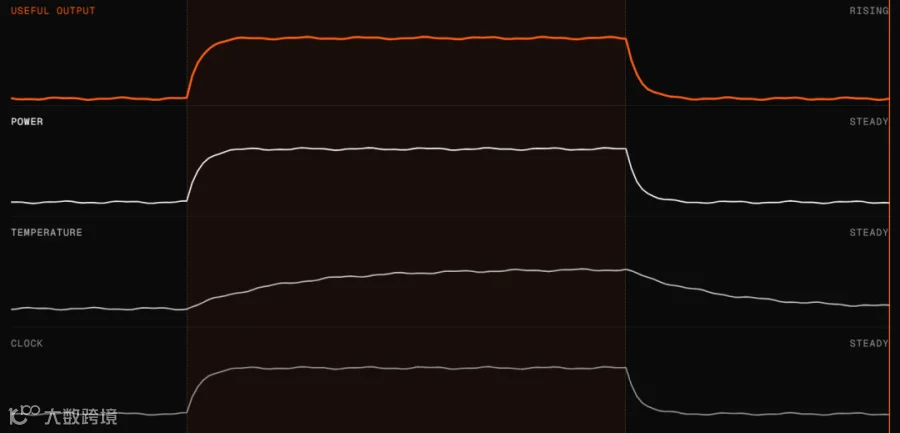
在受控变更后重复相同工作负载,可以让运营者测试不同的功率设置、工作负载放置或冷却条件是否能改善结果。Tensor Machines 专有的基于物理学的模型通过分析电力、热量、性能和硬件退化之间的关系来支持这项工作。这些模型目前正与部分裸金属提供商和neo-cloud设计合作伙伴进行私密测试。更广泛的目标是帮助运营者维持有效输出,并就硬件使用和剩余有效寿命做出知情决策。
"GPU有潜力变革边缘计算,就像它们正在变革数据中心一样,但管理GPU健康仍然是一个关键瓶颈,"德克萨斯农工大学(Texas A&M University)电气与计算机工程学教授 Sandip Roy 博士表示。"德克萨斯农工大学全球网络研究所(GCRI)有幸与 Tensor Machines 合作,评估其出色的GPU健康遥测/分析在边缘应用中的使用。"
Tensor Machines 还宣布获得由 Omni VC 领投的150万美元种子前轮融资。其他投资者包括 Reinforced Ventures、Avesta Fund 和 Draper U Ventures。
点击阅读原文访问基准测试及文档。

关于 Tensor Machines
Tensor Machines 开发基于物理学的模型和基准测试工具,帮助AI基础设施运营者了解电力、热量和硬件状态如何影响有效计算输出。其工作聚焦于计算产出率、能源效率以及GPU和服务器的有效使用寿命。

