

合成受访者 vs. 真实消费者:如何平衡效率与真实性
在早期市场调研中,如筛选创意、打磨问卷,合成受访者(Synthetic Respondents)在速度和成本上优势明显;但在高风险验证、需求测量及捕捉真实生活体验等环节,仍无法替代真实消费者。
核心结论:合成受访者是由AI生成的调研参与者,擅长快速探索想法、预判反对意见及精简概念。但在验证需求、测量价格敏感度、理解真实体验或进行重大预算决策时,必须依赖真实消费者。
合成消费者调研的吸引力在于其极速反馈:向大语言模型描述目标客户并展示产品概念,几秒内即可获得详细反馈。然而,这种速度容易让人误将“听起来像客户的话”当作“来自客户的证据”。合成内容基于训练数据和提示词生成,看似合理却缺乏真实生活经验;而真实消费者虽存在作答偏差,但其行为反映了真实市场。
因此,关键在于根据决策阶段选择证据类型:早期低成本探索使用合成调研,接近生产、定价和上市时使用真实调研。
实测对比:AI模型与真实消费者的反馈差异
为了验证两者差异,我们将相同问题分别抛给通用AI模型(ChatGPT GPT-5.6 Luna、Perplexity)及PickFu平台上的真实用户。
测试一:狗零食卖点测试(简单明确场景)
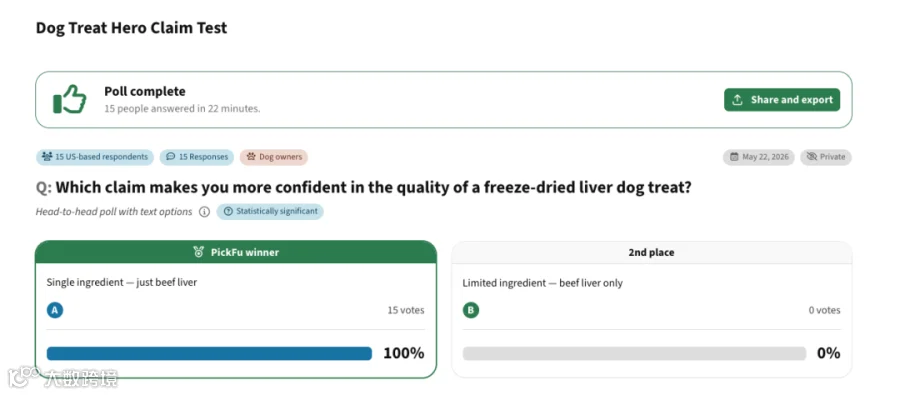
某狗零食品牌斟酌冻干牛肝零食的主打卖点:
- A. Single ingredient — just beef liver(单一成分:只有牛肝)
- B. Limited ingredient — beef liver only(有限成分:仅含牛肝)
15位美国狗主人以15比0全票选择A,理由清晰:“Limited”暗示成分不足或多于一种,易产生误导。两个AI模型均正确预测了赢家,但低估了差距:ChatGPT预测9比6,Perplexity预测12比3。
此案例表明,在选项明确、考理解而非口味的简单场景中,AI能辅助筛选,节省调研成本。
测试二:咖啡品牌标语测试(复杂争议场景)
虚构品牌Daybreak Coffee Co.测试六条标语,受众为15位美国女性咖啡饮用者:
- A. Slow mornings, made yours.
- B. Your morning, your ritual.
- C. Wake up to better.
- D. Every cup, an intention.
- E. Coffee for your quietest hour.
- F. Quality coffee, delivered.(现用标语)
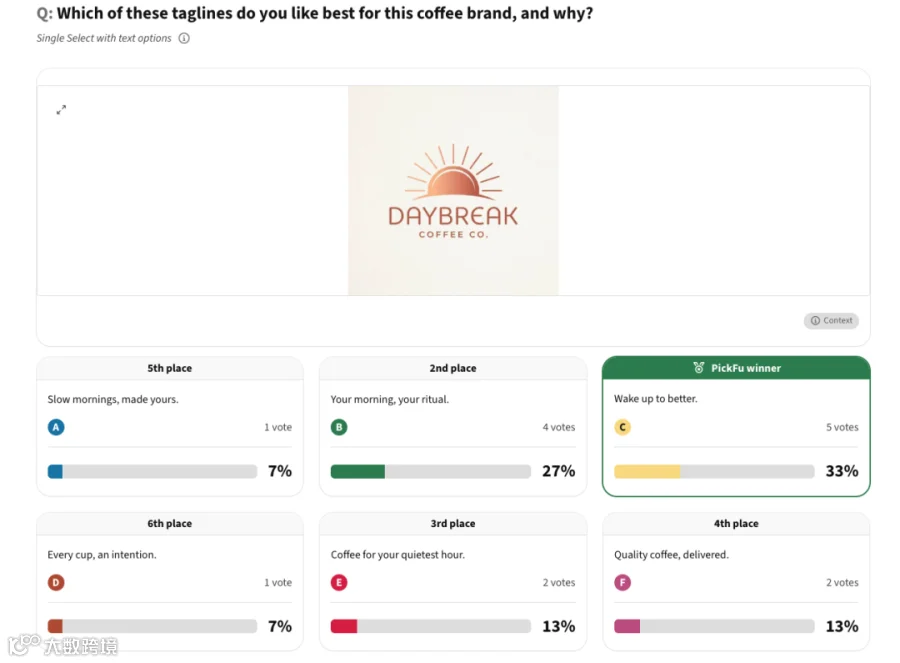
真实结果:“Wake up to better”以33%得票率胜出,现用标语F获13%得票,优于部分新候选。有价值反馈包括对“早晨”限制的质疑及新标语建议。
AI预测偏差:
- ChatGPT错误预测“Slow mornings”胜出,且完全忽略了对brief前提的质疑。
- Perplexity错误预测“Your morning”胜出,并将现用标语判为0票。
在无绝对赢家的争议性场景中,AI倾向于强行选出赢家,且彼此结论不一致,无法捕捉真实用户的细微分歧和创新洞察。
核心区别与应用策略
真实消费者的价值在于其言行落差反映的真实市场行为。例如,用户口头偏好环保包装却购买便宜产品,这种矛盾并非噪音,而是关键洞察。
| 维度 | 合成受访者 | 真实消费者 |
|---|---|---|
| 速度 | 几秒到几分钟 | 需招募和投放时间 |
| 成本 | 较低 | 需样本费用 |
| 来源 | 模型模拟 | 真实个人 |
| 行为依据 | 预测生成 | 自我报告或实际交易 |
| 生活经验 | 无 | 真实经历 |
| 偏差类型 | 模型与数据偏差 | 抽样与社会期许偏差 |
| 一致性 | 高 | 存在天然差异 |
| 新洞察 | 重复常见预期 | 可能发现意外行为 |
| 最佳用途 | 探索、假设生成、早期筛选 | 验证、需求测量、重大决策 |
| 主要风险 | 对模拟结果产生虚假信心 | 样本代表性不足或作弊 |
PickFu Synthetic Audiences的定位
PickFu推出的合成调研产品处于Beta阶段,其合成受访者以真实样本成员的历史选择为原型建模。其核心价值在于快速筛除低潜力选项,将资源集中于需真人拍板的关键决策,而非完全取代真人调研。