

一台交换机出现故障,可能影响一片业务;一条链路性能异常,也可能让整套系统的运行效率打折扣。对于普通网络来说,这已经够让运维人员忙上一阵了。如果把规模扩大到成千上万台计算设备组成的智算集群,网络运维的复杂程度还会进一步上升。
更麻烦的是,网络出了问题,并不一定会出现明显的断网现象。设备在线、接口正常,业务却可能因为链路性能下降、流量拥塞等原因受到影响。服务器和算力卡投入再多,如果数据无法高效传输,计算资源就可能在等待中被浪费。
这也是我一直关注智算网络发展的原因。过去,大家谈到 AI 基础设施,往往先想到 GPU、服务器和算力规模,但当集群越来越大,如何把网络管好,同样会影响整套系统的实际效率。
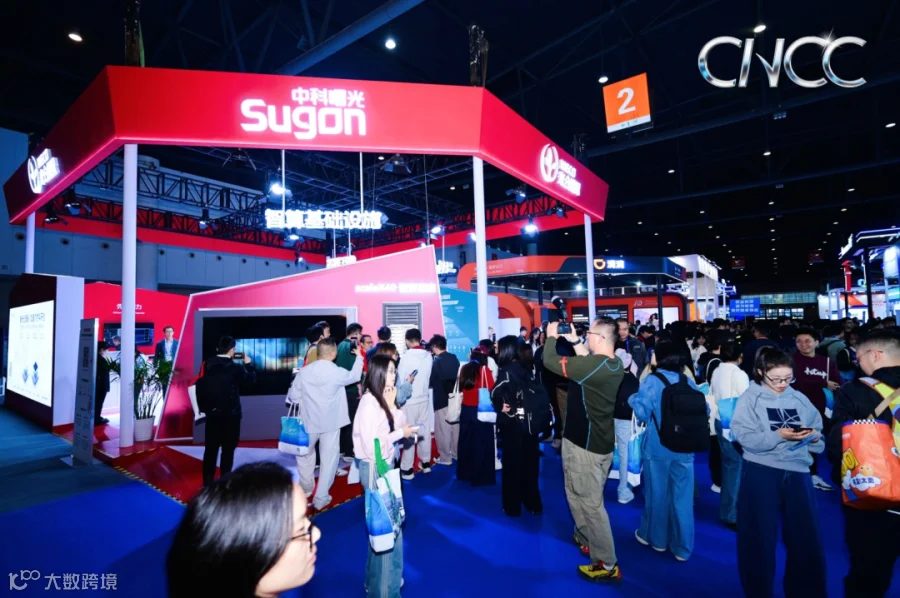
近日,在成都举行的2026中国计算机大会(CNCC 2026)期间,中科曙光正式发布 Fabricview 智算网络管理平台。这款平台面向大规模集群,可集中纳管百万量级的设备、端口与光模块,并通过自动化配置、全网监测和智能运维等能力,帮助运维人员更好地掌握网络运行状态。
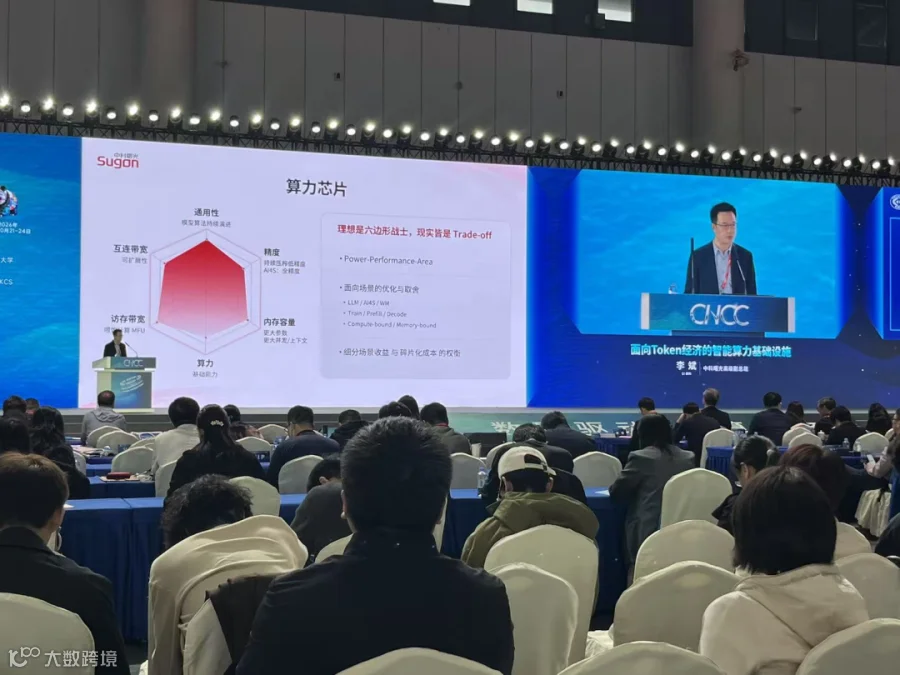
从网络工程的角度看,这次发布值得关注的,不只是一个新平台上线,而是智算网络正在从单纯追求高速互连,进一步走向规模化、自动化的统一管理。
智算网络不是把交换机连起来就够了
传统园区网络和数据中心网络已经有比较成熟的管理方法,但智算集群对网络提出了更高要求。大量计算设备需要频繁交换数据,网络的带宽、时延、可靠性和故障恢复能力,都会影响整个集群的运行效率。
尤其在大规模训练和推理场景中,网络问题未必会直接表现为链路中断。有时接口状态正常,设备也没有明显告警,但局部链路性能下降、流量分布不合理,仍然可能拖慢业务。等到运维人员发现任务效率出现变化,再逐台检查设备、核对配置、追踪链路,排查成本就可能相当高。
这也是我一直认为网络运维不能只盯着设备状态的原因。接口是 UP,不代表网络一定健康;设备没有告警,也不代表业务没有受到影响。规模越大,越需要把设备、链路、拓扑和性能数据结合起来看。
Fabricview想解决什么问题
Fabricview 的核心思路,是把分散在大规模网络中的设备、端口、光模块及运行信息集中起来,让运维人员通过统一平台掌握网络状态。
从日常运维角度看,这种能力的实际价值比较容易理解。过去需要登录不同设备、执行命令、整理数据才能完成的工作,如果能够通过平台统一呈现和自动化处理,就可以减少大量重复劳动。全网监测能够帮助运维人员更快发现异常,配置管理则有助于提高部署和维护的一致性。
平台还围绕性能筛查、异常分析和智能运维等场景完善能力,尝试把网络状态与故障定位联系起来。对网络工程师而言,我比较看重的并不是界面上展示了多少指标,而是系统能不能把异常现象、可能原因和受影响的链路关联起来,让排查从“大范围查找”变成“有方向地验证”。
当然,自动化平台并不是装上就能解决所有问题。告警是否准确、拓扑信息是否及时更新、性能数据是否足够完整,都会影响最终效果。真正好用的管理平台,应该减少运维人员的重复操作,而不是多增加一个需要维护的系统。
百万量级纳管,关键还要看实际效果
百万量级设备、端口与光模块的集中纳管,是 Fabricview 发布信息中比较引人关注的一点。对于超大规模智算集群,这意味着网络管理需要考虑远超传统小型环境的设备数量、数据采集和关联分析问题。
不过,从网络工程实践来看,纳管规模只是一个指标。平台能否适应不同网络架构,监控数据的更新是否及时,出现故障后能否快速定位,以及设备数量增长之后系统是否依然稳定,这些才是评估实际价值的重要维度。
因此,对于有智算网络建设需求的企业,除了关注规模指标,也应该关注平台与现有设备的兼容性、部署成本、告警质量和日常运维流程是否匹配。只有真正融入生产环境,管理平台的价值才能体现出来。
中科曙光此前通过 scaleFabric 高速网络积累了十万卡级集群的工程经验,此次进一步发布 Fabricview,也体现出其将高速互连与网络管理协同发展的思路。高速网络负责提供数据传输能力,管理平台则帮助运维人员掌握网络运行情况,两者共同影响集群的实际使用效率。
网络工程师的工作也会随之变化
我认为,智算网络的发展,也会给网络工程师提出新的要求。过去,熟悉交换机命令、理解路由交换协议、掌握故障排查流程,是网络运维的基本功。未来,这些能力仍然重要,但只会登录设备和查看接口状态,可能已经不够了。
面对大规模网络,工程师还需要理解网络拓扑、性能指标、自动化配置和数据分析,知道如何利用平台缩小排查范围,也要能够判断系统给出的分析结果是否合理。工具可以帮助我们提高效率,但最终的网络判断依然离不开技术积累。
Fabricview 的发布,让我们看到智算网络管理正在向集中化、自动化和智能化发展。对网络行业来说,这不是简单地增加一个管理软件,而是网络建设的关注点正在从“连接起来”,进一步转向“长期稳定地运行”。
算力规模决定了基础设施能承载多少任务,网络效率和运维能力,则会影响这些算力能否真正发挥作用。随着 AI 集群继续扩大,谁能把网络管得更清楚、故障处理得更快,谁就更有机会把硬件投入转化为实际的业务效率。