
【议程发布】CeMAT ASIA同期活动|智能装卸2026新技术及应用案例分享交流会诚邀莅临




|
|
|
|---|---|
|
|
|
|
|
|
|
|
|

-
启发式优化路线(代表:CN115545312A,基于干线运输类型的汽车零部件物流三维装载):以装载率最优为目标、货物顺序与位置为决策变量、尺寸/优先级/预留空间为约束构建静态数学模型。缺陷:依赖静态模型与固定规则,面对多配送点装卸顺序、货物稳定性、设备状态变化等实时约束时搜索效率低、收敛慢,无法动态调整策略,难以平衡装载率、成本与操作可行性等多目标 。
-
数字孪生可视化路线(代表:CN117495221A,基于数字孪生场景的全自动智能装车控制):通过传感器/摄像头采集现场信息、构建虚拟场景并实时展示。缺陷:数字孪生仅用于监控展示,不参与智能决策;装车方案生成与实际执行分离,未将车厢实时空间状态与异形货物间的承重、稳定性、间隙等物理约束一体化建模与动态优化 。
-
强化学习运筹路线(代表:CN114037335A,最大化承运能力的车货匹配):以动态时间窗 + 动态规划 + 二部图最大权匹配(Kuhn-Munkres)做车货匹配,强化学习用于窗口切割策略。缺陷:面向车货匹配而非三维装箱顺序决策,无法处理承重、稳定性、间隙、装卸顺序等复杂物理约束;无数字孪生实时映射与货物动态预测 。

-
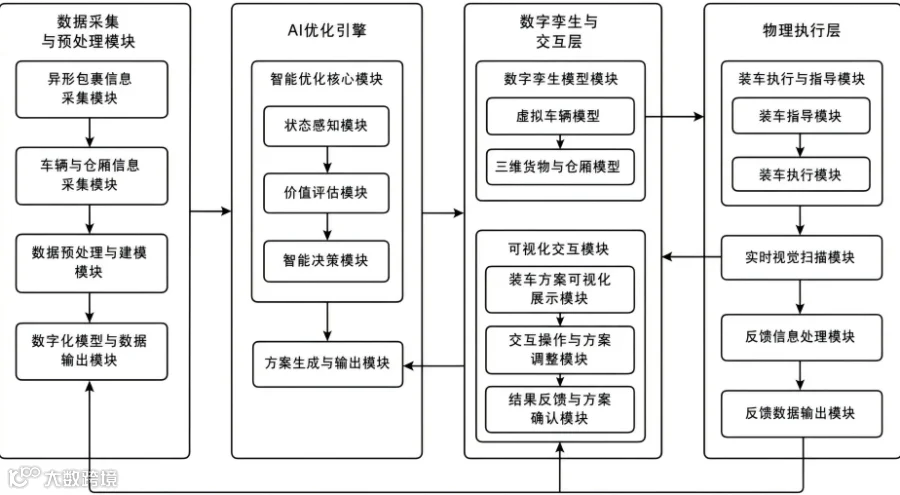
数据采集与数字化模块:工业相机/扫描仪识别异形包裹,采集尺寸、重量、物理属性、订单配送顺序与车辆数据;按目的地、尺寸、品类做属性组分类,按重量分级(保证"下重上轻"基础稳定性);结合多约束知识库完成货物数字化建模 。 -
AI优化核心引擎:系统"决策大脑",含状态感知单元、价值评估单元、智能决策单元,另配离线训练单元 。 -
数字孪生与交互层:C1 可视化平台(360°旋转、缩放、分层查看)+ C2 交互终端(Three.js 3D 可视化、分步动画指导、手势/AR 指引)。 -
物理执行层:装车机器人/人工执行 + 实时视觉扫描反馈(深度相机/激光雷达点云比对)。
-
数据预处理:获取异形包裹属性数据与车辆数据;按目的地/尺寸/品类做属性组分类,按重量等级划分,得到货物分组信息(缩减搜索空间,并为同类归集奖励提供分组依据)。
-
状态初始化:根据作业计划(桥吊作业计划或订单卸货顺序)确定装车作业序列;将装车过程建模为马尔可夫决策过程(MDP);初始化车厢空间为全空、待装货物集为全集;设备状态同步至数字孪生 。
-
状态感知(循环内):从数字孪生获取当前车厢剩余空间状态(最大空洞法或三空间分割法表示)、待装货物集、设备实时状态 。 -
候选评价(循环内):对满足预配位属性约束与重量约束的全部候选货物,计算评价值 $f(c)=\theta^{\Delta h}\times(V(S_c)+\delta)$(融合 DQN 空间状态价值、翻箱惩罚因子、同类归集奖励因子)。
-
智能搜索与决策(循环内):不直接选评价值最高者,而是对评价值排名前 W 个候选各建一条深度为 D 的多分支推演,比较各分支综合收益(以多目标函数 F 为导向),选择综合收益最优分支对应的货物及其摆放位置与姿态 。
-
状态更新(循环内):将货放入车厢,更新数字孪生中的车厢剩余空间状态、货物堆叠状态与设备任务队列。
-
循环终止与输出:循环执行 3–6 直至所有货物装载完毕,输出完整装车方案。
-
可视化与交互:三维渲染装车方案,360°旋转/缩放/分层查看;向装车人员提供分步装车指导动画;支持人工手动调整货物位置,系统实时做碰撞检测与承重稳定性校验,校验通过后将调整反馈至引擎做局部再优化,形成"AI智能规划—人工经验判断—系统再优化执行"闭环。
-
状态 S:车厢剩余空间几何特征 + 待装货物集特征(异形轮廓、重量、优先级)+ 设备状态特征。 -
动作 A:待装货物选择 + 异形包裹摆放姿态(旋转、平移、堆叠)+ 车厢摆放位置 + 设备调度指令 。 -
奖励 R:多维加权机制——正向奖励关联容积利用率、稳定性、设备利用率提升;负向奖励关联翻箱率、拼车率、货物违规堆叠、空间浪费。 -
优化目标:最大化从当前决策步骤 t 至决策结束的累计折扣奖励
-
数据构造:从历史装车数据提取 $(S,A,R,S')$ 四元组,构建经验回放池(FIFO 队列,容量 10000,满则淘汰最旧)。 -
网络结构:主 Q 网络为 3 层全连接神经网络(512/256/128 神经元),拟合状态-动作对 Q 值;目标 Q 网络结构相同,提供稳定训练标签,避免 Q 值震荡。 -
目标 Q 值
-
损失函数(均方误差)
-
训练参数:批量 64;Adam 优化器;学习率 0.001;训练 5000 轮;收敛判据为损失连续 100 轮不再下降;目标网络硬更新(直接参数复制)周期为每 1000 次训练迭代。 -
训练产物:训练完成后主 Q 网络可输出任意箱区状态的空间状态价值 $V(S_c)$(反映从该箱区发箱的长期收益,综合设备利用率、阻塞风险、后续装载难度等因素)。专利称训练后 Q 值收敛至 0.85–0.92,整体优化效果较传统算法提升约 15%。
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
-
$\eta_{V}$:车厢容积利用率
-
$\eta_{R}$:翻箱/拼车率($1-\eta_R$ 越大越好) -
$\eta_{S}$:装车稳定性系数
-
$h_{safe}$ 车厢最大安全重心高度,$h_{avg}$ 货物平均重心高度(重心越低越稳); -
$S_{contact}$ 堆叠实际接触面积,$S_{goods}$ 货物底部面积(接触越充分承压越均匀); -
$W_{bottom}$ 底部层货物总重,$W_{total}$ 已装货物总重(重物在下的倾向)。 -
权重自适应:$\omega_1,\omega_2,\omega_3$ 可随装车场景(整车/拼车、易碎品/普通品、大容积/高稳定性)动态调整。
-
作用:预测未来待装货物的数量、异形尺寸分布、流向分布,代入数字孪生仿真环境,提前调整预留空间分配与设备调度策略,降低因货物动态变化导致的翻箱率与拼车率。 -
网络结构(实施例):输入 32 维时序特征(货物到港时间、数量、平均长宽高、平均重量、目的地 one-hot 编码等),时序窗口 24 小时;2 层 LSTM(各 128 单元,遗忘/输入/输出三门控)+ 全连接层 64→32 维,输出未来 24 小时货物动态预测(数量、尺寸、流向、到港峰值)。 -
训练:MSE 损失、Adam、学习率 0.001、3000 轮;专利称预测准确率 87%、MAE < 15%。 -
应用策略举例:预测 2 小时内大量同目的地货物到港 → 提前预留空间(预留比例控制在车厢总容积 10% 以内);预测 4 小时内货物少 → 优先完成当前批次、减少设备闲置(设备利用率 +5%);预测 6 小时内异形尺寸集中 → 提前规划姿态堆叠,高价值货物用体素化/点云精细化建模,普通货物用轴向包围盒(AABB)近似(空间利用率 +3%)。
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|

-
以 MDP + 离线 DQN 构建"长期价值"决策基准:将装车从"一次性静态几何优化"重构为"序贯决策问题",并用历史数据离线训练 Q 网络输出箱区状态的空间状态价值 $V(S_c)$,使在线决策具备对"未来剩余空间可装载性"的前瞻判断,从机制上区别于贪心式单步最优。 -
评价函数的业务规则深度编码:$f(c)=\theta^{\Delta h}\times(V(S_c)+\delta)$ 将翻箱惩罚(指数衰减)与同类归集奖励($\delta$)嵌入 AI 评价值,属于"学习价值 + 领域规则"的混合决策范式,比纯神经网络或纯规则方法在工程语义上更可解释、更容易让现场人员接受。 -
Top-W × 深度 D 多分支推演:在候选层面引入受限前瞻(近似 beam search),规避"只按当前评价值贪心"的缺陷,将搜索预算(W 与 D)以显式参数暴露出来,便于按算力与节拍要求调节。
-
数字孪生贯穿"规划—执行—校验—再优化":车厢空间、堆叠状态、设备任务队列三类对象实时同步;人工微调后做碰撞检测与承重校验并触发局部再优化,把"人的经验"接入 AI 闭环,是该类方案中少见的完整人机协同设计。
-
预测 + 感知双闭环:LSTM/GRU 时序预测未来到货(数量/尺寸/流向)→ 预留空间前移决策;深度相机/激光雷达点云比对 → 修正操作误差。前者给系统"前瞻性",后者给系统"现实感",共同增强对动态物流场景的鲁棒性。
|
|
|
|
|
|
|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
-
长期价值收益:DQN 训练得到的 $V(S_c)$ 隐式编码了"当前把空间用掉后,剩余空间还能否容纳后续货物"的长期信息。对装箱这类"空间资源逐步消耗"的问题,这恰好是对贪心缺陷的针对性补救——专利方向选得准。 -
翻箱/拼车双因子直击物流痛点:翻箱是装卸流程中纯浪费环节(耗时、耗能、易损),拼车率决定车辆周转效率。把这两个 KPI 直接编码进评价值,方案与运营考核指标强对齐,落地时易于量化验证。 -
可解释性+可控性:$f(c)$ 的三个因子分别对应"长期价值 / 翻箱代价 / 归集收益",参数 $\theta、\delta$ 可人为调校,W、D、$\omega_{1..3}$ 全部暴露为配置项——对制造业/物流企业而言是可审计、可调优的白盒结构,而非黑箱。 -
人机闭环的工程价值:让 AI 出方案、人做微调、系统复核再优化,既利用了 AI 的全局搜索能力,又保留了现场人员的经验裁决权,在自动化水平不高的场景(人工装车居多)可显著降低推广阻力。
-
现象:在线决策分两层——先按 $f(c)$(含 DQN 价值 $V(S_c)$)选 Top-W 候选,再按多目标函数 $F$(容积率/翻箱率/稳定性线性加权)评选分支综合收益。 -
机理:$V(S_c)$ 是 DQN 学到的"长期折扣奖励期望",而 $F$ 是人工设定的"当前路径统计指标加权"。两者不存在一致性保证:DQN 的奖励口径(专利未给出奖励函数的具体表达式与权重)与 F 的三项指标并无数学等价关系。可能出现"价值最高的候选在 F 口径下并非最优"的系统性错配。 -
后果:训练目标与部署目标漂移,15% 的效果声明缺乏可复现口径;现场调优时无法判断该调 $\theta$、$\delta$ 还是 $\omega$。 -
改进方向:统一优化目标(见 4.3.2),使搜索与训练共享同一个目标函数。
-
现象:Q 网络为 3 层全连接)。 -
机理:装箱状态的核心信息是空间拓扑(空洞的形状、位置、可达性、货物间的支撑邻接),全连接网络对空间结构没有归纳偏置,需要大量样本自行学习平移/旋转不变性;且 状态输入未给出明确的特征化设计(仅描述为几何特征、货物集特征、设备状态的拼接)。 -
后果:样本效率低、泛化差;对旋转对称的等价状态(同一布局旋转 90°)需重复学习;状态表示不直观,工程师难以验证网络"看到"了什么。 -
改进方向:体素占用网格 + 图神经网络(GNN)双通道编码(见 4.3.4)。
-
现象:Q 网络只输出"箱区状态价值",不直接输出"动作"(选哪件货、放哪、什么姿态);动作由候选枚举(满足预配位约束的货物)+ 位置姿态穷举/启发给出。 -
机理:DQN 本质是离散动作 Q 值估计器,而装车的动作空间是"货物选择 × 位置 × 连续姿态"的组合空间,无法直接作为 DQN 输出;专利以"评价排序 + 受限搜索"绕过,但搜索复杂度为 $O(W\times D\times |\text{候选动作集}|)$,随货物数和棋盘格粒度急剧膨胀,节拍时间受控性弱。 -
后果:算力需求随问题规模非线性增长;"动态深度 D"未定义自适应规则,工程上只能取固定小值,前瞻收益打折。 -
改进方向:策略网络直接输出动作分布(actor 头)+ MCTS 引导(见 4.3.2)。
-
现象:DQN 完全基于历史装车数据离线训练 ,且回放池容量仅 10000 条。 -
机理:历史数据大多是人工/旧算法产生的非最优轨迹,离线学习的策略上限受制于数据质量("学的最优不超过历史上出现过的好");新业务场景(新包装规格、新车型)无历史数据 → 冷启动;10000 条回放池对"状态—动作"空间庞大的装箱问题偏小,且无在线探索、无仿真自举,无法自我进化。 -
后果:对数据不充分的新客户、新航线,首版效果可能低于传统启发式;效果声明(15%)依赖特定数据集,跨场景不可迁移。 -
改进方向:仿真环境自对弈式训练 + 课程学习 + sim2real(见 4.3.7)。
-
现象:三空间分割法按"上、前、右"三方向切割,每次放入后分割原空间 ;异形件建模靠 AABB 近似或体素化 。 -
机理:三空间分割源自"轴对齐长方体装箱"的 guillotine 切割思维,只对规则长方体堆叠高效;对圆柱、锥台、托盘+货物组合等异形件,轴对齐分割会产生大量不可用的碎空间(AABB 近似对倾斜放置收益为零——AABB 不表达旋转),体素化又内存爆炸、精度受限。 -
后果:专利宣称"适用于异形包裹",但核心空间表示实质仍是长方体思维,对真正的不规则体装车(例如带鼓包、异形托盘、桶类)空间利用率提升有限;"旋转姿态"在动作虽被提及,但三空间分割的空间表示难以表达旋转后空隙。 -
改进方向:体素占用 + 连续姿态回归 + 物理仿真占用校验(见 4.3.3/4.3.5)。
-
现象:稳定性仅用重心高度、接触面积、底部重量占比三个统计量加权 + 总倾覆力矩阈值 [0061]。 -
机理:统计指标无法刻画:接触面压力分布不均导致的局部压溃、易碎品承压链、运输途中制动/转弯的惯性倾覆、堆叠后货物间微位移累积。倾覆力矩约束 $\sum W_i h_i \le W_{safe}$ 是整体量级,无法定位"哪一层哪一件最危险"。 -
后果:对易碎品、精密件、液体容器等"姿态/承压敏感"货种,方案可能在统计指标上"达标"而在物理上不可行,导致现场返工;人工微调后的校验也就只能做几何级校验。 -
改进方向:GPU 物理引擎逐候选批量仿真 + 概率性安全裕度(见 4.3.3)。
-
现象:$\Delta h$ 只计翻箱次数(不计翻出货物的重量、体积、耗时、易损性差异);$\delta$ 仅在"双箱工艺且存足量同组货物"时生效 [0054]。 -
机理:翻箱的真实代价与货物吨位、体积、搬运距离强相关,次数指标过于粗糙;$\delta$ 的设计依赖特定工艺(双箱),对单箱、多箱、跨月台作业不生效,通用性受限。 -
后果:评价函数在复杂拣选场景下失真,参数普适性差。
-
现象:LSTM 输出未来货物数量的点估计;预留空间用固定启发式(2h 内到货多→预留 ≤10% 容积;4h 内到货少→先装当前批)[0066]。 -
机理:点估计丢弃了预测不确定性(分布信息);10% 预留是经验阈值,未考虑"预留位置的机会成本"(把好位置留给了可能不来的货)。预测模块与决策引擎仅在"预留"上单向交互,未进入训练目标。 -
后果:预测误差传导为空间浪费或预留不足,鲁棒性收益上限被封顶;"准确率87%/MAE<15%"为模型级指标,非装车 KPI 级验证。 -
改进方向:概率预测 + 期望价值预留 + 预测参与训练目标(见 4.3.6)。
-
现象:全部决策围绕"一辆车一个车厢"的 MDP;多车、多月台、中转衔接、车辆到达时序未进入优化对象。 -
机理:MDP 状态只含"当前车厢空间、当前待装集、当前设备状态",天然是单域建模;车辆指派、月台分配、批次发车时序属于更高层运筹问题,被"作业计划"参数化后假定为已知输入 [0050]。 -
后果:单车厢最优不等于场站整体最优(如载重利用率高但车辆等待链路失衡);对大流量枢纽场景价值受限。 -
改进方向:分层决策框架,上层网络级调度 + 下层车厢级装箱联合建模(见 4.3.1)。
-
撰写质量:权利要求 1 覆盖"预处理→MDP→评价→搜索→孪生→交互"完整闭环,独立权利要求层次清晰;从属权利要求覆盖训练、评价公式、空间分割、预测与感知闭环,保护面较完整。但评价函数、F 函数、稳定性系数均以具体公式限定,审查中可能面临"功能性限定 + 数学公式是否被认定为实质技术特征"的争辩;奖励函数 R 的构造([0040] 仅文字描述)未给出具体实现,可实施性上留有缺口。 -
新颖性/创造性风险:DQN、LSTM、数字孪生、三维装箱各自均为成熟技术;创造性论证的关键在于组合是否有非显而易见的技术效果。翻箱/拼车因子嵌入评价函数、多分支推演、预测+感知双闭环的组合方式是亮点,但需与"装箱强化学习""数字孪生装箱"类在先文献拉开距离。 -
落地评估:方法所需硬件(深度相机/激光雷达、3D 渲染终端、算力)均为通用器件,实施门槛适中;主要风险在数据侧(历史装车数据标注成本高、四元组提取依赖装车过程数字化)与节拍侧(W×D 搜索在秒级节拍下的实时性)。定性判断:作为"高校申请"具备较强方法学价值,作为"可直接量产软件"仍有工程化距离——这恰好是第三部分改进方案要补的短板。

|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
┌────────────────────────────────────────────────────────────────────┐│ ① 感知层:深度相机/激光雷达点云 + 称重/托盘识别 +RFID/批次信息 ││ ↓ 多模态融合特征(体素化 + 属性向量) ││ ② 预测层:概率时序模型(DeepAR/扩散时序)→ 未来到货分布的预测区间 ││ ③ 网络级决策层(L1):多车-多月台-时间窗协同指派(列生成+启发式) ││ ↓ 输出单车装载任务(货物批次、车厢模板、时间预算) ││ ④ 车厢级决策层(L2):神经MCTS 装箱搜索(每步选货+位置+姿态) ││ ⑤ 物理验证层:GPU 物理引擎批量仿真(稳定性/承压/倾覆概率) ││ ⑥ 约束引擎:CP-SAT 硬约束预筛(危险品隔离/易碎禁压/通道预留/承重链) ││ ⑦ 数字孪生层:实时状态同步 + 方案3D渲染 + 操作分步指导 ││ ⑧ 执行层:机器人/人工执行 + 实时视觉反馈 ││ ⑨ 学习层:执行偏差回馈 → 在线微调(residual 网络)/ 离线重训 │└────────────────────────────────────────────────────────────────────┘数据流:①→②→③→④→⑤→⑥→⑦→⑧;反馈流:⑧→①(点云修正) ⑧→⑨→④
-
L1 网络级(调度层):将车辆、月台、批次待装货物、车辆到达/发车时间窗建模为带时间窗与载容约束的车辆指派问题,用列生成 / 大邻域搜索启发式求解,输出各车装载任务(货物子集、装载优先级、时间预算、容积/载重预算)。决策频率:分钟级。 -
L2 车厢级(装箱层):对单车执行序贯装箱决策(见 4.3.2),以 L1 给定的预算与优先级为约束。决策频率:秒级(每件货)。 -
L3 姿态级(几何层):在 L2 选定"货物 + 货位网格"后,用连续姿态回归网络输出旋转角 $\phi\in[0,360°)$ 与微位移,经物理验证接受或拒绝。 -
增益:L1 吸收"跨车/跨月台"的高层运筹信息,L2 专注几何序贯决策,L3 吸收连续几何自由度;求解规模从"单问题全解"降为"分层聚焦",可扩展至多车协同与枢纽场景。
-
网络结构:共享编码器(体素 CNN + GNN)之后分两路——策略头输出动作分布 $\pi(a|s)$(动作定义为"候选货物 × 货位网格 × 姿态分档"的混合空间),价值头输出标量 $V^*(s)$。价值头与策略头共享同一目标:以物理验证后的期望收益为标量目标(见 4.4),从根因上消除"双评估目标不一致"。 -
搜索过程:在决策节点上执行 MCTS——选择(UCB 公式,结合先验 $\pi$ 与访问次数)→ 展开(网络评估子节点)→ 模拟(向前推演 $d$ 层,用价值头做叶节点评估)→ 回传。搜索预算 $N_{sim}$ 按剩余待装件数与节拍余量动态分配($\propto$ 剩余可行性不确定性),取代固定 W×D。 -
理论性质:MCTS 是"策略改进 + 策略评估"的在线自举过程,单步计算量 $O(N_{sim})$ 可预估、可设上限,节拍可控性优于固定分支枚举;且与训练目标同构(AlphaZero 框架下搜索策略即可再回灌训练数据),形成"学习→搜索→再学习"闭环。 -
增益:决策质量理论上高于"排序+分支"启发组合;搜索预算可自适应;离线/在线一致性有保证。 -
对 L2 给出的每个候选方案(或 MCTS 叶节点方案子集)在 GPU 物理引擎(如 Bullet/PhysX/JAX-PhysX 批处理模式)中批量仿真:施加重力、堆叠接触、装车后的制动/转向惯性载荷场景,输出倾覆概率 $p_{tip}$、峰值局部压强 $p_{max}$、支撑链完整度。 -
将仿真结果转换为概率性安全裕度注入决策目标(见 4.4 公式),并作为训练损失的一项(physics-informed loss,见 4.3.7),使网络在训练阶段就"学会避开"物理不可行方案,而非在线才验证。 -
高价值/易碎品强制逐方案仿真;普通货物以 AABB+简化摩擦模型加速(分级 fidelity 调度)。 -
增益:从"统计指标达标"升级为"动力学可行 + 概率裕度",显著降低现场返工;为人工微调提供"实时物理校验"而非仅碰撞检查。 -
体素通道:将车厢空间网格化为 $W\times H\times L$ 体素占用图(多分辨率:粗网格全局 + 细网格局部),经 3D CNN 编码——保留空间拓扑、可自然表达任意异形轮廓,替代仅支持轴对齐的三空间分割。 -
图通道:以已装货物为节点、以"接触/支撑/相邻"为边建图,节点特征含类别/重量/易碎等级,边特征含接触面积/支撑关系——GNN 显式建模承重链与堆叠依赖(A 压 B、B 承 C),这是全连接网络无法表达的。 -
两通道特征融合后作为策略头/价值头输入。 -
姿态表达:货物姿态用连续旋转角 + 六自由度微调表示,经姿态可行性网络(或轻量穿透检查)约束,支持任意旋转角,突破"轴对齐 + AABB"限制。 -
在 L2 的每个决策步,先用约束编程求解器(CP-SAT)或规则引擎对候选动作做硬约束预筛:体积不超、载重不超、危险品隔离间距、易碎品禁压(承重链检查)、禁止区/通道预留、姿态可行集合。满足硬约束的动作才进入网络评候选。 -
软约束(稳定性、翻箱、归集)进入目标函数加权——形成"硬约束关闭不可行、软约束引导择优"的工程上标准的两级约束架构,替代专利中软硬混在一个公式的做法,可验证性更强。 -
预测层:用概率时序模型(DeepAR / 扩散时序模型,替代单点 LSTM)输出未来到货的分位数区间(数量、尺寸分布、流向分布),同时给出不确定性校准(区间覆盖率)。 -
预留决策:预留空间不再按固定 10% 启发式,而是求解"预留的位置与大小"使期望总收益最大:
-
双向耦合:预测误差(覆盖率检验)与预留机会成本进入 KPI 监控,必要时触发预测模型重训;预测结果同时反馈给 L1(影响车辆指派),形成"预测→调度→装箱→预留"全链路闭环。 -
仿真环境即数字孪生:把数字孪生仿真环境同时用作训练环境(专利中数字孪生仅用于在线映射与交互,未用于训练)。在 GPU 上并行开数千局自对弈,每局用当前网络 + MCTS 决策并收集 ($s,a,\pi_{MCTS},F^*$) 样本,训练目标:
-
课程学习:按难度递增组织训练(先规则长方体 → 再异形件 → 加易碎品 → 加动态到货),提升收敛速度与最终策略质量。 -
sim2real:在线部署后,视觉点云比对得到的执行偏差(专利仅用于修正模型)同时用于两类学习:① residual 微调——在线小批次更新策略头的残差层,吸收"仿真与现实的静差";② 偏差样本回流离线数据集,定期重训。 -
增益:非依赖历史数据冷启动、具备自我进化能力,且通过 sim2real 弥合"仿真最优 ≠ 现场可行"的鸿沟。 -
保留专利的"分步指导动画 + 人工微调 + 校验 + 局部再优化"闭环。 -
增强 1(约束式交互):人工调整不再直接改坐标,而是输入约束语义("这箱不能压""这两件必须相邻""预留这个月台的通道"),由约束引擎吸收后触发重规划——减少人工微调对全局最优性的破坏。 -
增强 2(差异高亮):数字孪生渲染中高亮"物理验证低裕度区"(如承压临界、重心偏差),引导操作员把干预精力放在真正风险点。 -
增强 3(现场 AR 叠加):保留 AR 指引但改为低成本 WebGL/移动端方案,降低终端门槛。
-
$\hat{p}{tip},\hat{p}{crush}$:物理引擎输出的倾覆概率与局部压溃概率(4.3.3); -
$w_k^{rel}$:翻出第 k 箱的代价权重(重量/体积/易损性归一化)——取代仅计次数(解决局限7); -
$g(c)$:货物品类/流向统一的归集收益(任意工艺下都生效,不再限定双箱); -
$\beta_1,\beta_2,\gamma_r,\gamma_g$:可配置权重,与 $\omega$ 系列一样暴露为运营参数。
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
-
算力与节拍:物理仿真 + MCTS 的算力需求显著高于原专利;需 GPU 边缘计算节点或降级调度(普通货跳过物理仿真)。量化权衡是 P1 阶段必须完成的工程决策。
-
仿真与现实差距(sim2real 鸿沟):物理引擎的摩擦、接触模型与真实纸箱承压特性存在误差;需现场数据持续校准引擎参数(可解释的静差比黑箱网络更容易调)。
-
动作空间规模:体素分辨率与"状态→动作"映射的规模呈立方增长;需多分辨率调度与分层裁剪控制复杂度,避免指数爆炸。 -
训练时长:自对弈训练核心策略需数千 GPU 小时量级;建议采用课程学习 + 预训练(先通用装箱再微调异形件)摊薄成本。
-
组织配套:约束式人机交互、风险高亮依赖现场作业规范;需与仓储管理系统/月台系统对接数据(订单、到港、设备任务),数据治理是前置条件。

END
-全球智能装卸车机器人联盟引领行业发展-
扫码加企业微信申请加入行业群