

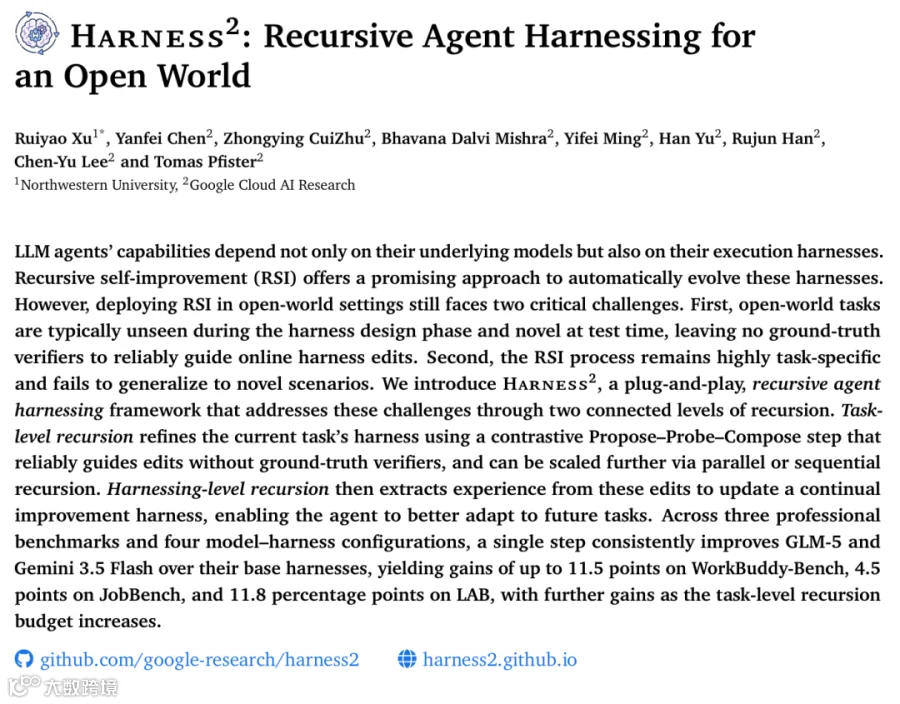
Google Research 开源了 Harness²:一个让 Agent 面对新任务时,自己改进运行框架、再把改进经验留给后续任务的项目。
论文在办公、专业工作和法律任务上做了测试。GLM-5 配合 OpenCode,在 WorkBuddy-Bench 上只进行一轮改进,平均分就从 64.2 提到 75.7。
先修好一次交付
论文里的一个 JobBench 任务,是替制作团队整理排期、人员和预算,产出彼此对应的交付文件。
Gemini 3.5 Flash 跑在原版 OpenCode 里,第一次只拿到 43.1 分。研究者翻看执行记录,发现了两个问题:几份源文件里的数字没有交叉核对;输出文件写完以后,也没有重新打开检查。
Harness² 先补工作流程:分析前先盘点全部输入,每个数字追到对应来源;交付前运行检查脚本,重新打开产物。再补这类任务的具体做法:排期、场地、用工和预算怎样对齐,文件冲突时以谁为准,哪些支出已经确定、哪些还附带条件。
工具说明也加上了具体处理办法:表格里的 "$50" 和 "1,200",先去掉符号和逗号,再参与运算。
检查脚本还会重新打开表格,确认写入的公式已经算出结果。
几项修改组合起来后,Agent 重跑了同一个任务。这次数字对上了,备忘录缺失的部分也补齐了,得分来到 77.8。
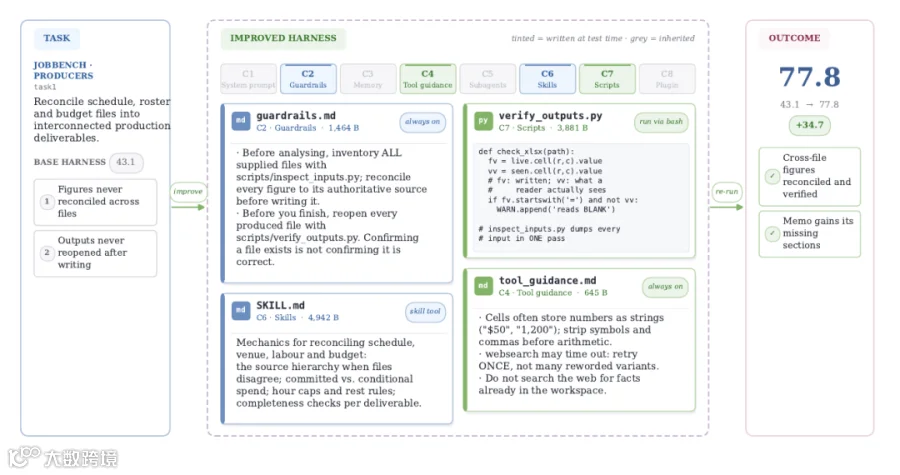
论文图9:同一制作统筹任务的失败、框架修改和重跑结果
让执行记录决定怎么改
新任务没有标准答案,Harness² 怎样选择改法?
Harness² 先保留原版框架跑出的轨迹和文件,把它们作为对照。接着,两位编辑 Agent 分头起草候选框架:一个查跨任务都会出现的问题,比如规划、工具调用、上下文和分工;另一个查当前领域的知识与流程。
编辑 Agent 可以直接修改八类组件,包括系统提示词、记忆、Skill、执行脚本、子 Agent,以及工具调用外层的插件。
各个候选框架随后在相同模型和环境配置下重跑同一个任务,检查新增核对有没有执行、脚本能否打开产物,以及修改是否引入了新问题。
Composer 再读取这些执行记录和文件差异,选择有依据的改动进行组合。有冲突就调整,只保留一个候选也可以,证据不够时也可以维持原样。组合后的框架还要实际跑一遍,得到最终交付物。
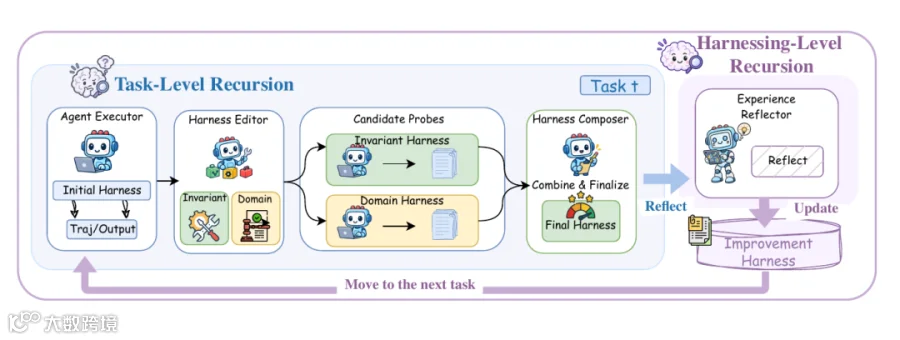
论文图3:当前任务的修改、试跑与组合,以及跨任务的经验更新
这轮选择依据任务要求、源材料和执行差异,不使用评测标准答案;模型的共同偏差和运行随机性仍可能影响判断。
把经验留给下一道题
一次任务结束后,Reflector 会回看整轮过程:哪里暴露了问题,试了哪些修改,哪些得到执行证据支持,又出现了什么副作用。
值得留下的,会连同可执行框架一起进入改进库。每条记录有一份 EXPERIENCE.md,写清适用情境、经验和支撑它的观察;证据不足,就不新增经验条目。
下一道任务仍从共同的基础框架出发。 编辑 Agent 按需查库,复用或调整其中的组件,不把上一题的整套特殊流程直接搬过来。
这也是 Harness² 名字里“平方”的意思:一层改眼前执行任务的 harness,另一层积累“怎样改 harness”的经验,帮助后面的修改。
论文专门拿掉经验库做了对照。Gemini 3.5 Flash 配合 OpenCode、只改进一轮时,WorkBuddy-Bench 从 77.5 降到 74.4,JobBench 从 36.0 降到 34.2。把两位有明确分工的编辑换成通用编辑,或者取消组合环节,也都会掉分。
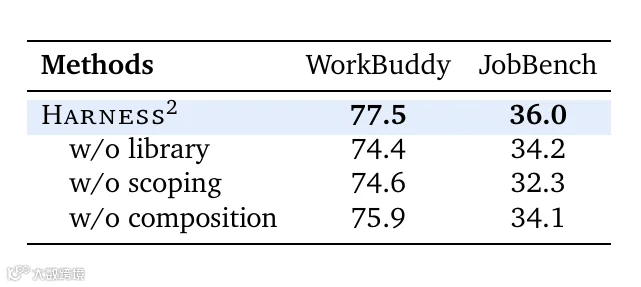
论文表3:移除经验库、编辑分工或组合环节后的结果
团队还把 JobBench 上积累的库带到 WorkBuddy-Bench,代码、网页和办公三类任务分别多了 0.6、0.5 和 2.9 分。
同一个模型的提升空间
主实验用了 Gemini 3.5 Flash 和 GLM-5,分别搭配 OpenCode、Codex,两两组成四种配置。除了 WorkBuddy-Bench,还测了长流程专业任务 JobBench,以及法律工作基准 LAB;主表是三次打乱任务顺序运行后的均值。
一轮改进后,四种配置在三个基准上都超过各自基础框架。最大的提升分别达到 11.5 分、4.5 分,以及 LAB 按评分细则计算的通过率增加 11.8 个百分点。这些最大值来自不同配置。
增加计算预算后,可以并行探索更多候选再组合,也可以沿前一版框架继续修改。
在 Gemini 3.5 Flash+OpenCode 这组配置里,把并行探索预算从 k=1 提到 k=5,WorkBuddy-Bench 的平均分从 77.5 升到 80.8,相对基础框架总共高了 8.4 分。JobBench 则从 36.0 升到 39.0,相对基础框架高 7.5 分。

论文图1:Gemini 3.5 Flash+OpenCode 的分项结果与预算扩展,左侧使用k=5
Google DeepMind 开发者 Philipp Schmid 的发布介绍,重点提到的也是这组结果,以及 Skill、脚本和跨任务经验的作用。
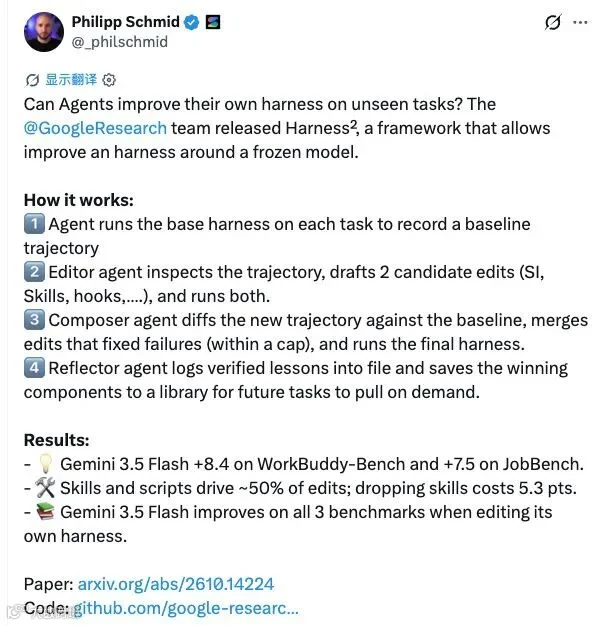
论文将试跑、编辑和最终执行的 token 一并计入成本。即使最后一次执行更省,额外改进仍可能增加整轮开销。
主实验默认由 Claude Opus 4.8 担任框架编辑。团队又做了一组“自己改自己”的实验:同一个模型同时负责执行和编辑,在 OpenCode、k=2 的设置下,从 GLM-5、Gemini 3.5 Flash 到 Opus 5,五款模型在三个基准上都获得了提升。
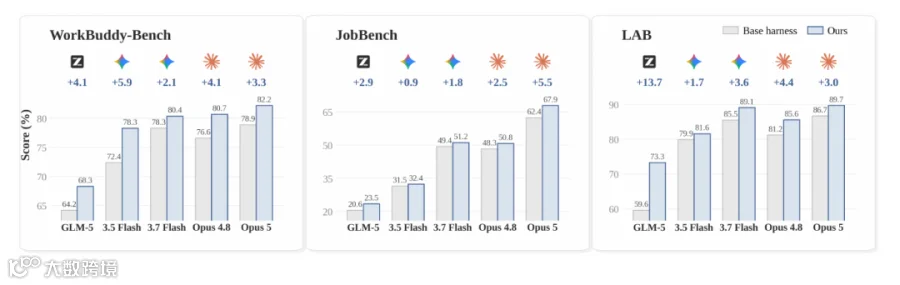
论文图8:同一模型兼任执行与编辑时的结果,OpenCode与k=2设置
开源仓库支持 OpenCode 和 Codex 执行器,提供三组基准的运行入口,也附有不需要模型凭据的小型演示。
参考链接
-
论文:Harness²: Recursive Agent Harnessing for an Open World:https://arxiv.org/abs/2610.14224v1 -
代码与演示:https://github.com/google-research/harness2