

一、背景/摘要
一、背景/摘要
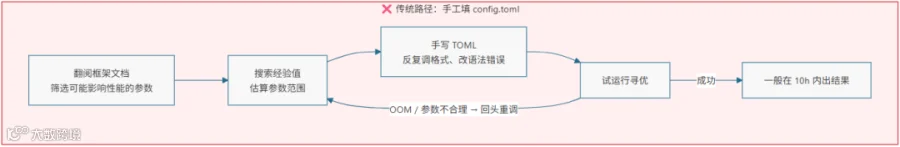
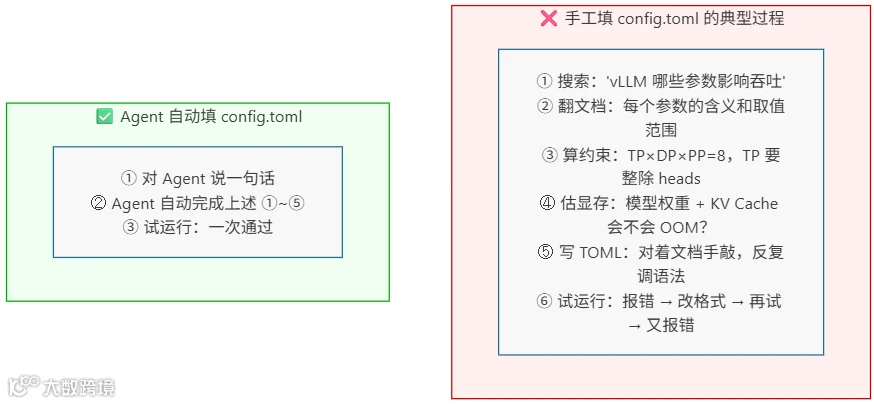
大模型推理服务部署后,性能调优始终是一道绕不开的坎。昇腾MindStudio工具链已支持的服务化实测寻优工具(MindStudio Modeling OptiX,下文简称OptiX)基于 PSO(Particle Swarm Optimization,粒子群优化)算法,能够自动搜索最优参数组合。但自动寻优本身仍有一道门槛:config.toml——启动寻优前用户必须手写一个完整的配置文件,定义搜索参数名、类型、范围、默认值,配置服务启动命令和压测工具参数。对新手而言,写这份 config.toml 的难度不亚于手动调参:
不知道调哪些参数:数十个参数中,哪些影响吞吐?哪些影响时延?哪些影响显存?没有清晰指引。
不知道范围怎么设:设宽了寻优收敛慢,设窄了错过最优解,设错了直接 OOM(Out Of Memory,显存溢出)。
手改 TOML 容易出错:TOML 的嵌套表头、数组语法、括号层级,少一个引号或缩进就报错,排查费时费力。
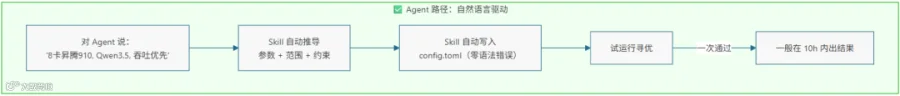
为此,昇腾MindStudio工具链把完整使用流程封装为两项AI Agent Skill,内置于MindStudio Agent 的Modeling SubAgent 模块内,同时也兼容 Claude Code 等支持 Skill 机制的主流 Agent,打通”安装部署 → 参数推荐与配置生成”全流程。原本需要用户手工查阅文档、计算范围、编辑 TOML 的过程,现在只需用自然语言描述业务需求,即可由 Agent 全自动完成。
下面的流程图直观对比了两种路径的差异:
二、核心原理与架构
2.1 OptiX 寻优工具简介
MindStudio 服务化实测寻优工具核心包括两大模块:
参数寻优模块:基于 PSO 粒子群算法,在参数搜索空间中不断生成候选参数组合,结合 Early Rejection 算法快速过滤明显不可行的组合,逐步逼近全局最优。
参数验证模块:自动拉起推理服务进程和压测工具(AISBench 或 vLLM_benchmark),对每组候选参数进行真机实测,获取吞吐、TTFT(Time To First Token,首 token 延迟)、TPOT(Time Per Output Token,逐 token 延迟)等性能指标。
整个寻优过程全自动运行,最终输出各组参数的性能对比结果,并在满足时延 SLO 的前提下推荐吞吐最优的参数组合。
2.2 两个 Skill 的定位与协作
MindStudio Agent 内置了下述两个 Skill,用户启动后即可通过自然语言直接调用,无需额外配置。当然,这两个 Skill 也兼容 Claude Code 等支持 Skill 机制的主流 Agent。
两个 Skill 的职责分工如下:

两者的协作流程如下:

以上整个协作流程均在 MindStudio Agent 中完成,用户只需在 MindStudio Agent 会话中用自然语言表达意图,Skill 自动串联执行。
三、实战案例:Qwen3.5 吞吐优化
下面以MindStudio Agent为例,演示两个 Skill 的完整使用流程。
场景设定:
硬件:8 卡Atlas 800I A3,单卡显存 64 GB
模型:Qwen3.5-7B
推理框架:vLLM Ascend
业务负载:平均输入 1024 token、最大输出 512 token
优化目标:在 TTFT ≤ 500ms、TPOT ≤ 50ms 的约束下最大化吞吐
3.1 前置:启动 MindStudio Agent
在终端中启动Modeling SubAgent:
msagent -a Modeling进入MindStudio Agent交互界面后,即可开始部署 OptiX。后续所有对话均在 MindStudio Agent 中进行。
3.2 第一步:安装部署(optix-deploy)
在 MindStudio Agent 中输入:
“帮我安装 MindStudio Modeling OptiX 工具”optix-deploy Skill 被激活,自动检查当前环境、克隆仓库(如需要)、执行可编辑安装、验证 CLI 可用。整个过程用户无需手动敲任何命令,Skill 执行完毕后直接汇报安装结果。
3.3 第二步:参数推荐(optix-param-recommend)
安装完成后,继续在 MindStudio Agent 中描述场景:
“我是8卡Atlas 800I A3,单卡 64G,跑Qwen3.5的 vLLM服务,业务平均输入1024 token、最大输出512 token,想优化吞吐,帮我推荐应该调哪些参数”optix-param-recommend Skill被激活。它按照内置流程收集上下文,构造 JSON 写入context文件,然后调用推荐脚本进行推理:

脚本内部的工作逻辑:
解析模型结构:读取 Qwen3.5 的 config.json,提取 num_attention_heads、num_key_value_heads、num_hidden_layers、intermediate_size、dtype等信息。
推导并行策略:8 卡场景下,world_size 的因子为 [1, 2, 4, 8]。结合 attention heads 数量,筛选出可行的 TP(Tensor Parallel)候选值。首次寻优 PP 默认为 1,DP 由 world_size / TP派生。
估算KV Cache容量:根据单卡显存、TP 分片、模型dtype 和业务最大token长度,估算单卡可容纳的KV Cache上限,据此推算MAX_NUM_SEQS和 MAX_NUM_BATCHED_TOKENS的安全范围。
MindStudio Agent 在对话中直接呈现推荐结果:

推荐结果输出后,optix-param-recommend默认需经用户确认后才会将推荐参数写入config.toml。配置完成后,一条命令启动寻优:
MindStudio Modeling optix -e vLLM -b vLLM_benchmark
寻优结束后,在result/store/目录下查看data_storage_*.csv,即可获得各组参数的性能对比和最优推荐。
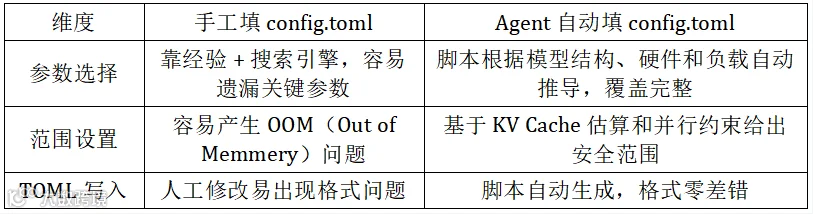
3.4 效果对比:手工填 config vs Agent 自动填
四、小结
MindStudio Agent已支持服务化实测寻优能力,将大模型推理服务参数寻优的门槛从”需要懂框架、懂硬件、懂TOML 语法”降低到了”能描述自己的硬件和业务”。
对于刚接触推理部署的新手,这是一条从零到启动寻优的最短路径;对于有经验的部署工程师,这也是一套能显著减少手工配置出错率的效率工具。
MindStudio Agent使用指南:
https://gitcode.com/Ascend/msagent
MindStudio Modeling代码仓:
https://gitcode.com/Ascend/msmodeling
服务化实测寻优使用指南:
https://gitcode.com/Ascend/msmodeling/blob/master/docs/zh/user_guide/msmodeling_optix_user_guide.md
扫描二维码,
一键直达MindStudio Modeling开源社区
扫描二维码,
快速体验MindStudio Agent
扫描二维码,
加入MindStudio社区交流群
