大数跨境

当25位菲尔兹奖得主对一家公司说不!

当25位菲尔兹奖得主对一家公司说不! 华夏幸福产业研究院
2026-10-23
4
导读:机器算出了答案,谁来为人类的思考买单?
机器算出了答案,谁来为人类的思考买单?

事情要从一则听起来有点儿荒诞以至于像科幻小说的公告说起。
2026年秋天,地表最强大的AI公司之一(对,又是OpenAI)宣布:他们动用一万个智能体,只用88小时,就“速通”了那道困扰数学界九十年的纳维-斯托克斯方程难题。
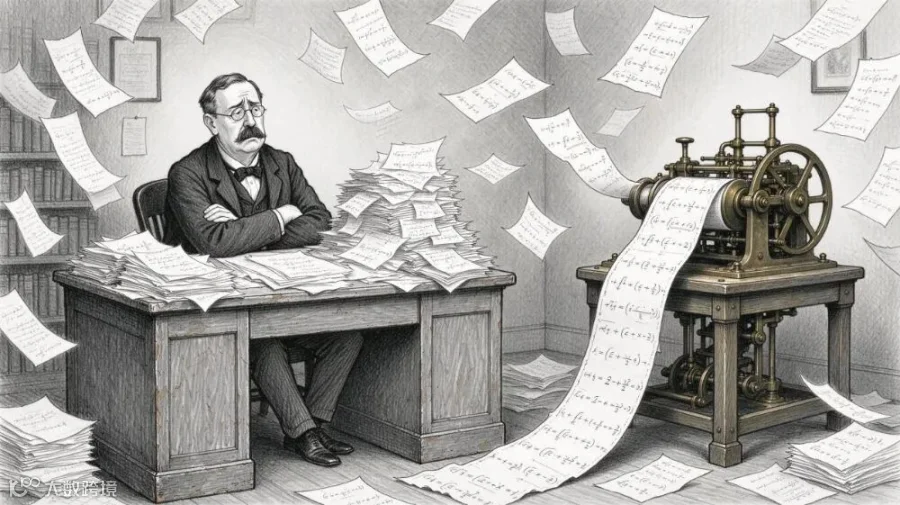
一台不知疲倦的机器正吐出人类几代都读不完的稿纸
这个消息立刻像一颗石子投进原本安静的数学池塘,而池塘的反应,比石子本身更耐人寻味:先是两位数学家发现,自己前一天刚发表的研究路线,和AI的“独立发现”几乎一模一样;接着,25位菲尔兹奖得主联名写了一封公开信,标题就叫《人工智能在数学中的严重错位》;再之后,人类数学协会(AHM)发表声明,几乎是指着那家公司的鼻子说:你这不是在做研究,你是在“展示权力”。
一个值得停下来想一想的细节是:数学家这个群体,通常是地球上最不爱写公开信的人。他们习惯用论文说话,用证明互相致敬,为了一个引理可以沉默十年。所以,能让二十多位站在人类智力金字塔尖的人放下手里的公式、集体署名抗议一家公司,这件事本身,就比那道千禧难题到底“是不是看上去被解决了”被更值得品读。
或许是巧合,几乎同一时刻,另一群人正在悄悄把机器人的时钟往回拨:原本预计要五年才会规模化进厂的人形机器人,因为“世界模型”和“VLA”的技术结合取得了明显进展,这一进程可能将提前两三年。
于是,在这个红叶渐染的季节,一边是最杰出的人类头脑在抗议,一边是具身智能在加速学会干活。这两件事的背后,都指向了同一个问题——当机器开始大规模吸收人类的智力与劳动,谁来记账,谁来付账?


数学家们怕的,不是被AI抢饭碗

我们必须先澄清一个可能的常见误会。
很多人看到这则新闻,第一反应是:哦,又一批老登学者恐慌了,就像当年他们反对计算器、反对计算机证明一样。这种给足情绪价值的解释很顺手,但它错了。数学界对AI的接受度其实高得很——形式化证明、定理搜索、符号计算、猜想生成,这些工具早就写进了数学研究的日常。陶哲轩本人就是最早一批把大模型当成研究助理的顶尖大脑,没有人反对“帮忙”。
那他们到底在生气什么?AHM声明里有一个词,叫“PowerShow”——力量秀、权力秀。意思是:你OpenAI发布那七百多份手稿,不是在跟同行交流,而是在向世界炫耀算力。把人类花了九十年没啃下来的难题,当成一道可以被打勾的KPI;把学术共同体几百年慢慢积累的信用,一次性换成自己公司的公关素材。
这里面有一个很隐蔽、却极不公平的经济账。
想象一下:一家公司拿走了图书馆里所有的藏书,关起门来训练了一台机器,然后这台机器源源不断地吐出书稿。公司上了头条,拿了融资,股价上涨;而那些写书的人,既没被咨询过,也没分到一分钱,反倒被要求义务审稿、义务挑错、义务证明“这堆东西里到底有没有真货”。换句话说——AI公司收获了“我们最聪明”的声誉,整个学界承担了“帮你擦屁股”的成本。陶哲轩管这叫“证明消化不良”:答案像潮水一样涌来,人类的胃却只有这么大。
还有一层,比钱更深也更重要。联名信里打了个比方:把学生直接空投到珠穆朗玛峰顶,和让他自己一步一步爬上去,完全是两回事。数学训练的价值,从来不只是“拿到答案”,而是那个走弯路、犯错、推倒重来的过程——正是这个过程,塑造了一个数学家的判断力、品味和提出新问题的能力。如果AI总是直接把终点塞到人类手里,学生得到的是结果,失去的却是能力。
这个担忧一点都不狭隘。它悄悄延伸到了所有人头上:当写作、画画、写代码、看病历、写诉状都有了“一键生成”,人类还愿不愿意、还需不需要练习基本功?当工作退化成“审核AI的输出”,我们是不是已经忘了,工作最初是为了什么?


“白嫖”这件事,不只数学家遇到了

如果你把这件事讲给一位画师听,他大概会苦笑。
过去两年,画师群体经历过几乎一模一样的剧本:把自己的画发在网上,本来是给人欣赏、接稿、攒口碑;结果这些画被悄无声息地爬走,喂给了绘图模型。模型学会了画风,开始批量出图,反过来挤压画师的接单空间。数学家的抱怨结构,和画师几乎是一个模子里刻出来的——先用我的东西训练,再拿模型替代我。
并且,“白嫖”这件事,不只某一家AI公司在做,在座的诸位,无论公司大小,都有份(请原谅我不能写出那个你懂的梗),或多或少而已。
当然,这里必须停一下,有些细节问题不能一概而论。
在法律上,数学家和画师的处境并不完全相同。著作权保护的是“表达”,不保护“思想”。一幅画的具体笔触、构图、配色,是受保护的表达;而一个数学定理、一条证明思路,属于人人都可以学习的公共知识——这正是科学能一代代接力的原因。人类数学家读论文、吸收思想、再往前推一步,天经地义;说AI读论文等于偷窃,在法律上很难站得住脚。所以更准确的说法,不是“盗窃”,而是一种价值贡献与收益分配的不对称:几代人的智力积累被一次性吸收进商业模型,公司拿去变现,原作者既没有选择权,也没有分红,甚至还要反过来替模型纠错。
这件事的尴尬之处在于:公开,本来是学术共同体的美德。论文挂在arXiv上,预印本免费开放,是为了让同行尽早看到、尽早引用、尽早碰撞。没人写论文时想的是“这是我将来要授权给某公司训练用的资产”。可一旦“公开可读”被默认等同于“可免费商用训练”,开放科学这条传统美德,就被商业世界悄悄改写了条款。
联名信还揭破了一个新冲突角色:AI公司不再只是“工具提供商”,它成了学术共同体里一个特殊的、权力不对等的参与者。它可以和你谈合作,也可以绕过你直接发布;它既当运动员(产出证明),又当裁判员(宣布自己独立发现),还顺手拿走了观众的掌声。而数学家手里唯一的筹码,是多年攒下的学术声誉——和一封公开信。
当答案可以被批量生产,稀缺的反而成了“读得懂”。


机器人的闹钟,为什么被往前拨了三年

如果说数学家的抗议是“软件”层面的雷声,那么另一头,“硬件”世界正在开始下雨。
聊机器人之前,我们得再次先破除一个对演示视频的迷信。你在网上看到的机器人后空翻、跳箱子、端咖啡,大多是精心剪辑的“高光时刻”。真实工厂里的机器人,最大的痛点并不是“酷不酷”,而是“稳不稳”——一把抓下去,差一毫米,杯子倒了;环境稍微变一点,它就懵了;任务超过三步,误差像滚雪球一样累积。在业内,管这叫“长时序误差累积”。
2026年的突破,瞄准的正是这个软肋。两项技术合在了一起:一个叫VLA(视觉—语言—动作模型),相当于给机器人装上了“听得懂人话、看得懂东西”的眼睛和耳朵;另一个叫“世界模型”,相当于给机器人装了一个“脑内模拟器”。以前的机器人是“反应式”的——看到什么做什么,走一步算一步;世界模型取得显著进步之后,它可以先在脑子里把动作预演一遍:推这个箱子会倒吗?抓这个杯子用力过猛会碎吗?门口有人走过要不要停?
这就从“条件反射”升级成了“三思而后行”。宇树的UnifoLM、阿里达摩院的WorldVLA、极佳视界的行为世界模型、谷歌DeepMind的GeminiRobotics2,走的都是这条路:动作拆成毫秒级的Token、能提前预测下一步会发生什么、还能发现自己“预料和实际不符”并当场纠正。
正因此,原本预计要五年才会发生的事——仓储分拣、上下料、质检、清洁巡检、后厨备餐——时间表被压到了两三年。
当然,也先别急于恐慌。这件事,有两个让你先冷静冷静的注脚。
第一,技术进步降低的是“开发成本”,不是“硬件成本”。人形机器人身上的减速器、力矩传感器、电池,这些金属零件的价格不会因为模型变强就magically跌下来。模型再聪明,本体太贵,使用的账就不划算。所以两三年内批量上岗的,或许是那些任务极重复、昼夜不停、人力又贵又危险的场景——工厂里的一条流水线,仓库里的一个工位,而不是你家客厅。
第二,“任务被重组”不等于“所有人失业”。更可能发生的是:一个岗位里,重复的部分被机器拿走,剩下需要判断、审核键决策、共情、处理意外的部分留给人。入门级岗位变薄了,职业阶梯的第一级被抽掉,这对刚毕业的年轻人冲击最大;而护理、维护、跟人打交道的活儿,还需要时间。
换句话说,这不是机器人某事某刻就把工人全赶走的恐怖片,而是一个慢火收汁的过程:炉火开得比预想大了,但锅还在灶上。


先别急着喊“AI税”,要先搞清楚税的是什么

气氛烘托到这儿,业界很多人又一次顺理成章地得出一个结论:那就对这些AI巨头征税吧,拿这笔钱补偿被白嫖的数学家和艺术家,再给将来被机器人顶替的工人发UBI(全民基本收入)。逻辑听起来无懈可击。
但政策的选择从来没有如此简单明了到令人觉得幸福的时候,真正头疼的,恰恰是这个“听起来对”。
先说一个常被混淆的概念:“算力霸权”。它并不是骂人的话,而是一种市场结构——少数几家公司同时攥着最先进的芯片、最强大的数据中心、最关键的模型权重和分发渠道。当这些瓶颈叠在一起,AI巨头赚的就不再是“辛苦干活的钱”,而是经济学里说的“租金”:因为卡住了位置而躺着收的钱。这就像一个小镇唯一的桥头堡,不管谁过桥,都得留下买路钱——修桥的辛苦早就收回本了,后来收的每一笔,都是位置带来的。
在经济学的世界,习惯把AI的超额利润拆成四种,性质并不相同:
一是创新租金——我技术领先,暂时多赚一点。这是市场对创新的奖励,太早重税等于扼杀进步,不该动。
二是垄断租金——靠市场支配地位、生态锁定、芯片瓶颈持续收钱。这是真正该调节的。
三是数据与知识租金——因为无偿用了你的论文、我的画、他的代码,才省下来的成本。这是补偿创作者的重点。
四是劳动替代外部性租金——机器替了工人,省下的工资揣进自己腰包,却把失业、培训、社保这些成本甩给了社会。这是过渡保障的重点。
看出来了吗?这四种钱,该由四种不同的机制来处理,根本不该用同一把“大锤”砸下去。
那大家最顺口的两种税,为什么不好使?
“算力税”——按烧了多少电、跑了多少GPU来收。问题在于,你税的是“投入”,不是“赚的钱”。一个真正在做前沿探索、可能血本无归的小团队,和一个靠垄断躺赚的巨头,烧同样多的算力,凭什么交一样的税?这等于打击研发,而且账单最后大概率转嫁给普通用户。
“机器人税”——给每台上岗的机器收一笔钱(或者社保)。听起来最解气,操作上却处处是坑:软件自动化算不算机器人?替代一个“岗位”还是一个“任务”?怎么测量?更别扭的是,你一边用政策鼓励制造业升级、一边对工厂买机器人征税,等于自己跟自己打架。历史上给挖掘机、给计算机征税的提议,从来没真正落地过——因为问题从来不在工具,而在工具创造的财富怎么分。
更稳妥的思路,可能是把“征税”改成一套组合拳:对AI业务里“超过正常水平的那部分利润”征收附加税(而不是对算力本身征税),配上向创作者收的“数据集体许可费”,再配上企业为替代人工缴纳的“转型过渡基金”。税率要累进,给研发、开源、中小企业留足豁免,还要靠国际协议防止公司把利润挪去低税率国家。一句话:抓租不抓本,抓大不放小,抓持久不抓临时。


收上来的钱,该往哪儿花?

钱收上来,怎么花,比怎么收还容易吵架。目前看,大致可以分成三层。
最贴近地面的一层:定向补偿。给那些被AI白用了作品的画家、作家、摄影师、导演演员等等创作人群发放集体许可费。例如,给被七百份手稿砸中的数学家设立一笔“验证基金”——毕竟帮AI挑错、复现、同行评议,是高智商的苦役,凭什么免费?相对应的,给被机器人顶下来的工人发再培训券、工资保险和过渡期收入。这一层,是“谁被征用,补谁”。
中间一层:社会转移支付。把一部分AI租金,以公共服务的形式还给全体公众。它不需要审查你的动机,也不附带“你必须去找工作”的条件——因为AI本来就是站在全人类公共知识的肩膀上,它赚的钱,理应有一份属于公众。
最长远的一层:UBI的“基础设施”。这是最容易被误解的地方。UBI(全民基本收入)听起来像“不管上不上班,人人都发钱”,浪漫又昂贵。连英国工会NIPSA这样最该欢迎它的组织,都在要求先把UBI的全部成本和风险算清楚再谈。所以短期内,真正该做的,并不是直接撒钱,而是先把“管道”铺好:每个人的电子账户、税务和福利数据打通、自动发放的系统、小范围试点。等哪天真的需要大规模启用,不会临时抱佛脚。
这三层里,藏着一个常被忽略的财政闭环:AI替代工人→公司省下工资、产生超额利润→政府从中抽一部分租金→发给被替代者维持消费→消费撑住总需求→总需求反过来又创造新的就业。这个闭环一旦断开,就是经济学家最担心的剧本:钱都集中到少数人手里,多数人没钱消费,连带着连工作岗位都没了。


最后,给两边都泼点冷水

写到这儿,我得赶紧给这种“设计一套完美制度”的快感降降温。因为这件事最迷人也最危险的地方,就是它特别容易走向两种浪漫。
一种浪漫,是把AI当成十恶不赦的小偷。这不对。AI帮数学家搜反例、生成猜想、检查逻辑,是实打实提升了生产力的;学习前人的知识,本就是科学进步的方式,不是原罪。问题不是“机器参与了”,而是“参与之后,权、责、利怎么分”。曾几何时,四色定理的计算机证明刚出来时,也被老派数学家骂成“不是真正的证明”;但它最终拓展了数学的边界。我们真正要警惕的,不是机器给出了证明,而是一个连作者自己都读不懂、却要求全人类替它验账的证明。
另一种浪漫,是把这场危机渲染成“末日倒计时”。也不对。两三年大规模替代,是一个情景,不是预言。如果机器人的安全性认证、硬件成本下降慢于预期,这把火就烧得没那么快;反过来,如果世界模型再次突破,时间表可能还会再提前。正是因为不确定,最聪明的做法不是现在就征一笔重税、把企业一棍子打死,而是搭一套“可扩展、可暂停、可随时调整”的制度——先低税率起步,先小范围试点,用试点数据说话。
为了避免极端化情绪化,还有三个“不能简化”,值得记住:
其一,不能把一切都叫“AI白嫖”。公共知识、受版权保护的作品、个人数据、商业秘密、帮AI纠错的验证劳动,法律地位天差地别。一刀切,既会冤枉正常的学术学习,也保护不了真正该补偿的人。
其二,不能把答案简化成“开征算力税”。税的是租金,不是技术本身;否则打掉的可能是真正的创新者。
其三,不能把未来简化成“靠UBI养懒人”。UBI是远方的方向,不是眼下的药方;眼下最该做的,是给转型中的人兜底。


尾声:技术是季度的,制度是十年的

回到那个最初的画面:25位菲尔兹奖得主放下笔,联名写了一封几乎从不写的公开信。
他们真正在警告的,与其说是AI太强,不如说是我们给AI立规矩的速度,远远跟不上它变强的速度。技术的迭代是按季度算的:这个月模型还不会,下个月就“速通”了九十年难题;而税收立法、福利制度、国际协议,是按十年算的。等大规模替代真的发生了,再慌慌张张去补税、去建保障网,人类社会只会同时吞下失业、财政缺口和政治对立三颗苦果。
所以最稳妥的姿态,不是现在就对谁喊打喊杀,而是赶紧把“前期工作”做起来:把税基算清楚,把法律授权谈下来,把创作者的补偿试点跑起来,把UBI那根水管先埋进地下。这不是在跟技术进步作对,恰恰相反——只有当人们相信AI赚到的钱会被公平地分回来,这场技术革命才不会同时变成一场社会撕裂。
九十年前那道纳维-斯托克斯方程,描述的是流体怎么在混沌中保持秩序。有点讽刺的是,今天我们自己正站在一股名为AI的洪流里,手忙脚乱地,想为它修一道不至于决堤的堤。
机器已经算出了答案。接下来该问的是:这个答案,人类,准备好怎么结账了吗?
写给每一个都将被这场技术浪潮重新定价的普通人

END

| 往期推荐:

当OpenClaw 2.0热度不再,我们需要怎样的AI

2026-09-04

AI当道,地段不再是铁律?不动产投资逻辑正在革新

2026-07-29

效率、心域与空间革命——AI赋能“一人公司”(OPC)展望

2026-03-24


【声明】内容源于网络
0
0
华夏幸福产业研究院
华夏幸福产业研究院
内容 817
粉丝 0
华夏幸福产业研究院 华夏幸福产业研究院
总阅读6.2k
粉丝0
内容817