


10 个关键问题 Q&A
-
Q:M3.1-Flash 是什么模型? A:MiniMax 发布的原生多模态 MoE 开源模型,主打 Agent、代码、电脑操作、网安。 -
Q:428B 参数是不是每次都全量激活? A:不是,每次 token 只激活 23B,MoE 稀疏激活,降低推理成本。 -
Q:支持哪些输入?上下文多大? A:文本、图片、视频都能输,最大上下文窗口 100 万 token。 -
Q:对比老版 M3 主要改了什么? A:全域稀疏注意力、量化感知训练、DSpark 推测解码三大改动。 -
Q:和 DeepSeek V4.1 Flash 比谁更强? A:代码略弱,Agent、网安、长上下文是 M3.1-Flash 优势。 -
Q:对比 Kimi K3、GLM-5.3 水平如何? A:智能体、工具调用、代码、OSWorld 跑分普遍领先。 -
Q:本地能用什么框架部署? A:优先 SGLang、vLLM、TokenSpeed;多卡集群用 FlagOS。 -
Q:DSpark 推测解码有什么用? A:替代旧版 MTP,加速生成,降低推理时延,需要框架适配。 -
Q:普通家用显卡能不能跑? A:门槛很高,不适合消费级显卡,面向企业 GPU 集群。 -
Q:量化版本跑分和官方原版一样吗? A:不一样,第三方量化后指标会下降,官方结果仅原版权重有效。
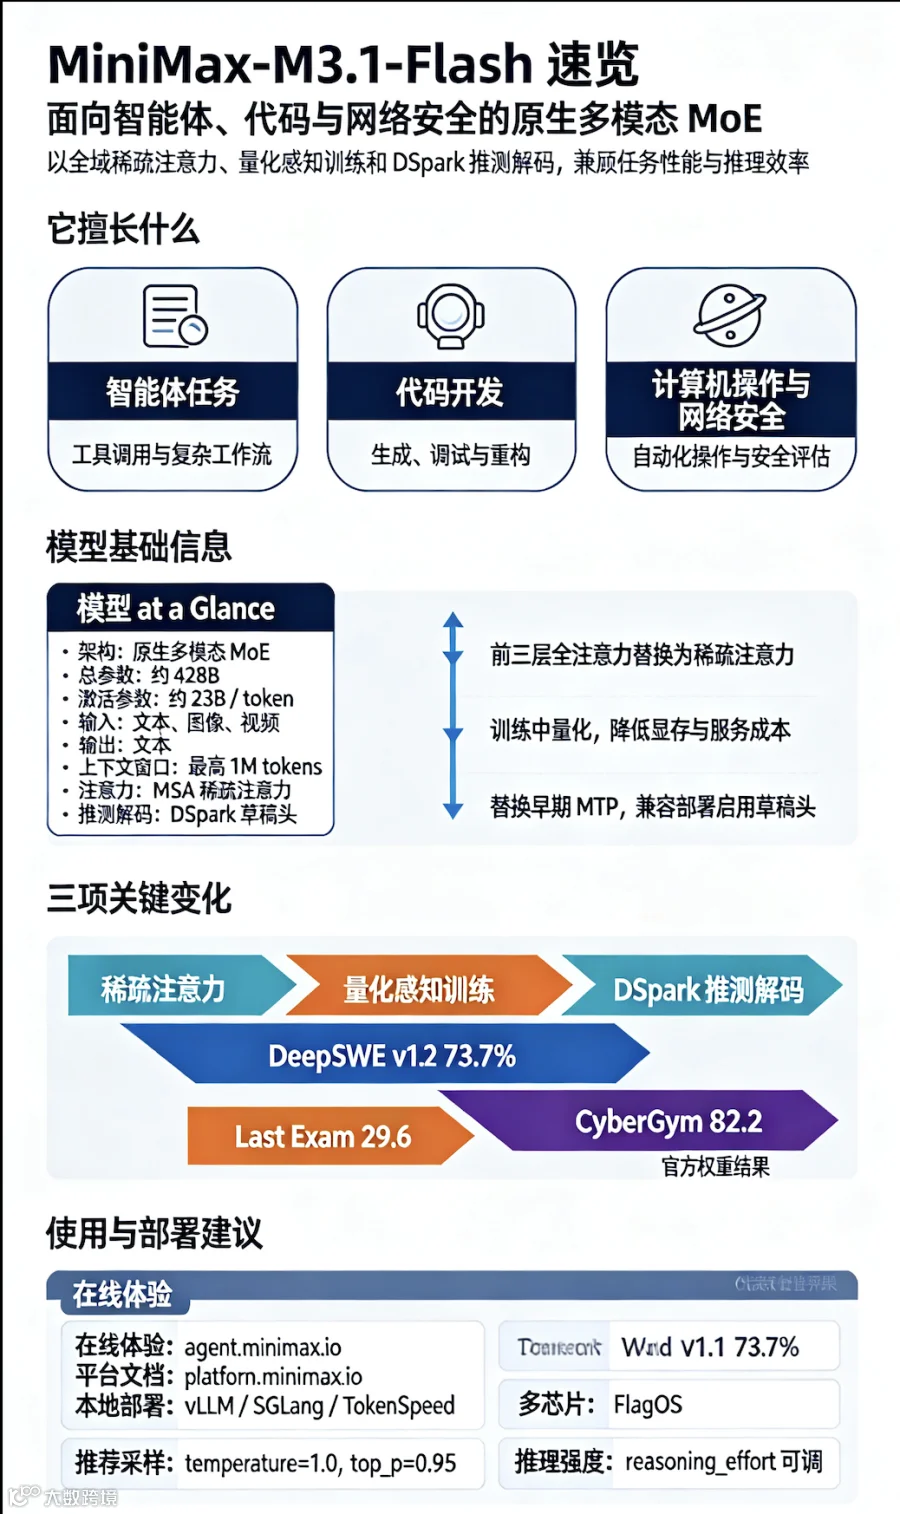
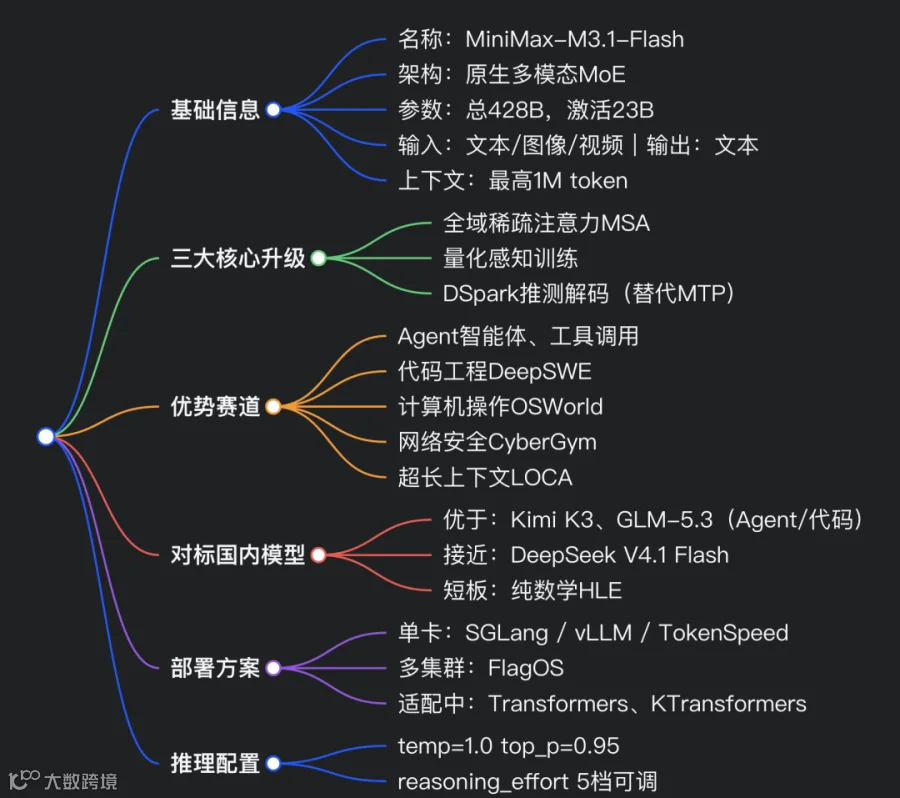
MiniMax-M3.1-Flash 是一款原生多模态混合专家模型,面向代码开发、智能体工作流、计算机操作与网络安全场景。支持文本、图像、视频输入,上下文窗口最高可达 100 万 token。
该模型在 MiniMax-M3 的基础上迭代升级,依托全域稀疏注意力、量化感知训练、DSpark 推测解码三大技术,提升任务能力与推理效率。
亮点
- 智能体能力突出
在智能体任务、代码、网络安全领域实现代际提升:BankerToolBench 76.2 分、DeepSWE v1.1 73.7%、OSWorld V2 61.7 分、Agents' Last Exam 29.6 分、CyberGym 82.2 分。 - 原生高效设计
全域稀疏注意力、量化感知训练搭配 DSpark 推测解码,大幅优化推理吞吐。
模型概览
- 架构
原生多模态混合专家(MoE) - 参数量
总参数量约 4280 亿;每个 token 激活 230 亿参数 - 输入输出
支持文本、图像、视频输入;输出文本 - 上下文窗口
最高 100 万 token - 注意力机制
全文采用 MSA 稀疏注意力(参考论文:https://arxiv.org/abs/2606.13392) - 推测解码
内置 DSpark 草稿头
评测基准
|
|
|
|
|
|
|
|
|
|---|---|---|---|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
评测说明:以上结果为官方权重跑分;第三方量化版本跑分可能存在差异。
M3.1-Flash 更新要点
M3.1-Flash 保留了 M3 核心混合专家架构,主要有三处改动:
- 全域稀疏注意力
前三层全注意力层替换为稀疏注意力; - 量化感知训练
路由 MoE 专家与注意力通路在训练阶段即做量化,降低显存占用,提升服务部署效率; - DSpark 推测解码
使用 DSpark 替代原先类似 EAGLE 的 MTP 方案;本次发布配套草稿头,可在兼容的推理服务框架中启用。
使用方式
在线体验入口: https://agent.minimax.io/ https://platform.minimax.io/
本地部署
下载模型命令:
hf download MiniMaxAI/MiniMax-M3.1-Flash --local-dir MiniMax-M3.1-Flash
推荐推理框架:
-
SGLang:参考文档 https://docs.sglang.io/cookbook/autoregressive/MiniMax/MiniMax-M3.1 -
vLLM:参考文档 https://recipes.vllm.ai/MiniMaxAI/MiniMax-M3.1-Flash -
TokenSpeed:参考文档 https://lightseek.org/tokenspeed/recipes/models#minimax-m3-1
其他适配正在开发中:Transformers、KTransformers、Unsloth、ATOM。
多卡集群部署
基于 FlagOS 方案:https://github.com/flagos-ai 详情见模型仓库文档:FlagOS-Multi-Chip-Support-and-Downloads.md
推理参数配置建议
推荐采样参数:temperature=1.0,top_p=0.95推理能力可调:在对话模板中设置 reasoning_effort,可选等级:low(低)、medium(中)、high(高)、xhigh(超高)、max(最高)
模型最大支持 100 万 token 上下文。实际可用上下文长度与吞吐取决于显卡显存和服务配置。
联系我们
邮箱:model@minimax.io
附带链接清单
https://huggingface.co/MiniMaxAI/MiniMax-M3.1-Flash https://huggingface.co/MiniMaxAI/MiniMax-M3.1-Flash/tree/mainhttps://huggingface.co/MiniMaxAI/MiniMax-M3.1-Flash/discussionshttps://huggingface.co/MiniMaxAI/MiniMax-M3.1-Flash?library=transformershttps://huggingface.co/MiniMaxAI/MiniMax-M3.1-Flash/colabhttps://huggingface.co/MiniMaxAI/MiniMax-M3.1-Flash/kagglehttps://huggingface.co/settings/local-appshttps://huggingface.co/MiniMaxAI/MiniMax-M3.1-Flash?local-app=vllmhttps://huggingface.co/MiniMaxAI/MiniMax-M3.1-Flash?local-app=sglanghttps://huggingface.co/MiniMaxAI/MiniMax-M3.1-Flash?local-app=docker-model-runnerhttps://huggingface.co/models?other=base_model:quantized:MiniMaxAI/MiniMax-M3.1-Flashhttps://huggingface.co/MiniMaxAI/MiniMax-M3.1-Flash#model-at-a-glancehttps://huggingface.co/MiniMaxAI/MiniMax-M3.1-Flash#benchmarkshttps://huggingface.co/MiniMaxAI/MiniMax-M3.1-Flash#whats-new-in-m31-flashhttps://huggingface.co/MiniMaxAI/MiniMax-M3.1-Flash#how-to-usehttps://huggingface.co/MiniMaxAI/MiniMax-M3.1-Flash#local-deploymenthttps://huggingface.co/MiniMaxAI/MiniMax-M3.1-Flash#multi-chip-deploymenthttps://huggingface.co/MiniMaxAI/MiniMax-M3.1-Flash#inference-settingshttps://huggingface.co/MiniMaxAI/MiniMax-M3.1-Flash#contact-ushttps://agent.minimax.io/https://platform.minimax.io/docs/guides/text-generation https://www.minimax.io/https://modelscope.cn/organization/minimax https://platform.minimaxi.com/docs/faq/contact-ushttps://discord.com/invite/DPC4AHFCBwhttps://huggingface.co/MiniMaxAIhttps://github.com/MiniMax-AIhttps://arxiv.org/abs/2606.13392