

10 个关键问题 Q&A
-
Q:Harness² 的 harness 指什么? A:包裹大模型、支撑智能体运行的整套外围系统,包含提示词、工具、记忆、编排等,不包含模型权重。 -
Q:Harness² 最大特点是什么? A:固定模型参数,用双层递归自动优化智能体适配层,适配开放世界里从未见过的新任务。 -
Q:什么是 Propose–Probe–Compose? A:任务层递归核心流程:提出适配修改方案、在任务上探测效果、基于行为对比整合出更优适配策略,不需要标准答案。 -
Q:任务层递归和适配层递归区别? A:任务层针对单任务即时优化;适配层长期沉淀经验和适配方案,用于后续任务优化。 -
Q:并行递归和串行递归怎么选? A:并行适合广泛探索多个候选方案;串行适合在一条路线上持续深度迭代优化。 -
Q:Harness² 有哪 8 个可配置组件? A:系统提示词、安全约束、记忆、工具指引、子智能体、技能、脚本、插件。 -
Q:配套三个基准分别对应什么场景? A:JobBench 专业职场任务、LAB 法律任务、WorkBuddy-Bench 覆盖办公、网页、代码任务。 -
Q:实验上取得了什么样的提升? A:GLM-5、Gemini 3.5 Flash 在各基准上涨分,最高在 LAB 提升 11.8 个百分点。 -
Q:本地 Demo 是否需要模型密钥? A:不需要,Demo 使用确定性编辑器与真实 Python 执行,可直接跑通两种递归模式。 -
Q:Harness² 可以断点续跑吗? A:可以,重复执行相同命令即可续跑;更换模型 / 任务集时需要更换运行目录。

仓库导航页 https://github.com/google-research/harness2# https://github.com/google-research/harness2#https://github.com/google-research/harness2# https://github.com/google-research/harness2/blob/main/assets/Harness2-wordmark.png
面向开放世界的递归智能体适配
论文:https://arxiv.org/pdf/2610.14224 |项目主页:https://harness2.github.io/ 基准文档:https://github.com/google-research/harness2/blob/main/docs/BENCHMARKS.md |许可协议:https://github.com/google-research/harness2/blob/main/LICENSE JobBench 介绍:https://github.com/google-research/harness2/blob/main/docs/BENCHMARKS.md#jobbench
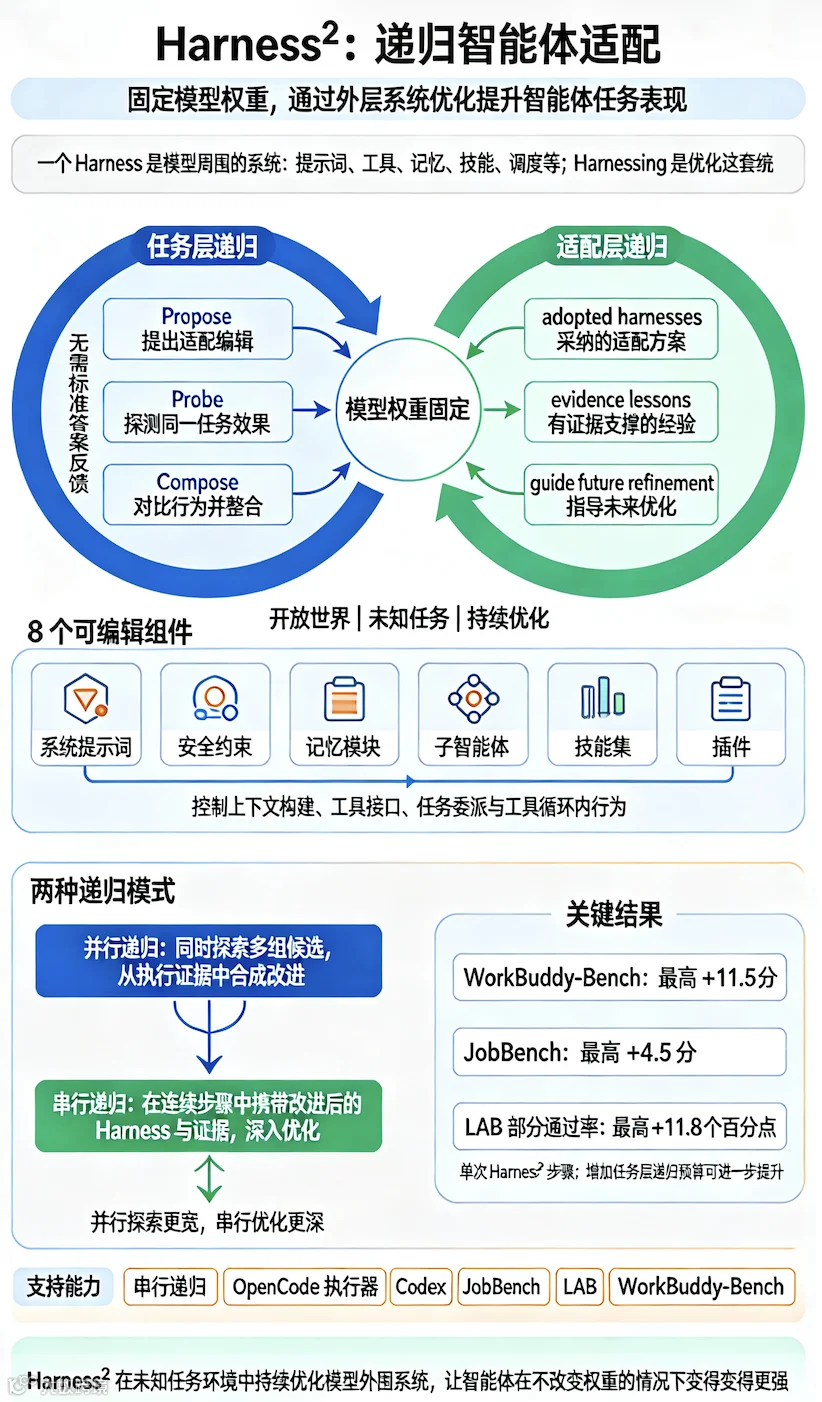
适配层(harness)是包裹在大模型外围、使其能够作为智能体执行任务的整套系统:包含提示词、工具、记忆、技能、调度编排等组件。 适配优化(harnessing)就是对这套外围系统做调优迭代的过程。
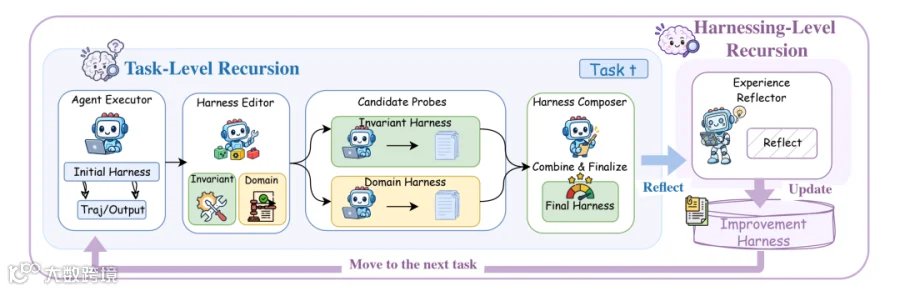
Harness²是一套开箱即用的框架,用于在开放世界中做递归式智能体适配优化—— 智能体在运行时会遇到适配方案设计阶段从未见过的全新任务。该框架在固定模型权重不变的前提下,搭建两层递归循环:
- 任务层递归
通过一套「提出方案–探测验证–整合优化」(Propose–Probe–Compose)的对比流程,为当前任务迭代优化执行适配层:生成适配修改方案,在同一个任务上探测改动带来的效果差异,再基于多次执行的行为对比,整合出更优的适配方案,全程不需要标准答案作为反馈。 - 适配层递归
把每个任务上最终落地的适配方案、以及有执行证据支撑的经验沉淀到一个持久化的优化适配器中,用来指导后续任务的适配迭代。
配图:https://github.com/google-research/harness2/blob/main/assets/harness2_pipeline.png
研究在三套专业基准测试、四种【模型 - 适配层】组合下开展实验:仅单次 Harness² 迭代,就能让 GLM-5、Gemini 3.5 Flash 的效果超越原始基线适配方案:
-
WorkBuddy-Bench 最高提升 11.5 分 -
JobBench 最高提升 4.5 分 -
LAB 基准的部分通过率提升 11.8 个百分点
增加任务层递归的计算预算,指标还能继续上涨。
当前开源版本支持:并行递归、串行递归两种模式,OpenCode / Codex 两种代码执行器,以及 JobBench、LAB、WorkBuddy-Bench 三大基准。
视频介绍:https://github.com/google-research/harness2#video-overview 视频文件:harness2-video.mp4
目录
https://github.com/google-research/harness2#contents
-
视频介绍 -
适配层组件 -
安装部署 -
运行基准测试 -
实验配置说明 -
网络访问说明 -
结果持久化与断点续跑 -
引用文献 -
贡献指南 -
许可协议 -
免责声明
适配层组件
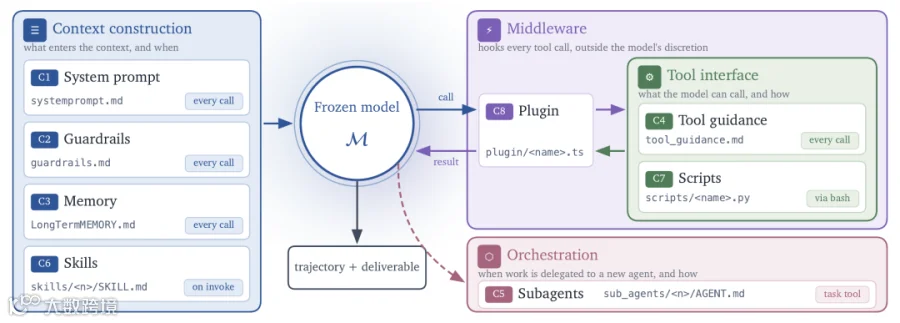
https://github.com/google-research/harness2#harness-components Harness² 在模型外围暴露了 8 个可编辑配置组件:系统提示词、安全约束、记忆模块、工具指引、子智能体、技能集、脚本、插件。这些组件共同控制上下文构建、工具交互接口、任务委派,以及工具调用循环内的智能体行为。 配图:https://github.com/google-research/harness2/blob/main/assets/components.png
安装部署
https://github.com/google-research/harness2#install 环境要求:Linux、Python 3.12、uv(https://docs.astral.sh/uv/getting-started/installation/) 在仓库根目录执行:
uv venv --python 3.12 .venv
source .venv/bin/activate
uv pip install -e '.[render]'
harness2-demo --output runs/demo --k 2
本地演示会同时运行两种递归模式,使用确定性编辑器 + 真实 Python 执行环境,不需要模型密钥。
如果要跑基于大模型的基准评测,额外需要:Node.js 20+、谷歌云 CLI;LAB 基准依赖 Pandoc、Poppler;WorkBuddy-Bench 需要 Docker。随后配置模型凭证:
cp .env.example .env
# 在 .env 文件中填写 Vertex AI 项目信息与模型ID
gcloud auth application-default login
模型参数、其他鉴权方式、Codex 执行器配置详见:https://github.com/google-research/harness2/blob/main/docs/SETUP.md
运行基准测试
https://github.com/google-research/harness2#run-a-benchmark 下面示例为 LAB 基准,安装环境、运行单个任务、自动打分并输出报告。调用模型会产生 API 费用,建议先用少量任务测试:
harness2-setup lab
harness2-check --bench lab
harness2 --bench lab --k 1 --mode parallel \
  --only-domains antitrust-competition --max-tasks 1
harness2-judge --bench lab --k 1 --mode parallel
harness2-report --bench lab --k 1 --mode parallel
串行递归只需要把 --mode parallel改为 --mode sequential。 --k代表任务层递归预算;打分、生成报告命令,必须和优化运行阶段保持一致:基准、执行器、任务子集、--k、递归模式、随机种子完全相同。 在 harness2命令加上 --dry-run,可以预览选中任务,不会调用模型。
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
单条命令一次只能选定一个基准。WorkBuddy 支持额外子集参数:--subset office/ --subset web/ --subset code,setup 之后的所有命令都可以带上。 各基准的数据集、任务领域、评分规则详见 BENCHMARKS.md。
实验配置说明
https://github.com/google-research/harness2#experiments 任务层递归有两种扩容方式:
- 并行递归
:同时探索多组候选适配方案,基于执行证据整合得到优化版本;探索广度更大 - 串行递归
:把上一轮优化后的适配方案、积累的经验带入下一轮「提出–探测–整合」,持续迭代;优化深度更深
配图:https://github.com/google-research/harness2/blob/main/assets/harness2_recursion_modes.png
|
|
|
|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
每个任务跑完之后,适配层递归会保留最终采用的适配方案、以及有证据支撑的经验,用于指导后续任务优化。 任务筛选、并发、可复现性、基线对比见 EXPERIMENTS.md。
网络访问说明
https://github.com/google-research/harness2#web-access 执行器默认不限制网络访问,Codex 模式下沙箱防护是关闭状态。部分公开评测评分标准可在线访问。正式评测前,请按 EXPERIMENTS.md#web-access 配置访问限制,防止智能体直接搜到标准答案与评分细则。
结果持久化与断点续跑
https://github.com/google-research/harness2#results-and-resume 所有运行结果保存在 runs/目录,按基准、任务子集分类存放,包含任务摘要、交付产物、最终适配方案、反思记录、评测得分。
重复执行完全相同的命令即可断点续跑。如果更换模型或者更换任务集,请设置全新的 HARNESS2_RUNS_DIR。 详情见 EXPERIMENTS.md#results-and-resume;所有子命令都支持 --help查看帮助。
引用文献
@article{xu2026harness2,
  title   = {Harness$^2$: Recursive Agent Harnessing for an Open World},
  author  = {Xu, Ruiyao and Chen, Yanfei and CuiZhu, Zhongying and Dalvi Mishra, Bhavana and Ming, Yifei and Yu, Han and Han, Rujun and Lee, Chen-Yu and Pfister, Tomas},
  journal = {arXiv preprint arXiv:2610.14224},
  year    = {2026},
  url     = {https://arxiv.org/abs/2610.14224}
}
贡献指南
https://github.com/google-research/harness2#contributing 详见 CONTRIBUTING.md
许可协议
https://github.com/google-research/harness2#license Harness² 主项目采用对应开源协议。第三方代码、基准数据集各自保留上游许可,详见 third_party/README.md、dependencies/README.md
免责声明
https://github.com/google-research/harness2#disclaimer 本项目不属于谷歌官方正式支持产品,不在谷歌漏洞赏金计划(bughunters.google.com)范围内。
术语对照表
-
Harness:适配层 / 智能体运行外壳(不改动模型权重,管控提示词、工具、调度的外层系统) -
Harnessing:适配优化、外壳调优 -
Recursive Agent Harnessing:递归式智能体外壳调优 -
Propose–Probe–Compose:提出方案–探测验证–整合优化 -
Task-level recursion:任务层递归 -
Harnessing-level recursion:适配层递归 -
Parallel recursion:并行递归(广探索) -
Sequential recursion:串行递归(深迭代) -
Substrate:底层执行后端(OpenCode / Codex)