


这篇分享围绕机器人学习领域一篇较新的工作展开——GROOVE(Geometry-Guided Reduction of Operational-Space Jerk in VLA Execution,几何引导的 VLA 执行操作空间加加速度抑制)。它关注的是一个常被“任务成功率”掩盖的问题:视觉-语言-动作(VLA)模型在真实机械臂上执行时,动作分块带来的抖动与冲击。作者提出了一种不重训、不加额外推理的在线监管机制,并在 LIBERO 仿真与 UR5e 实物上取得了目前对比方法中最大的加加速度降幅。
以下从问题由来、方法设计、实验严谨性与结果价值四个方面,梳理这篇文章为何值得关注,以及它对具身智能从实验室走向真实产线意味着什么。
问题的起点
01
动作分块带来的“隐性抖动”
VLA 策略通过“一次查询、多步动作”的动作分块(action chunking)来降低推理成本、增强时序连贯性。分块让策略不必每个控制步都调用一次模型,这是它近两年被广泛采用的原因。
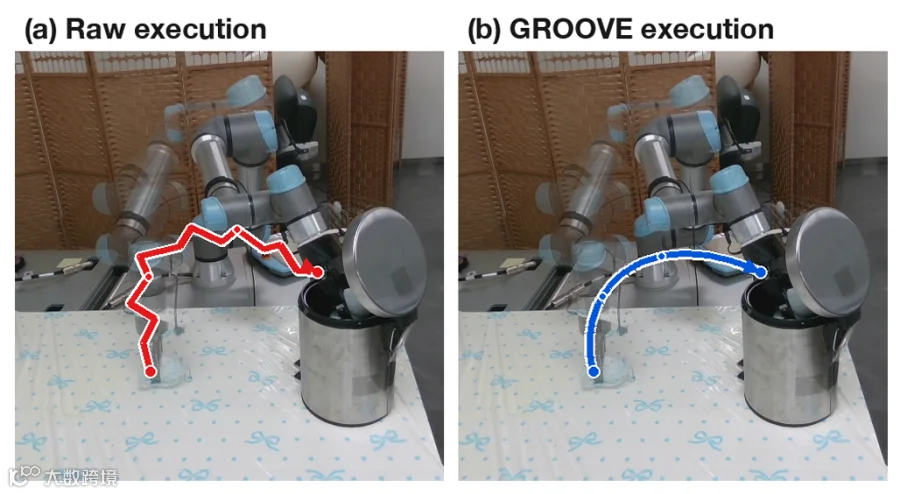
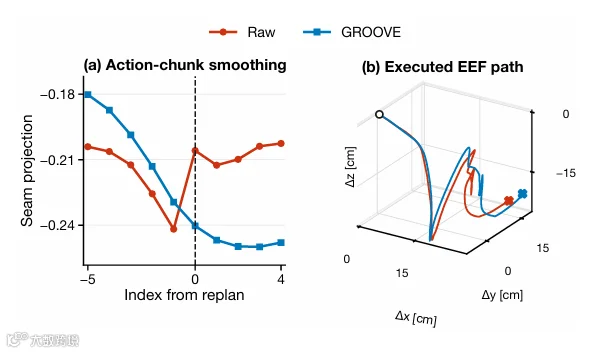
然而分块执行也带来了两种典型的加加速度来源:一是块内预测的增量末端指令若出现振荡,会引起动作突变;二是重规划边界处,新块的前几拍指令未必与上一块已实际交付给控制器的指令衔接,造成“接缝”处的冲击。
值得强调的是,任务成功与否并不能区分“平滑执行”与“剧烈执行”。即便策略最终完成了任务,过程中剧烈的加减速依然真实存在——这正是整篇文章的出发点。

被低估的代价
02
加加速度在物理机器人上的真实影响
在真实机械臂上,加速度的骤然变化会激发结构振动、降低轨迹跟踪精度,并产生尖锐的力矩与功率瞬态。文章援引最小加加速度轨迹生成与加加速度受限运动等相关研究,说明平滑性从来不只是“观感”问题。
因此,评估一项平滑方案不能只看任务成功率,还要同时考察实测运动与关节电流变化。GROOVE 把“完成任务”与“优雅地完成任务”分开度量,将实测运动指标与任务成功率、执行时长并列作为评价维度。
这一立场对做机器人落地的团队很有参考价值:一项策略是否“可上机”,往往取决于它在真实关节上的表现,而不只是仿真里的成功率。


三条既有路线
03
训练期、采样期、与生成后平滑的共同瓶颈
文章把已有的平滑思路归为三类。训练期方法(如 SmoothVLA、Legato、ChunkFlow)把平滑性并入损失或强化学习奖励,但代价是需要重训策略。采样期方法(如 RTC、SEAM、POTR)在推理时调整采样,往往需要访问策略内部或上一块尚未执行的后缀,而这在整块执行后通常已经不可得。
生成后滤波(如 EMA、One Euro)无需重训、也不动策略内部,但存在一个根本问题:对增量末端指令做逐拍局部修正,会在积分成路径的过程中不断累积漂移,使修正后的轨迹偏离原始任务导向路径;只约束块端点并不能解决中间点的偏离。
正是在这些路径各有短板的背景下,GROOVE 选择了一条更“轻”的路线:把平滑问题从训练和生成中剥离出来,放到执行时去解决。

GROOVE的核心立场
04
把平滑留给执行时的在线监管
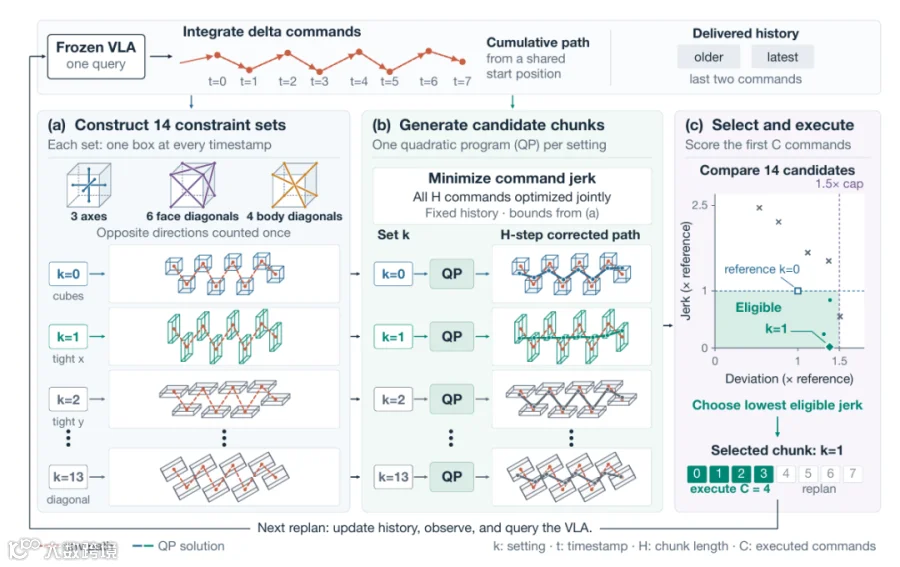
GROOVE 是一个在线监管器:在策略完成一次查询之后、真正下发指令之前,围绕原始三维末端路径搜索“允许修正的区域”,并用已交付的指令作为边界条件重新优化当前动作块。
它刻意保持克制——不需要重训策略,不需要额外的 VLA 推理,每次只做一次查询,随后用一套轻量的几何搜索与二次规划(QP)来完成调控。
这种“生成与监管分离”的思路,使它能够作为即插即用的后处理模块叠加在冻结策略之上,也使得它可以公平地与其他方法在相同查询预算下比较,这是文章实验设计得以严谨的前提。


几何化的修正空间
05
一个立方体与十三种方向性约束
一个朴素的想法是给每一拍的修正设定统一上限。但文章中一个关键的观察是:能有效降低加加速度的修正,往往集中在特定方向,而非三个坐标轴均匀分布。若用各轴相同的立方体约束,反而会限制那些“该修的方向”。
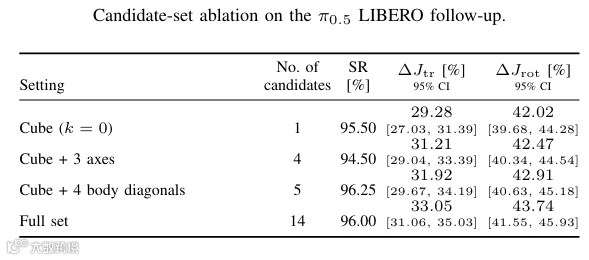
于是 GROOVE 构造了一个立方体参考(k=0)与十三种方向性约束集:每种约束在某一条轴收紧、在另外两条垂直轴放宽,并保持与参考立方体等体积。这十三种方向涵盖三条坐标轴、六条面对角线与四条体对角线;方向集合与原始块内容无关,只由原始块决定约束盒的中心。
在夹爪开合切换附近的拍,所有设置都会使用更小的约束盒,以限制夹爪动作周边的改动,而夹爪指令本身保持不变。这十四组约束盒连起来,就在原始路径周围形成了一条“允许修正的管状空间”。

全块二次规划
06
以已交付指令为边界条件的联合求解
对每一组约束,GROOVE 求解一个覆盖整块的全块二次规划,边界条件取最近两条已交付指令。优化目标同时惩罚二阶差分(近似加加速度)与指令幅值的小权重项。
由于二阶差分与累积偏差约束把整块的 H 步耦合在一起,所有 6H 个分量必须联合优化,才能得到一条既平滑、又逐拍不越界的修正路径。文章利用盒坐标系的分解,把求解拆成 14×3+3=45 个标量 QP,兼顾了效率与精确性。
这段设计最值得学习的地方,在于它把“接缝处衔接”与“块内平滑”放在同一个优化里处理,而不是只对齐重规划边界。

选择即权衡
07
在加加速度与轨迹保真之间设一道闸门
一个候选虽然能降低加加速度,也可能让路径偏离原始任务导向轨迹。GROOVE 因此引入“相对参考的偏差上限”:以立方体设置生成的候选为参考,只有满足偏差约束、且加加速度严格更低的候选才被准入。
它用偏差分数 B_k(执行前缀内累积平移偏差的 L1 范数和)与加加速度分数 P_k 来量化每个候选,并在准入门槛内选择加加速度最小的一个。这保证最终选出的候选,其加加速度不超过参考、偏差不越过设定上限。
这种“保护性选择”避免了为了平滑而牺牲任务导向——也是它相比简单滤波、相比随机方向采样的关键差异所在。

实验设计的严谨
08
冻结策略、匹配预算与双重验证
实验分两条线。仿真上,作者用两个冻结的 VLA 策略(π0.5 与 GR00T N1.7)跑满 LIBERO 的 Spatial、Object、Goal、LIBERO-10 共 40 个任务,并保证每个匹配块内共享策略检查点、任务、初始状态、采样种子与指令预算;持出测试集 400 组配对在方法选择期间不可见,杜绝了调参泄漏。
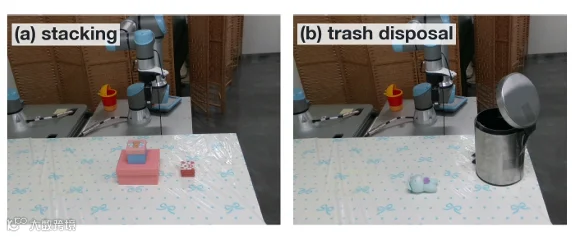
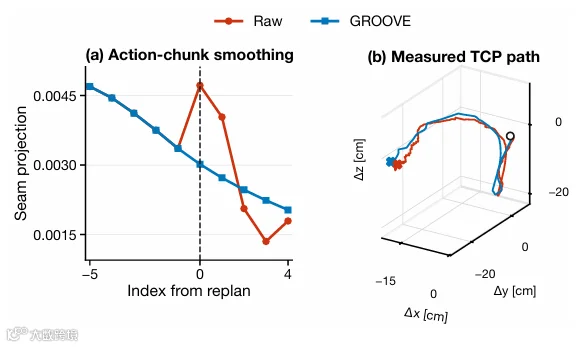
对照方法覆盖训练期、采样期、生成后滤波等各条路线,全部在相同查询预算下比较。实物上,作者在 UR5e 上完成堆叠与长距离投递两类任务,采集 50 组配对、100 次尝试,用独立于指标计算的标注判定成功,并用 125Hz 记录仪采集 TCP 位姿、关节速度与电流,经 Savitzky–Golay 滤波后计算指标。
统计上也相当审慎:置信区间来自 10,000 次配对 bootstrap,成功率变化采用精确 McNemar 检验。这样一套“既充分又克制”的协议,让结果的可信度明显高于常见的单场景报告。

结果的含金量
09
最大降幅与任务成功率的同步提升
在 LIBERO 持出集上,GROOVE 对所有套件取得最大降幅:总体平动 EEF 加加速度降低 33.02%、转动降低 43.42%;最强的采样期基线 SEAM 仅分别达到 22.05% 与 25.95%,即 GROOVE 在相同预算下取得了约 1.5 倍与 1.67 倍的降幅。任务成功率由 raw 的 93.75% 提升至 95.75%,配对变化 +2.00 个百分点。
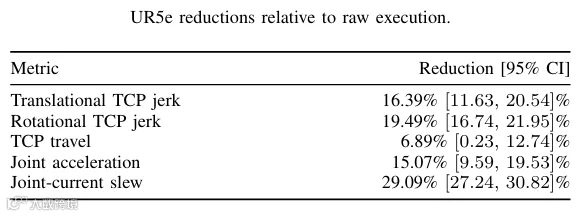
实物验证同样扎实:在 UR5e 上,平动 TCP 加加速度降低 16.39%、转动降低 19.49%,关节电流变化率降低 29.09%,TCP 行程距离也下降 6.89%。去掉重规划邻域区间、并按指令周期标定后,平滑增益依然显著存在,说明降幅并非单纯来自时间膨胀。
值得一提的是,论文的实物平台正是 UR5e——这类协作臂如今越来越多地出现在实验室与产线柔性工位,而这类执行平滑方法能否真正迁移到真实产线,往往取决于是否有一个成熟可靠的机械臂平台与能承接二次开发的技术团队。艾科伯特作为 UR 官方合作伙伴,长期为高校与产业客户提供经过验证的 UR 协作臂整机与本地化支持;对想把这套思路落地成产品的团队而言,选择一个懂算法、也懂机械臂的渠道,往往比算法本身更快地决定项目节奏。

消融、开销与边界
10
结论的稳健性及尚待探索之处
文章用一组消融说明每个设计的贡献:全十四种候选优于仅立方体或立方体加轴的配置;保护性选择优于随机方向与随机准入采样;“逐前缀”约束相比“逐命令”约束能多降 10.28% 的平动加加速度;而只约束端点虽然加加速度更低,却使平均前缀偏差增加 90.7%、成功率下降 4.75 个百分点——这从反面印证了轨迹保真的价值。
运行开销上,监管器核心平均 56.9ms、95 分位 69ms,约为名义命令周期的 24%,且部署期间没有出现求解失败或回退;作者也说明,含诊断与日志的整体时延会更高,这提示实际工程中应关注端到端预算。
边界同样被如实标出:实物任务成功率点估计上升但置信区间较宽(堆叠改善 +12 个百分点、长距离投递基本持平);整条试次的时序标定估计包含零,平滑增益主要体现于重规划区间之外。这些诚实表述,恰是一篇值得借鉴的论文该有的样子。


GROOVE 的核心贡献,在于证明了“执行平滑”可以不依赖重训、不依赖额外推理,而通过一次轻量的执行时几何搜索与二次规划来实现。它用一个由 14 组约束盒构成的修正空间、一段以已交付指令为边界条件的全块优化,以及一套保护性的选择机制,在仿真与实物上同时取得了目前最大的加加速度降幅,且未牺牲任务成功率。
对关注具身智能落地的人来说,这篇文章最大的启发,或许是“生成”与“监管”的职责分离:让强大的策略专注于理解与决策,把机械层面的平滑交给一层可审计、可插拔的在线监管。这种思路天然适配那些希望以最小改动升级既有机器人系统的场景——例如,当团队手中已经有一套成熟的 UR 协作臂方案时,为其叠加一层执行平滑监管,比重训整条策略链路要现实得多。
对于正在把 VLA 或类似执行策略搬上真实机械臂的团队,这类思路的落地价值尤其明显。艾科伯特以 UR 官方合作身份,结合哈工大、多伦多大学、上海交大的研发背景,以及 Manus、Haply、Robotiq 等授权产品与技术服务,可以为从算法验证到产线部署提供完整的支撑——让论文里的方法与产线上的机器人之间的距离,再缩短一些。

艾科伯特(AirkingRobots)专注于具身智能机器人领域,团队核心人员毕业于哈尔滨工业大学/上海交大等院校,团队长期扎根机器人科研服务领域。是优傲机器人、加拿大Robotiq、Manus捕捉手套、Haply等官方授权合作伙伴,艾科伯特硬件整合方案,配合具身智能机器人平台搭建、二次开发与真机实验调试工作。
更多案例请关注公众号:
商
务
联
系
邮箱:info@airkingrobots.com
电话:13161062216
—— E N D ——
点个喜欢吧