

我现在写东西、改代码、处理杂事,几乎都在 Claude Code 和 Codex 里,偶尔用 OpenCode。
所以看到 IQuest-Q1 的介绍,说它要补的是智能体的基础能力,写代码、办杂事都得在命令行里干,我第一反应是:这不就是我每天干活的地方吗。
IQuest-Q1 是至知创新研究院(IQuest Research)9 月底开源的模型。总参数 320B,每次只动其中 15B,上下文 512K,现阶段只支持文字输入。10 月 23 日,它的技术报告也在 arXiv 上公开了。
再看它的成绩,说实话我非常惊讶。它只是个小模型啊,每次只算 15B,能把智能体的活干到这个程度,这件事本身就足够颠覆认知。现在的国产模型,真是越来越强了。
先看它能干什么
技术报告一共放了 30 项评测,还拉了 6 个模型一起比,其中两个是闭源旗舰。30 项太多,我按用途归成六类,每类挑一两项有代表性的。
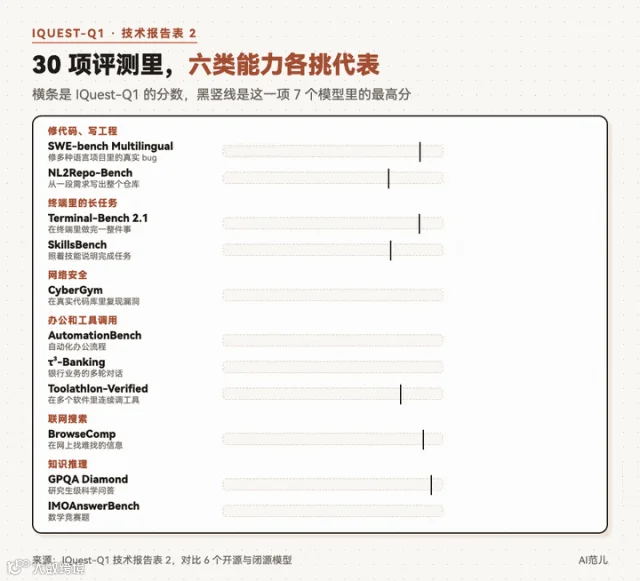
▲ 图:六类能力的代表评测
最让我在意的是安全。CyberGym 是在真实代码库里复现安全漏洞,IQuest-Q1 拿了 84.5,表里最高。
AI 安全这项能力,最近特别值钱。前几天 AI 在 PHP 里挖出两个藏了 20 年的漏洞,日本首相都出来催大家打补丁。扫描公司 Censys 的数据是,互联网上约有 5490 万个网站在跑 PHP。AI 安全,已经是一项非常重要的能力。
报告里也写了一次实际试用:三天里,安全专家借助 IQuest-Q1 写出 30 份漏洞报告,每份都经过其他安全专家独立验证,涉及开源项目的已经通知了维护者。
现在我们用 AI,基本都是在用智能体了。最近个人 Agent 也特别火。模型的智能体能力,至关重要。
办公类的 AutomationBench(自动化办公流程)和 τ³-Banking(银行业务的多轮对话),测的就是这类活,这两项它也是表里最高。修代码、终端任务、搜索这几类,也都在 7 个模型的中上游。
IQuest-CLIBench 是 IQuest 自己做的测试,看 CLI 智能体用起来顺不顺,它拿了 53.7。
这项测试不只看最后做没做成。它用脚本扮演一个真人用户,跟智能体来回对话;打分既看干活的过程,也看做完以后环境里的状态对不对。这更接近我们平时跟 Agent 来回磨的样子。
差距主要在更难的终端长任务(Terminal-Bench 3.0、4.0)和专家级推理(HLE),离闭源旗舰还有一段距离,报告自己也说还有提升空间。
这些分数大多是在 Claude Code 里跑的,限时、采样参数都写明了,照着能复现。
能做到这些,靠的是什么
分数看完,我更好奇的是它怎么练出来的。
让模型当智能体,其实挺折腾。一个代码仓库动辄几十万字,它得读得下;每走一步都要算一遍,太费算力谁也用不起;回复还得一个字一个字往外吐,慢了人等不了。这还只是身体条件,真正难的是本事:读代码、调工具、看报错、一直改到测试通过,这些都得靠练。
报告有 30 页,我按一个任务从头到尾的顺序,挑能讲明白的部分说。
读得下:平时看手边几页,隔几层通读全书
你让模型修一个 bug,它得先把相关代码、报错、前面聊过的话全读进去,工具返回的一大串东西也得记着。IQuest-Q1 最长能读 512K Token。
这个我深有体会。我写长文、改稿的时候最明显,资料一多,改上几轮上下文就满了,只能压缩,或者干脆重开一个对话。
读得多就有代价。传统注意力每写一个字,都要回头把前面所有内容扫一遍,内容越长越慢。
IQuest-Q1 的思路有点像人看书。大部分层只盯着最近 4096 个 Token,相当于只看手边那几页;隔几层再安排一层把全文通读一遍,前面的内容就不会丢。
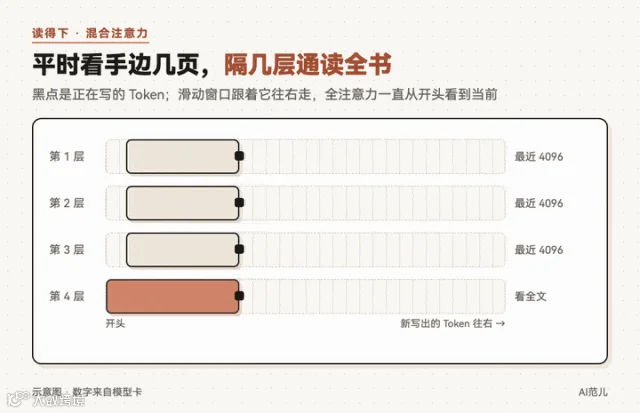
▲ 图:3 层滑窗加 1 层全注意力
具体到层数:一共 88 层,头两层、尾两层看全文,中间是三层看手边、一层看全文,这么轮着来。这样大部分层的计算量,不会因为上下文变长一路往上涨。
算得省:256 位专家,每次只请 8 位
读进来以后,每写一个 Token 都得算一遍,这才是花钱的大头。
IQuest-Q1 是稀疏混合专家(MoE)结构。你可以把每一层想成一个 256 人的专家团,来一个 Token,只叫醒最对口的 8 个人,其他人接着睡。
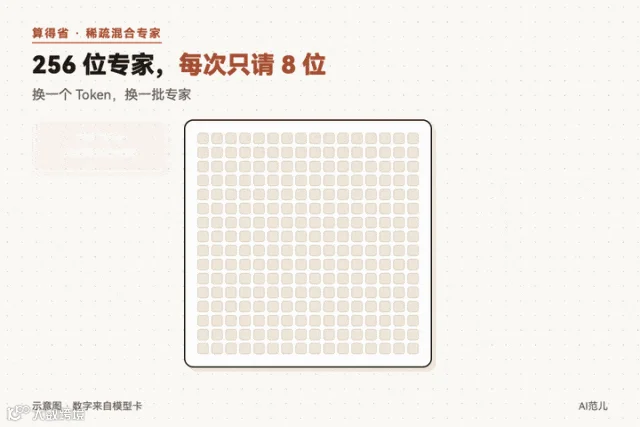
▲ 图:每个 Token 只叫醒 8 位专家
所以它总共有 320B 参数,肚子里的东西不少,但每次真正干活的只有 15B。
模型这么大,训练时最怕不稳,练着练着就崩了。他们用了 Stable SplitNorm、Muon 优化器和 μP 参数化。不用记名字,记住效果就行:训练更稳,深层网络也能出力;学习率在一个 18 层的小模型上调好,直接搬到大模型上用,不用再从头试。
省了多少?报告里做了个对照:同样的数据,跟一个按 Qwen3-30B-A3B 配置搭的 MoE 比,练到同样的损失,IQuest-Q1 只花了对方大约 52% 的算力。
他们还定义了一个叫 Critical Model Size 的指标,估模型放到多大还能稳稳地练。按他们拟合的趋势往外推,激活参数到 572B 左右、总参数到 12T 左右之前,都还算稳。现在才 15B 激活,空间还很大。
写得快:一个草稿模块,反复用
读完、算完,最后要把回复写出来。大模型只能一个 Token 一个 Token 地吐,上下文越长,每一步越慢。
速度这件事我也很在意。等它改稿的时候我最着急,所以一般会开好几个窗口并行。
提速的老办法叫投机解码。先让一个小模块打草稿,一口气猜出后面几个 Token,大模型一次把这串检查完,猜对的直接收下,省得一个个算。
IQuest-Q1 的草稿模块有点特别,叫递归多 Token 预测(Recursive MTP)。它从预训练第一天起就带着两个 MTP 层,一边学一边练着往后猜,顺带也让主干学得更好。训练完,留下一个改成草稿器,另一个丢掉。
“递归”的意思是同一个模块反复用。猜出一个,拿这个结果接着猜下一个,最多连猜 8 步。模块还是那一个,草稿却能拉得很长。

▲ 图:递归草稿器连猜几步
还有个小心思:草稿器只看最近 512 个 Token。上下文再长,打草稿这一步也不会跟着变贵。
底子怎么打的:从预训练开始
前面说的都是身体。会干什么活,还得看怎么练。
IQuest-Q1 是从零开始预训练的,大的阶段分三段。
▲ 图:训练的三个阶段
预训练和中期训练加起来,一共喂了约 29T Token。预训练里代码的比例从 40% 一点点加到 70%,理工科数据也越加越多,先把读写代码的基本功打扎实。
中期训练开始喂“经验”:推理问答,还有智能体真实干活时一步一步的记录。
这种记录很难攒。他们干脆从代码仓库搭了 100 多万个能真跑的容器化任务,让智能体挨个去做,把完整、有效的过程留下来当教材。
上下文也是慢慢拉长的,从 32K 到 128K,最后到 512K,让它习惯又长的代码仓库、又长的工具返回。
练到一半,怎么知道练得对不对?报告里有两种考法。一种是拿高手智能体干活的真实记录来考,看它能不能猜中高手的下一步,猜得越准越像高手。另一种是把长任务拆成一个个小能力,分开看哪项不稳,弱哪项就补哪类数据。
在哪练:先搭练习场
到了后训练,要练真本事,就得给它真能干活的环境。
IQuest-Q1 的练习题,是连环境一起造出来的。通用任务接的是真实的 API、MCP 服务、公开的技能和工作区文件,还按职业分类铺开,尽量什么行业都沾一点。
编程任务从 GitHub 仓库和行业数据出发,用 Claude Code、Codex 搭出能跑的环境,连搭环境这活都是模型自己干的。
每道题是一个独立的小环境,配一个验证器。出题也有讲究:参考答案必须能过,什么都不做必须过不了。题太简单,就加限制,再验一遍。
怎么练:同一个模型,放进几套工具里
先做两轮监督微调(SFT),把基本的命令行交互教会,第一轮用了 240B 多 Token,第二轮 50B 多。
接下来是我觉得最关键的一步:把同一个模型放进 Claude Code、Codex,还有它们的不同版本里,一起做强化学习。
这两套工具,正好是我天天在用的。不同工具,甚至同一个工具的不同版本,工具名字、参数格式、上下文管理都不一样,一个模型在这套里顺手,换一套可能就不会了。
这个我太有体会了。都说好马配好鞍,Harness(执行框架)就是马鞍,模型就是马。
同样一个模型,在 Claude Code 里和在 WorkBuddy 里,干活风格都不一样,表现能差出一大截。模型在自家的 Harness 里,和放到外面用,也很不一样。
IQuest-Q1 练的时候,每套工具都按它原本的用法来,模型一边解题,一边就把在真实工具里干活的习惯练出来了。
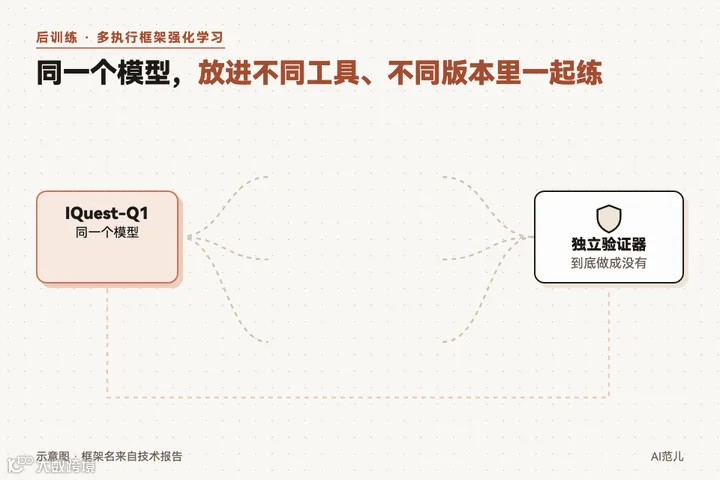
▲ 图:同一个模型进不同工具一起练
做没做成,由独立的验证器说了算。多做无用功、不守约束,都要扣分。
长任务步骤多,只在最后判一个对错太粗了,所以中途也按阶段给奖励,但只奖励能实际量出来的进展。模型自己写的诊断,也得拿执行记录作证,否则不算。
失败了先别急着罚,要先查原因。环境或工具自己坏了,不算模型的错;只有模型自己犯的错,才拿来学。要是验证器本身出了毛病,这条样本直接不用。
研发过程中,他们还让 IQuest-Q1 搭的智能体参与诊断问题、设计实验、分析结果,研究员负责拍板和审核。
报告里有个例子。模型碰到不熟悉的工具格式,一个长任务里错了 35 次工具调用。智能体翻了 6054 条调用记录,发现训练数据太偏向一种调用格式,有些记录里工具定义和参数还对不上。研究员看过它的诊断,它再自己去清洗、扩充数据,跑了一轮训练。
这种做法有个名字,叫递归自我改进(RSI),用模型来改进模型自己。现在它几乎成了训练大模型的通用做法。
这事我自己也天天在干:让 AI 改它自己的技能,出了错让它把经验写进记忆,再让它调自己的提示词和配置。改完,我再审一遍。
怎么防它作弊:三道关
在能真跑的环境里练,有个坑必须防:奖励作弊(Reward Hacking)。
模型想要的是奖励,不一定是把事做对。它可能去翻仓库的历史提交找现成答案,或者偷看隐藏测试。测试是过了,活其实没干。
报告里设了三道关。练之前,先把会漏答案的代码历史清掉,参考解答删掉,环境之间隔开。练的时候,隐藏测试和外部答案碰都不让碰,被拦下来会收到明确提示,模型可以换条正路接着干。练完以后,用规则加模型一起审每条记录,确认作弊的直接扔掉。

▲ 图:防作弊的三道关
审出来的新花样,再补回拦截规则里。这样拿到的奖励,才对应真把活干完了。
怎么合成一个:四个老师带一个学生
强化学习练出了四个专家,各管一摊:终端交互和用户体验、适应各种执行框架、长程代码和安全任务、通用智能体能力。
最后要把四个人的本事装进一个模型里,用的是多教师在线策略蒸馏(MOPD)。
▲ 图:四个老师带一个学生
“在线策略”说白了,就是学生先自己做一遍,对口的老师再一个 Token 一个 Token 地批改,哪步走得好、哪步走偏了。比起背标准答案,学的是自己真会走到的那些步。
四个老师也不用占四份显卡。它们轮流用同一批卡,轮到谁再把谁加载进来,下一个提前预读。以后再加老师,显卡也不用成倍往上加。
这种带法最近用得越来越多,图的是几门本事一起学,不容易出现这门练好了、那门反倒退步。
最后,再把不同阶段、不同分支的模型合到一起,就是现在的 IQuest-Q1。
怎么用,适合谁
权重放在 Hugging Face 和魔搭(ModelScope),许可证是改过的 MIT,商用时要在界面上醒目地标出“IQuest-Q1”。
官方推荐用 SGLang 或 vLLM 部署,命令里默认 8 张卡做张量并行,没写具体型号。按权重算,官方 BF16 版约 641GB,要 H200(141GB)这一级的卡;社区做的 FP8 版约 327GB,有人用 8 张 H20 跑通了。
部署好以后,可以直接调接口,也可以接进 Claude Code 或 Codex,中间要一个支持工具调用的网关。
我办公大部分事情都围绕飞书。Agent 加上飞书的命令行工具,我觉得是目前真正的黄金搭档,效率真的高了一大截。最近有一些公司老板问我,企业里怎么落地 AI、用 AI 提效,我基本必推这类方案。
所以它很适合企业。最近很多企业在关心自己部署模型:在自己的机房里部署一套,数据不出门,更安全,长期算下来也省钱。现在模型和硬件都差不多成熟了。
社区也已经做了 FP8、4 位、2 位等量化版本,体积从约 327GB 到约 88GB 不等,部署门槛在一步步降低。
个人想在本地跑,最小的 2 位版约 88GB,有人在 128GB 统一内存的 DGX Spark 上跑通了;同样 128GB 的 RTX Spark 笔记本也装得下。想跑 4 位版,就得上 512GB 内存的 Mac Studio 这一级。
我自己呢,可能会升级硬件,或者等更小的版本出来。实在不行就用 API,现在 API 的性价比其实非常高。
最后
我觉得定位清晰的模型有很大的优势,它可以针对一类任务做到非常极致的优化。IQuest-Q1 从预训练开始,就是奔着智能体去练的。
同时,端侧模型的模型和硬件都快成熟了,接下来应该会有非常大的市场,很快就要爆发。我非常看好这些方向。
你会在公司里部署一套这样的模型吗?
参考资料
01|IQuest Research:IQuest-Q1 技术报告
https://arxiv.org/abs/2610.30949
02|IQuest Research:官方博客
https://iquestlab.github.io
03|Hugging Face:IQuest-Q1 模型卡
https://huggingface.co/IQuestLab/IQuest-Q1
04|GitHub:IQuest-Q1 仓库
https://github.com/IQuestLab/IQuest-Q1