

Kimi K3.1 Pro 终于发布了。看到 Artificial Analysis 那张榜,我的第一反应是:国产追上来了。
说实话,看了这个榜单我一点都不意外。K3 已经非常强了,我相信他们憋了这么久,一定在憋个大招,所以这是意料之中的事。
Kimi K3.1 Pro 今天凌晨上线,AA 智能指数 55 分,全球第 4。
GPT-6 Astra、Gemini 4 Argon 都被它压在后面,前面只剩 Claude Opus 5.5、Claude Sonnet 5.5 和 Meta 还没开放 API 的 Muse Wonder Full。
但别急着说它追平了 Claude。
同样的价格,Claude Sonnet 5.5 在 AA 上比它高 1 分,在 Arena 的真人投票里也排在它前面。
更离谱的是,它的参数一个没加。

▲ 图:AA 智能指数:K3 的 44 分一路爬到 55 分

▲ 图:AA 官方榜单原图
谁能用,谁不能用
现在就能用。
Kimi.ai、Kimi App、Kimi Work、Kimi Code 和 Kimi API 都上了,API 里的模型名是 kimi-k3.1-pro。
另有一个 Highspeed 版,官方说智能一样,输出快 2 到 3 倍,价格翻倍。
企业版默认没开,要管理员手动打开。
还不能用的是权重。官方写的是 11 月 4 日前放出,许可证没说。
AA 和 Arena 都提了一句:权重一放出来,它就是两个榜上最强的开放权重模型。
参数没变,分数涨了 11
K3.1 Pro 和 7 月的 K3 是同一个底子:总参数 2.8T,每次只调用其中 1040 亿。
官方的解释是,K3.1 Pro 是 K3 的后训练版本,后训练的算力大幅增加。
后训练可以理解成上岗培训:底子不换,给它海量的实际任务去练,做对了奖励,做错了扣分。
官方说这次同时练了几百个领域,为此从强化学习框架、沙箱到调度系统,把训练设施逐层做了优化。
AA 也注意到了这一点:同样的参数量,它在“分数对参数”的对比里排在最前面。小米的 MiMo-V2.6-Pro 1.02T 参数是 46 分,智谱的 GLM-5.3 753B 是 45 分。
最强的是动手干活
这次涨分,主要涨在 Agent 上,也就是让模型自己动手、连续干完一串活。
Terminal-Bench 4.0 测的是在真实终端里干活:装环境、改代码、跑测试,资源还给得很紧。AA 自己跑了一遍,K3.1 Pro 拿了 67.2%,是所有模型里最高的。上一代 K3 只有 12.6%。

▲ 图:Terminal-Bench 4.0:从 12.6% 冲到第一
GDPval-AA 测的是真实工作任务,比如做报表、写分析、整理材料,用两两对比的方式打分。K3.1 Pro 排第 3,比 K3 涨了 312 分,只落后 Opus 5.5 和 Muse Wonder Full 一点点。
AA 的 AutomationBench 让模型在各种 SaaS 软件里跑工作流,它从 58% 涨到 73%。
官方自己的成绩单里,还有两项值得说。SWE Marathon 是超长的软件工程任务,K3.1 Pro 51.7,领先 Opus 5.5 一截。Agents' Last Exam 也是它第一,和 Opus 5.5 差不多。
这两项是官方自己测的。
官方案例:游戏、3D 和一个会走路的人
官方公众号放了 10 个案例,大多标明是 K3.1 Pro 从头做到尾。
人体走路和天宫游戏这两个,我印象都挺深。长程任务是我现在干得比较多的一类活;游戏的复杂度确实比较高,从效果上看也非常好。
第一个是用虚幻引擎 5.8 做的天宫对战游戏。半径 1750 米的柱廊是它在 Blender 里程序化建出来的,场景有 3600 万个三角形。
云海和月球地形用的是外部素材,也是它自己找来接进去的。
▲ 视频:Kimi 官方案例,虚幻引擎 5.8 天宫对战
这个案例能看出它会自己找工具。官方说 K3.1 Pro 能用 Unity、Unreal、Godot,能边搜素材边建模,再把东西拼成一个能玩的游戏。
第二个是浏览器里的 3D 机械臂展示页。2317 个零件、268 条走线,全是代码生成的,能拆开看,也能看剖面。
▲ 视频:Kimi 官方案例,浏览器里的 3D 机械臂
第三个是 FreeCAD 里的涡扇发动机,2100 个实体,风扇、齿轮箱、压气机、燃烧室都有,三根转子还按各自转速转起来。
▲ 视频:Kimi 官方案例,FreeCAD 涡扇发动机
BenchCAD 测的就是这种本事:看几张多角度的渲染图,写 CAD 代码把零件重建出来。官方测试里,K3.1 Pro 带工具时落后 Opus 5.5 和 GPT-6 Astra 一点,不带工具时和 Opus 5.5 差不多。
kimi.com 上同步上了一个 3D Make,做好的模型能直接下载去 3D 打印。
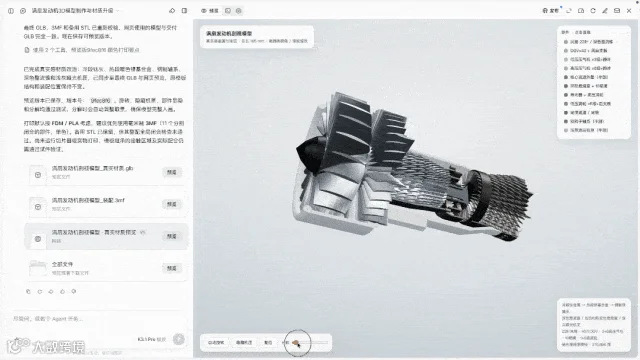
▲ 图:3D Make 界面
最让我意外的是第四个:让它造一个会走路的人。
起点是一套开源的人体解剖模型,有 296 个骨骼组件、402 个肌肉组件。
K3.1 Pro 自己搭训练流程,跑了 167 项任务、420 次评审,一边看结果一边改控制器。一开始仿真人走几步就倒,最后能交替迈步,连续走 11.2 秒。
▲ 视频:Kimi 官方案例,人体行走仿真
这就是所谓的长程任务:自己定位问题、自己改、自己验证,前后 420 次评审,中间没人插手。
金融:更准,也更少瞎说
金融是官方这次主推的第二个方向。
OfficeQA Pro v2 用真实的金融文档出题,要检索、跨文档核对、多步计算。K3.1 Pro 拿了 64.4,官方说是目前最好的成绩。
三个内部金融测试里,变化最大的是商业运营:在模拟的商业环境里长期经营、做决策,K3 只有 8.9 分,K3.1 Pro 是 37 分,大约 4.2 倍。
官方的案例是一个英伟达财务模型:公式全部联动,每个假设都有依据,改一个经营参数,估值跟着变。
▲ 视频:Kimi 官方案例,NVDA 财务模型
做金融最怕编数字。官方自己的幻觉压力测试里,单条事实说错的比例从 23.4% 降到 8.3%。
官方也说,这是专挑难题的压力测试,不代表日常使用的整体水平。
AA 的独立测试也看到了进步:幻觉率从 53% 降到 44%,准确率从 48% 涨到 51%。两边题目不一样,不能直接比,但方向一致。
用过的公司怎么说
官方放了几家早期测试伙伴的反馈。这是官方挑过的,只能当参考。
1 / 6
OpenCode 联合创始人 Frank Wang
“模型会主动探索代码库、理解项目指令,并在充分掌握上下文后才开始修改代码……即使上下文超过600K tokens,也没有感受到明显的能力退化。”
2 / 6
Qoder 模型评测团队
“Kimi K3.1 Pro 较上一代 K3 提升近 10 个百分点……在 Qoder 当前用例样本中处于领先位置。”
3 / 6
Unity 中国
“Unity 中国推出的 Tuanjie Codely 搭载 Kimi 旗舰模型,其在游戏开发场景中的代码生成能力表现出色……”
4 / 6
WorkBuddy 团队
“Kimi K3.1 Pro 在 Office 场景比肩前沿模型,较上一代有大幅提升,任务规划、执行与自测闭环明显增强。”
5 / 6
熵简科技首席技术官李渔
“我们对 12 个国内外头部模型进行了金融投研 Agent 场景评测,Kimi 是目前唯一能在该场景下平替海外旗舰模型的国产大模型。”
6 / 6
华夏基金(香港)CEO 甘添
“Kimi K3.1 Pro 的长程 Agent 能力让我们离这一目标更近了一步。”
真人投票:第 8
具体来说,我更相信 Arena 一点,因为它毕竟是盲投的。AA 现在说实话,有时候感觉不是很可信,他们的指标一直在调整。
Arena 的 WebDev 榜是真人盲投:同一个网页需求,两个模型各做一版,用户不知道是谁做的,选更好的那个。
K3.1 Pro 排第 8,从 K3 的第 17 往上跳了 9 名,和 Claude Opus 5 打平。这还是初步结果,误差在正负 14 分左右。
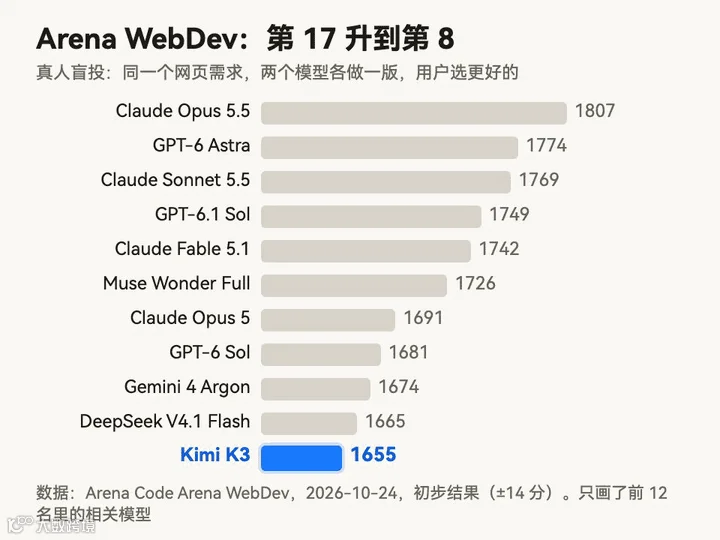
▲ 图:Arena WebDev:第 17 升到第 8
第 8 名说明两件事。
国产这一侧,它已经是第一,权重放出来以后也会是开放模型里的第一,超过 DeepSeek V4.1 Flash。
但离最前面还有距离。
Opus 5.5 领先它一大截,GPT-6 Astra 和 Sonnet 5.5 也明显在前面。AA 上那种“只差 3 分”的感觉,在真人投票里没那么近。
价格:单价便宜,账单差不多
K3.1 Pro 每百万 token 输入 13 元、输出 68 元,命中缓存的输入 1.3 元。
按美元算,三项都比 K3 便宜三分之一。
但它更能“想”了。AA 跑完整套测试,K3.1 Pro 每个任务多用了 14% 的 token。
一来一回,每个任务的钱是 1.98 美元,K3 是 2 美元,几乎一样。

▲ 图:单价降了三分之一,账单几乎没变
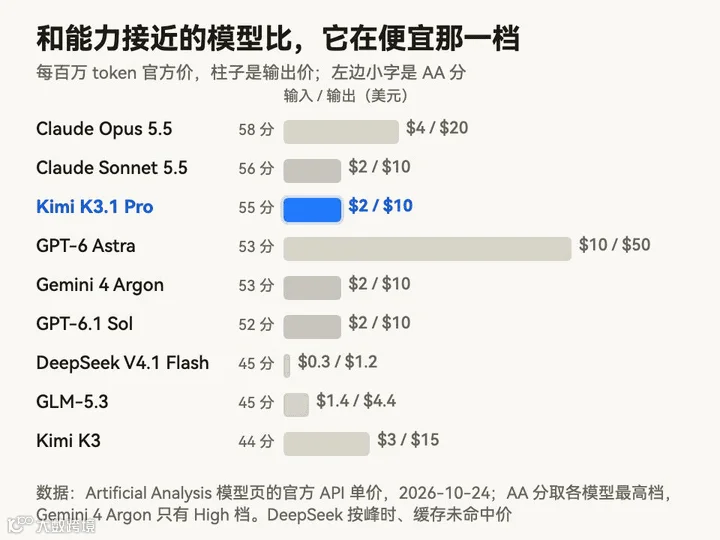
▲ 图:和能力接近的模型比价格
放到别家一起看:它和 Claude Sonnet 5.5、Gemini 4 Argon、GPT-6.1 Sol 同价,只有 Opus 5.5 的一半,GPT-6 Astra 的五分之一。国产的 DeepSeek V4.1 Flash 和 GLM-5.3 便宜得多,但 AA 分低了 10 分左右。
Arena 按自己的任务算,每个任务的中位成本是 1.23 美元,比 K3 便宜 29%。它说和 Opus 5 打平的同时,成本低了七成左右。
能力涨了一大截,花的钱没涨。
我拿 AA 的分数和官方单价做了一张性价比象限图。各家都用最高推理档,费用按输入、输出各 100 万 token 估算,不是每任务成本。

▲ 图:K3.1 Pro 的斩杀线
斩杀线画在 K3.1 Pro 上:比它贵、分数又不比它高的,都被圈进去变灰。GPT-6 Astra 和 Claude Fable 5.1 贵了 5 倍,分数还比它低;同价的 Gemini 4 Argon、GPT-6.1 Sol 也在圈里。
没被圈住的只有两个 Claude:Sonnet 5.5 同价,高 1 分;Opus 5.5 贵一倍,高 3 分。
说明一下口径:K3.1 Pro 在 AA 只有一个版本,Gemini 4 Argon 最高只有 High 档,两者都按各自的最高档放进来比。
一个反常的细节:主动把能力调低
网络安全这块,Kimi 做了一件很少见的事。
他们发现,训练语料和强化学习环境里本来就混着不少网络攻防内容,后训练越多,模型找漏洞、写利用的能力就越强。
为了放出权重,他们把这部分数据删了。官方自己的漏洞测试里,不删能做对 90.5%,删完是 81.0%。
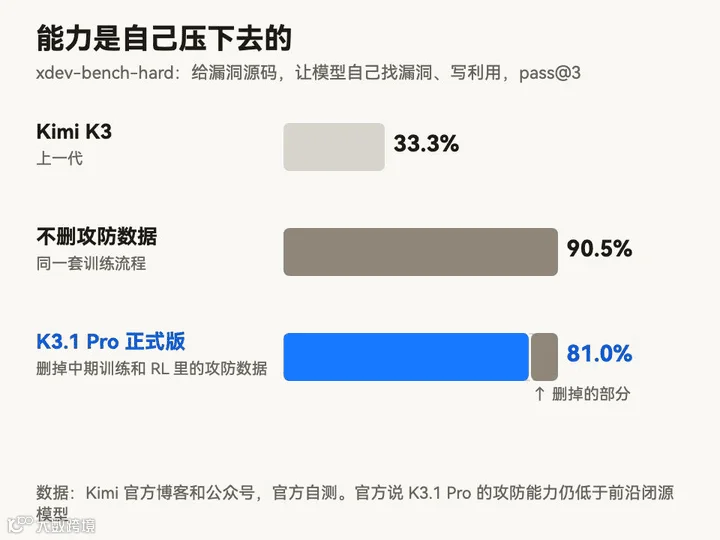
▲ 图:能力是自己压下去的
官方的说法是,不想放出一个会推高网络攻防天花板的开放模型。即便删过,它也比 K3 的 33.3% 高出一大截。
怀疑的声音
成绩单大多是官方自己出的。OfficeQA Pro 那一项,官方还说部分外部模型联网查到了参考答案,被判了零分,这会拉低别家的分。
它也有明显的短板。官方自己的成绩图里,Terminal-Bench Science 只有 38.1,GPT-6 Astra 是 68.1,落后不少。
速度一般。AA 测的官方 API 输出约每秒 77 个 token,比同价位模型的中位数(每秒 81 个)略慢。
还有一个用户反馈:老订阅用 K3.1 Pro 写代码,5 小时额度掉得很快。这条没有官方说明,但和 AA 测到的“token 用得更多”对得上。
最后
K3 是 7 月 16 日发的,三个月后,K3.1 Pro 在 AA 上从 44 分涨到 55 分,在 Arena 上进了前十。参数没变,靠的是后训练。
它强在动手干活。终端和长任务有 AA 的独立成绩撑着,3D 和金融目前主要看官方成绩和案例。
但整体看,它还不如同价的 Claude Sonnet 5.5,离 Opus 5.5 更远。
不用等 11 月的权重,现在就能用。我觉得它可以用来做很多事,如果真用下来效果好、性价比高,替代现在的 Claude、GPT 都没问题。
我现在就担心它的价格,还有额度消耗太快。以目前来看,DeepSeek V4.1 Flash 还是性价比最高的,这个模型怎么样还不知道。
你会先拿它干什么活?
参考资料
01|Kimi 官方公众号:Kimi K3.1 Pro:智能前沿,更进一步
02|Kimi:Kimi K3.1 Pro 技术博客
https://www.kimi.ai/blog/kimi-k3-1-pro
03|Artificial Analysis:Kimi K3.1 Pro 评测
https://artificialanalysis.ai/articles/kimi-k3-1-pro-launch-benchmarks
04|Arena:Code Arena WebDev 榜单
https://arena.ai/leaderboard/code/webdev
05|Arena 官方 X:K3.1 Pro 上榜
https://x.com/arena/status/2113687344532320326