发表期刊:Nature
发表年份: 2026
研究团队: FutureHouse、University of Oxford、Fordham University 等
研究领域:AI for Science、多智能体系统、自动科研、药物再利用、生物信息学分析
文章创新:Robin将过去相对分散的文献检索、假设生成和实验数据分析连接成了一个连续的科研循环。它不仅能够提出可能的研究方向,还能够根据真实实验数据更新假设,并推动下一轮候选筛选。
1
研究背景:从辅助科研任务到连接完整的科学研究过程
近年来,大语言模型在科学研究中的应用已经从文献问答逐渐扩展到复杂的任务执行。通过检索增强生成、工具调用和代码执行,AI Agent 可以在一定程度上承担文献筛选、数据处理、统计分析甚至实验方案建议等工作。然而,这些任务通常仍然以单次请求为单位运行:研究人员提出问题,系统返回分析结果,然后等待人工决定下一步如何开展研究。
真正的科学发现往往不是一次分析就能完成的。研究人员可能首先从文献中发现一个潜在机制,根据这一机制设计实验,再通过实验结果判断假设是否成立。如果结果与预期不一致,还需要重新分析数据、查找可能的原因,并提出下一轮研究方案。这一反复修正的过程,是科学研究区别于一般信息检索或数据分析任务的重要特征。
药物再利用(Drug Repurposing)为这类研究提供了比较合适的应用场景。它不是从头设计全新的化合物,而是尝试寻找已知药物的新用途。许多潜在的药物作用机制实际上已经分散在不同领域的研究文献中,只是相关证据没有被及时联系起来。研究人员需要同时理解疾病病理、细胞机制、药物靶点和已有实验结果,才能形成可以验证的新假设。
Robin 所要解决的正是这种跨文献、跨任务的信息衔接问题。研究团队希望构建一个能够连续完成科研假设生成与实验数据分析的系统,使上一轮实验得到的结果成为下一轮研究的输入,而不是让每个任务始终独立运行。
2
Robin:通过多智能体协作建立科研闭环
Robin 并不是一个单独的大语言模型,而是由多个具有不同职责的语言 Agent 共同组成的科研系统。其整体流程包括研究目标输入、假设生成、实验方案筛选、实验结果分析以及假设更新。研究人员首先提供目标疾病,系统查阅相关研究,提出可能的疾病机制和干预方向,并生成候选药物;实际实验完成后,Robin 再分析新产生的数据,结合已有知识继续提出后续研究方案。
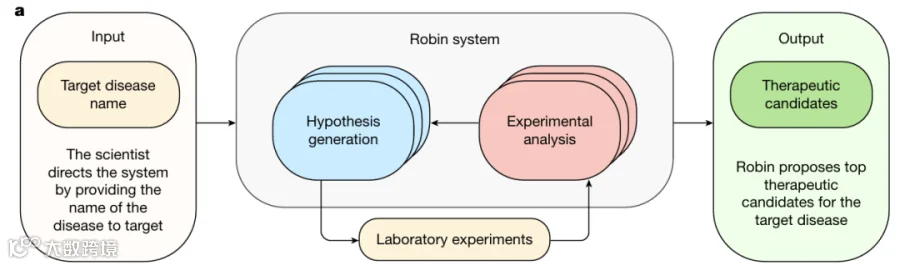
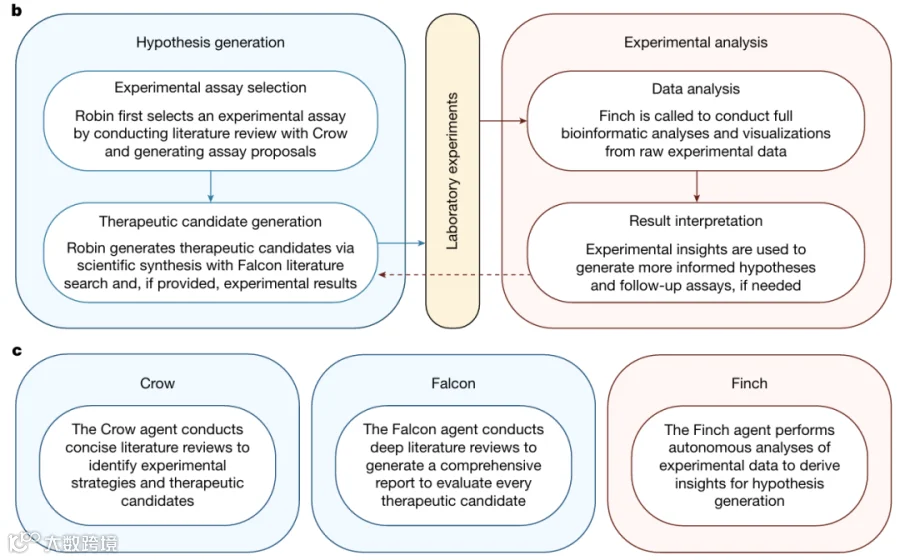
图 1 | Robin多智能体架构与科研工作流
Robin 的核心由 Crow、Falcon 和 Finch 三类专业 Agent 组成。其中,Crow 负责较为简洁的文献检索和背景整理,帮助系统识别疾病机制与实验方向;Falcon 负责更加深入的文献分析,为候选药物提供依据、适用条件及潜在限制;Finch 则承担实验数据分析任务,包括流式细胞术数据处理、RNA-seq 差异表达分析和统计结果整理。Crow 与 Falcon 基于 PaperQA2 提供的文献处理能力,Finch 则能够直接运行 Python、R 等分析代码。
在假设生成阶段,Robin 并不会直接从大量药物中随机挑选候选,而是首先围绕疾病提出一组病理机制问题,检索相关证据,并进一步评估这些机制是否能够通过现有实验方法验证。对于选出的实验方向,系统再生成候选药物及对应的科学依据,最后通过 LLM Judge 对候选方案进行两两比较和排序。论文采用 Bradley–Terry–Luce 模型汇总比较结果,以形成相对稳定的候选排名,而不是简单要求模型直接给每个方案打分。
实验数据分析是整个架构中另一个重要环节。为了降低 Agent 分析过程中的随机性,Robin 会对同一批数据启动 8 条相互独立的 Finch 分析轨迹。每条轨迹分别生成可执行代码并完成分析,系统随后汇总不同轨迹的结果,提取相对一致的发现,再将其反馈到假设生成阶段。这种设计并不能消除统计错误,但能够帮助研究人员观察不同分析路径是否得出了相同结论。
在实现上,Robin 使用 OpenAI o4-mini 执行主要的文献综合与假设生成任务,使用 Claude 3.7 Sonnet 对候选假设进行比较判断。Finch 基于 Aviary 框架运行,通过 Jupyter Notebook 执行分析代码,并在标准化容器环境中完成相关计算。论文作者还发现,Robin 在实验过程中大多按照相似的工具调用顺序运行,因此将流程整理为更稳定的 Jupyter Notebook 实现,而不是始终依赖完全自由的 Agent 决策。
这里需要强调,Robin 并没有实现无人参与的实验室自动化。系统负责提出假设、建议实验和分析数据,药物选择和实验方案仍经过研究人员审核,细胞培养、流式检测及 RNA-seq 等实际实验也由人工完成。其自动化主要集中在科学研究中的知识处理和计算分析环节。
3
实验验证:从黄斑变性研究到候选药物发现
为了验证 Robin 是否能够生成有实验价值的研究假设,团队选择了干性年龄相关性黄斑变性(dAMD)作为案例。dAMD 是一种与衰老密切相关的视网膜退行性疾病,可导致不可逆的视力下降,目前仍缺乏能够有效逆转疾病进程的治疗方法。
Robin 首先围绕 dAMD 的病理机制进行文献检索,阅读了 151 篇相关文献,并提出 10 个值得进一步研究的疾病机制。经过对机制和实验可行性的综合比较,系统最终选择了一个相对明确的方向:通过增强视网膜色素上皮细胞(Retinal Pigment Epithelium,RPE)的吞噬能力,探索潜在治疗策略。
RPE 细胞位于视网膜的重要功能层,负责清除感光细胞不断更新过程中产生的外节物质。随着年龄增长,这种清除能力可能下降,进而影响视网膜正常功能。因此,改善 RPE 的吞噬能力具有一定的疾病研究依据,也可以通过细胞实验和流式细胞术进行定量评估。
确定研究方向后,Robin 又检索了约 400 篇与 RPE 吞噬作用及 dAMD 治疗相关的文献,提出 30 个现有药物或干预候选,由 Falcon 进一步生成评估报告并排序。研究人员选取其中排名靠前的候选开展实验,同时加入已知具有相关作用的阳性对照,以判断系统提出的方向是否具有实际可验证性。

图 2 | Robin生成的研究假设及首轮细胞实验结果
首轮实验使用 ARPE-19 细胞,通过荧光标记微球和流式细胞术评估不同候选对吞噬能力的影响。实验完成后,团队将流式数据交给 Finch,后者自动生成 Jupyter 分析代码,完成细胞群体筛选、荧光信号统计和组间差异检验,并由人工对分析结果进行核对。
这一轮实验发现,ROCK 抑制剂 Y-27632 能够增强 RPE 细胞的吞噬能力。这个结果并不意味着 Robin 首次发现了 Y-27632 的这一作用,相关机制此前已有研究基础,但它说明系统能够从已有文献中提出合理假设,并通过实际实验获得支持。
在得到首轮结果之后,Robin 并没有直接结束任务,而是进一步提出通过 RNA-seq 研究 ROCK 抑制后细胞内部发生了哪些变化。研究人员随后对 Y-27632 处理后的细胞进行测序,Finch 使用 DESeq2 等工具完成差异表达分析和 Gene Ontology(GO)功能富集分析。需要说明的是,论文中的原始 RNA-seq Reads 拆分和比对由人工流程完成,Finch 主要负责后续基因计数数据的统计分析,并不是完全自动处理原始测序数据。
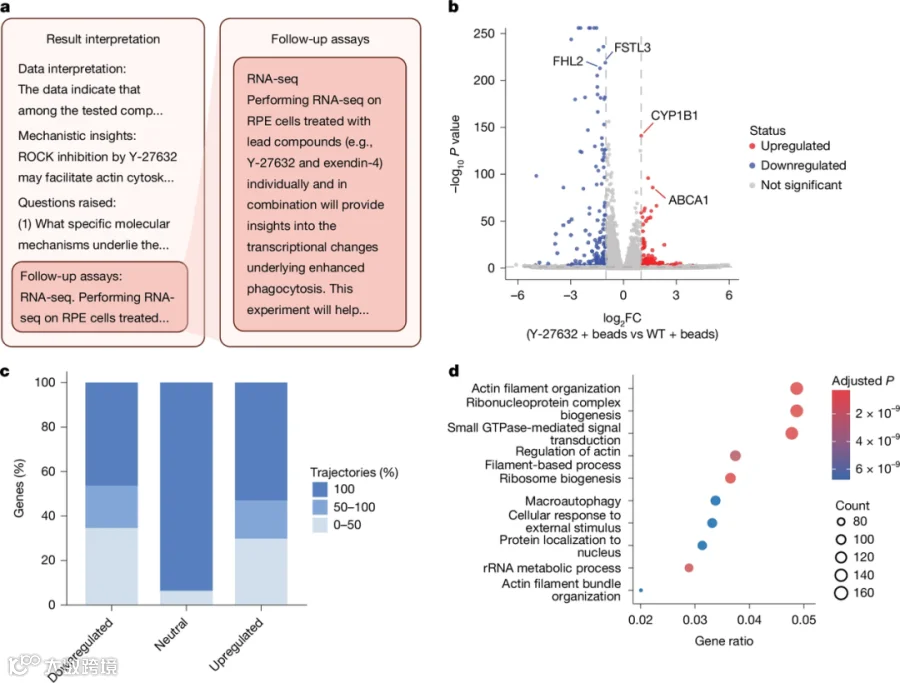
图 3 | RNA-seq分析揭示潜在分子机制
RNA-seq 结果显示,Y-27632 处理后,与细胞骨架、GTPase 信号转导和自噬相关的多个通路发生了变化。尤其值得注意的是,ABCA1 基因表达上调约 3 倍,校正后的 P 值为 2.13 × 10⁻⁸³。ABCA1 编码一种参与胆固醇和磷脂转运的蛋白,与 RPE 细胞的脂质代谢及正常功能有关。这一结果为后续研究提供了新的分子线索,但并不能仅凭差异表达就认定 ABCA1 是药物发挥作用的直接因果靶点。
论文随后开展了第二轮候选药物筛选。Robin 结合前一阶段的实验结果重新生成候选方案,研究人员对其中 10 个药物进行验证。结果发现,Ripasudil 在 ARPE-19 细胞中能够将吞噬能力提高到 DMSO 对照组的 1.89 倍,并且表现出比 Y-27632 更高的效力。
Ripasudil 本身并不是一种新开发的化合物,而是一种已在日本获批用于青光眼治疗的 ROCK 抑制剂。研究的意义在于,Robin 将这种已知药物与 dAMD 中的 RPE 吞噬功能联系起来,为其潜在的新适应症提供了实验线索。团队随后使用来自老年供体的人源 RPE 细胞进一步验证,仍然观察到了 Ripasudil 的吞噬增强作用;另外,系统还筛选出与昼夜节律调节相关的候选化合物 KL001。

图 4 | Ripasudil候选药物的实验验证
需要注意的是,这些结果仍然属于体外细胞实验。Ripasudil 已获批用于青光眼,并不代表其已被证明能够治疗 dAMD。研究尚未完成动物疾病模型和临床疗效验证,因此它目前仍是一项值得继续研究的药物再利用假设,而不是已经确立的治疗方案。
4
系统评估:多智能体协作究竟带来了多少收益
除了药物发现案例,论文还对 Robin 的计算效率和各个 Agent 的作用进行了评估。
在文献处理方面,Robin 在约 30 分钟内分析了 551 篇参考文献。作者根据既有文献阅读调查估算,人工完成相同规模的阅读可能需要约 294 小时。论文还估计,完整研究循环中的知识处理和分析劳动量可以从人工约 359~424 小时降低至不足 2 小时。不过,这些是基于工作量模型得出的时间估算,不是严格控制实验得到的人员耗时对比,也不包含细胞培养、测序和其他实际实验所需的等待时间。
研究团队进一步进行了 Agent 消融实验。当 Crow 或 Falcon 被一般大语言模型替代时,文献引用的可靠性和最终候选方案质量都会受到不同程度影响。特别是在移除负责深入文献评估的 Falcon 后,研究人员观察到更多无法核实的参考文献。这说明,在这项任务中,专业检索与证据整理模块不仅用于加速阅读,也对减少无依据的研究建议具有实际作用。
Finch 的表现则揭示了科研数据分析 Agent 的另一面。对于论文中经过专门提示词设计的 RNA-seq 和流式分析任务,Finch 能够较好地遵循专家制定的分析要求。但当研究人员使用来自 BixBench 的 170 个更广泛的问题测试它时,其总体准确率只有 22.8% ± 1.7%,其中生物信息学问题的准确率为 15.3% ± 2.0%,明显低于其在相对简单统计问题上的表现。作为对照,不具备数据访问和代码执行能力的 Claude 3.7 Sonnet 基础模型准确率为 1.6% ± 1.2%,但两者的工具和数据条件不同,因此不能将这一差异全部归因于 Agent 推理能力提升。
这些测试说明,科研 Agent 在经过良好设计的特定流程中可以取得不错的结果,但面对复杂、多步骤、参数敏感的生信任务时,仍然容易出现分析错误。工具能够执行,并不代表它自动保证了统计方法选择、实验设计或生物学解释的正确性。
5
总结
Robin 的主要贡献,是将过去相对分散的文献检索、假设生成和实验数据分析连接成了一个连续的科研循环。它不仅能够提出可能的研究方向,还能够根据真实实验数据更新假设,并推动下一轮候选筛选。在 dAMD 研究中,系统提出了增强 RPE 吞噬能力的研究方向,通过细胞实验识别了 Ripasudil 和 KL001 等候选,并借助 RNA-seq 发现了 ABCA1 等潜在分子线索。
这项工作距离完全自主的科学研究还有明显距离。实验操作仍依赖研究人员,关键科研参数和研究方案需要人工审核,部分数据预处理仍由人工完成,复杂生物信息学任务中的分析准确率也有待改善。不过,论文提供了一个相对完整的案例:AI Agent 已经可以在有限的科研场景中,围绕真实实验数据组织多轮研究,而不只是输出一次性的分析结果。
从技术实现来看,这篇论文同样说明,科研 Agent 的能力不只取决于底层大模型,还与专业检索、工具执行、运行环境、结果验证和多次分析的一致性有关。如何把这些能力组织成可靠、可追溯的工作流,仍然是这类系统真正进入科研实践时需要解决的问题。
基于文章中所使用的先进技术,包括深度学习,联川生物为您提供最前沿的生物分析解决方案。联川生物的专业团队将这些先进技术与丰富的经验相结合,为您提供高效、精准的服务。无论您的需求是基础研究还是临床诊断,我们都能够为您提供量身定制的解决方案。选择联川生物,让您的研究获得最新科技的支持,开创更广阔的科学道路。
参考文献:Ghareeb, A. E., Chang, B., Mitchener, L., et al. (2026). A multi-agent system for automating scientific discovery. Nature, 655, 497–505. https://doi.org/10.1038/s41586-026-10652-y
开源项目
Robin:https://github.com/Future-House/robin
Finch:https://github.com/Future-House/finch