大数跨境

自进化长效智能体:Prime Agent 项目全方位解析

自进化长效智能体:Prime Agent 项目全方位解析 联想全球安全实验室
2026-10-23
3
导读:记忆丢失、任务中断、无法进化?登顶 GitHub 热榜的开源智能体 Prime Agent,一次解决三大痛点。

点击蓝字

关注我们

Wh0Am1


前言

随着大模型智能体快速普及,传统 AI 助手的短板愈发凸显:会话记忆极易丢失、长周期任务频繁中断、运行规则固化僵硬、无法自主迭代优化。


在行业亟需“更长效、更聪明、能自我进化”的智能体范式下,今年 8 月,AI 基础设施团队 Prime Intellect 正式在 GitHub 开源 Prime Agent 项目。凭借递归语言模型 RLM 与长效自进化架构,该项目迅速登顶 GitHub 热榜,重新定义了下一代大模型智能体的运行逻辑,成为代码开发、科研推演、长期自动化任务场景的标杆级开源框架。

01

核心原理:递归语言模型(RLM),突破大模型上下文桎梏

Prime Agent 的核心底层,源自团队经典论文《Recursive Language Models》落地工程化方案。针对传统大模型超长文本理解弱、上下文窗口受限、长推理逻辑断裂的行业痛点,RLM  跳出了“无脑扩大窗口、堆参数量”的传统思路,从推理执行逻辑层面重构长文本处理范式。


简单来说:RLM 不把所有文本塞进模型脑袋,而是把文本变成“外部环境”,让模型学会像人一样分段精读、递归思考、汇总推理。


作为一套无需微调、模型无关的轻量化通用推理架构,RLM 可无缝适配 GPT、Claude、Llama、GLM 等全品类大模型。


其核心逻辑分为三层:

  • 外部文本环境化,彻底摆脱窗口限制

    RLM 将超长文本独立存储于外部 REPL 环境,不再强制一次性载入模型上下文。模型仅根据推理需求,按需调取、读取对应文本片段,从根源上解决大模型 Token 上限、长文本尾部信息丢失的问题。

  • 程序化递归拆解,模拟人类深度思考

    面对复杂长文本、大型工程任务,RLM 支持模型自主生成调度指令,完成文本切割、分段解析、分层推理。简单内容快速精读,复杂逻辑反复拆解、多层递归校验,完全复刻人类阅读长文档、梳理复杂项目的思考习惯,推理更细致、逻辑更闭环。

  • 全局结果聚合,全自动闭环推理

    所有子片段、子任务的递归推理完成后,模型会自动汇总、校验、整合全部中间结论,输出全局完整答案。全程无需人工分段、无需手动梳理逻辑,真正实现超长任务全自动推理。

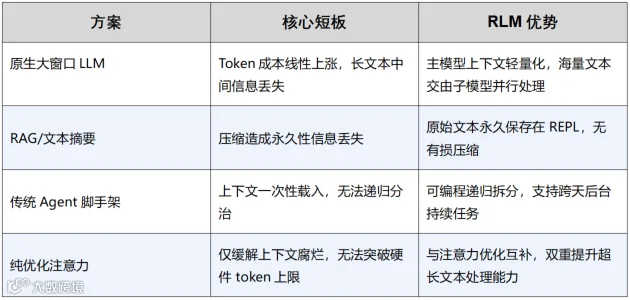
RLM 与传统长上下文方案核心差异

02

核心架构:Continual Harness 实现智能体真正自我进化

如果说 RLM解决了智能体“读得懂、推得动”超长复杂任务的问题,那么 Continual Harness(持续自适应脚手架),就是 Prime Agent 实现自我迭代、越用越强的核心关键。


传统智能体存在致命短板:所有提示词、技能、子 Agent 配置全部写死,属于静态框架。会话启动即固定、会话结束即清空,想要优化能力、调整策略,只能人工改代码、改提示词,AI 本身无法自主进化。

而 Continual Harness 是一套无重置、在线自适应、可持久化的智能体运行架构,彻底颠覆传统范式。


架构将智能体的核心能力资源,抽象为四类可读写、可迭代、可持久化的外部状态:

  • 补充提示词(additional prompts)

  • 长效记忆库(memory)

  • 自定义技能模板(skills)

  • 子智能体配置(sub-agents)

在任务执行全过程中,Agent 会实时检视自身执行轨迹、复盘成败经验,通过内置 refine 元操作,自主完成四类资源的新增、修改、删除与优化。更新状态即时生效,当前任务可直接复用,同时持久化落盘保存。


新会话启动时,智能体将自动加载历史沉淀的能力与经验,无需重置、无需复述需求、无需重新学习,真正实现持续在线自适应进化。


同时架构设置底层安全锁:基础系统提示词为只读状态,智能体仅能迭代附加层能力,无法篡改底层核心规则,所有迭代操作留存快照、支持回滚,彻底规避自我破坏风险。


搭配专属的 Daemon 后台守护进程,Prime Agent 实现了行业稀缺的离线驻留能力:终端关闭、窗口退出不影响任务运行,全程保存进度、日志与中间结论,完美支撑跨小时、跨天、跨周期的长效复杂任务。

03

核心能力:四大特色功能

重构 AI 工作模式

01


长效离线驻留,任务永不中断

针对代码重构、大型项目调试、算法推演、文献研读、漏洞排查等耗时任务,Prime Agent 支持后台静默驻留执行。


用户提交任务后可直接关闭设备,智能体持续推进工作、实时记录进度,下次连接无缝接续,彻底告别传统 AI “重启归零、重复沟通”的痛点。


02


原生多智能体协同,模拟团队作业

框架原生支持多子智能体调度与跨 Agent 通信。主智能体可根据任务复杂度,自动拆分、创建专业化子 Agent,分别负责编码、测试、验算、检索、文档整理等细分工作,多角色并行协作、数据互通,将大型复杂工程拆解为标准化流水线作业,大幅提升落地效率。


03


自主复盘迭代,持续沉淀经验

依托 Continual Harness 自进化机制,Prime Agent 每完成一次任务都会自动复盘反思,归纳最优工作方法、总结报错解决方案、固化优质代码模板、规避低效推理路径。经验永久沉淀、能力持续叠加,彻底摆脱传统 AI “每次对话从零开始”的局限,实现越用越专业、越跑越高效。


04


全链路原生代码开发适配

区别于通用 AI 简单叠加代码插件的方案,Prime Agent 从底层适配程序员工作流。


文件管理、版本控制、编译调试、单元测试、漏洞检测、文档生成全部原生支持,可一站式完成需求分析——代码编写——自测排错——工程优化——文档输出全流程开发,是当前开源生态中最贴合研发场景的智能体框架之一。

04

行业展望:下一代智能体,从工具走向“数字员工”

当前 AI 行业正在发生关键转折:智能体不再局限于单次问答、短时任务,而是向着长效驻留、自主思考、持续进化、无人值守的方向快速迭代。


Prime Agent 的核心价值,在于验证了一个全新方向:下一代顶尖智能体,不靠无限堆模型参数,而靠先进架构赋能模型能力。RLM 递归推理架构解决了长文本、复杂任务的推理瓶颈,Continual Harness 解决了智能体无法自我进化的核心痛点。


对普通开发者而言,它大幅降低了高阶智能体的搭建门槛,人人可部署长效自主开发助手;对行业而言,它推动 AI 从“被动工具”向“主动协作的数字员工”跃迁,为自动化研发、无人值守科研、长期智能运维等场景铺平道路。


未来,Prime Intellect 团队将持续迭代多模态适配、架构协同训练、轻量化部署、集群协作等能力。随着框架不断成熟,长效、自主、可进化的 AI 智能体,将全面融入各行各业,彻底重塑数字化生产与工作模式。


参考

  • Prime Agent 开源项目地址(GitHub):

    https://github.com/PrimeIntellect-ai/prime-agent

  • 递归语言模型(arXiv 论文):

    [2512.24601] Recursive Language Models

  • 持续自适应脚手架:自进化基础智能体的在线适应(arXiv 论文):

    [2605.09998] Continual Harness: Online Adaptation for Self-Improving Foundation Agents

  • 递归语言模型:2026 年的范式:

    Recursive Language Models: the paradigm of 2026


往期精彩合集


●Lenovo thinkstation PGX 修复与多卡连接

●模型再强也救不了:你还没看过推理引擎怎么跑

●色不异空——不可思议的“侧信道攻击”

●AI 安全进入 2.0 时代:Agent 正在成为企业新的安全边界

●从 PrivacyFence 看智能眼镜摄像头管控的标准化路径

【声明】内容源于网络
0
0
联想全球安全实验室
为联想产品提供安全保障
内容 232
粉丝 0
联想全球安全实验室 为联想产品提供安全保障
总阅读375
粉丝0
内容232