

过去三年,AI 基础设施的发展史几乎等同于 GPU 的扩张史。从 GPT-3 到万亿参数模型,计算量激增推动集群规模从千卡迈向十万卡。GPU 数量、FLOPS 及互联带宽成为衡量 AI 系统的关键指标。
2023 年,英伟达 H100 和 A100 供不应求,交付周期长达近一年。至 2024 年底,Meta 计划拥有等效 60 万颗 H100 的算力;xAI 的 Colossus 集群已扩展至 20 万颗 H100;微软更是规划通过专用网络连接数十万颗 GPU 与数百万个 CPU 核心,构建超大型 AI 计算系统。


位于亚特兰大费尔沃特园区的所有 GPU 之间通过高速、高吞吐量的网络共享信息。图片由微软提供。
随着 Blackwell Ultra 等新一代架构推出,英伟达将 GPU、HBM 和高速互联绑定为更大的计算域。以微软部署的 GB300 NVL72 为例,单机架可连接 72 颗 GPU,形成约 37TB 高速内存池,内部带宽高达 130TB/s。这种紧密组织旨在让成千上万颗 GPU 像一颗巨型 GPU 一样协同工作。
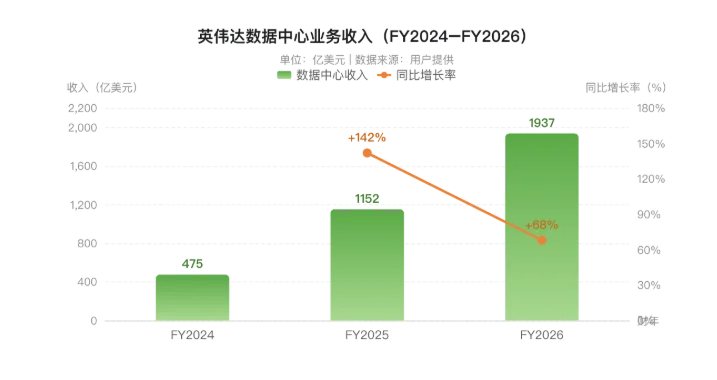
财务数据印证了这一趋势:英伟达数据中心业务收入在两年内增长约三倍,2026 财年达到约 1937 亿美元。其中,Compute 收入增长由 Blackwell 驱动,Networking 收入大幅增长则得益于 NVLink 和以太网设施的扩张。
然而进入 2026 年,行业风向出现微妙变化。当市场聚焦于 GPU 集群时,英伟达正式推出新一代 Vera CPU,并将其定位为“The CPU for Agents”。这标志着 CPU 在 AI 基础设施中的角色正被重新定义。
为什么 Agent 时代突然需要这么多 CPU?
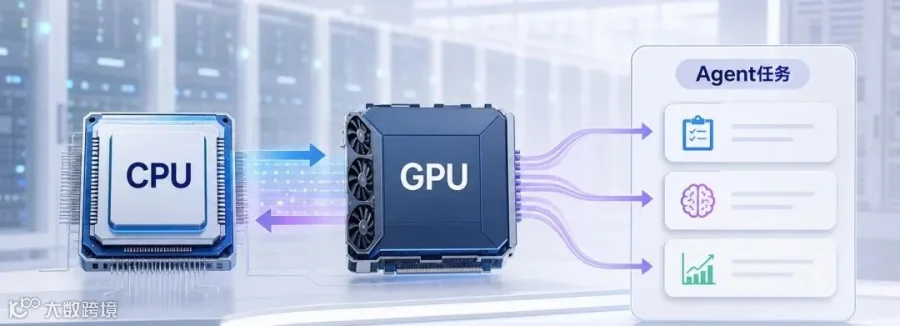
CPU 与 GPU 的配置比例正在发生显著变化。此前以 Chatbot 为主的系统中,CPU 与 GPU配比约为 1:4 至 1:8。而在 Agentic AI(代理式人工智能)场景下,这一比例正向 1:1 甚至更高靠拢。
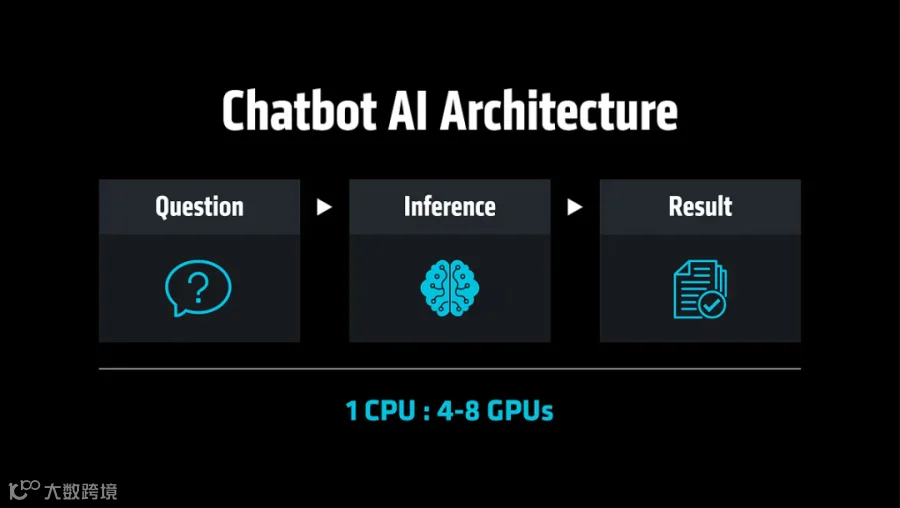
AMD 和英特尔均指出,随着 Multi-Agent 工作负载增加,CPU 的重要性日益凸显。这并非意味着 GPU 地位下降,而是工作负载性质发生了改变。
传统大模型训练主要依赖 GPU 进行大规模矩阵运算,CPU 仅负责调度。但在 Agent 场景中,任务链路被大幅拉长。以 Coding Agent 为例,其工作流程包括:任务拆解、代码检索、上下文构建、GPU 推理、工具调用(执行 Python/Shell)、结果反馈、再次推理等循环过程。
Imagination 首席商务官 Jake Kochnowicz 指出,Agent 在两次 GPU 推理之间插入了大量 CPU 工作,如沙箱代码执行、数据分析及编排逻辑。研究显示,在部分 Agent 工作负载中,CPU 上的工具处理可占请求延迟的 90% 以上,动态能耗占比最高达 44%。
微软 Azure 的研究也证实,Agent 请求会在 LLM 推理(GPU)、工具调用和编排决策(CPU)之间频繁切换。CPU 已进入关键路径,若其性能不足,将导致昂贵的 GPU 等待,从而降低整体系统效率。
AI 芯片真正昂贵的,不是“算”,是“搬”
CPU/GPU 配比变化的背后,折射出 AI 计算的核心矛盾已从峰值算力转向数据移动效率。
在异构 SoC 中,虽然 CPU、GPU 和 NPU 物理集成在一起,但数据跨越处理器边界时需经过内存读写和同步,产生所谓的“边境税”(Border Tax)。这不仅增加延迟,还消耗带宽和功耗。

在大模型 Decode 阶段,每生成一个 Token 都需访问权重和 KV Cache。若数据无法及时送达,再高的 FLOPS 也无法转化为实际性能。Agent 的出现进一步延长了数据路径:存储 -> CPU -> GPU -> CPU -> 工具 -> 存储... 这种复杂的交互使得“每秒有效数据送达量”比单纯的理论算力更为关键。
因此,评价 AI 系统的标准正从单芯片性能转向系统级效率,包括 Time to First Token、内存带宽利用率及数据移动成本。
CPU、GPU、NPU,被逼到了同一张桌子上
为解决数据移动瓶颈,处理器之间的界限正在模糊。CPU 开始集成向量及矩阵计算能力(如 Intel/AMD 的 ACE 扩展),GPU 增强通用计算和 AI 支持,NPU 则尝试适应更多算子。
这种融合趋势部分源于软件成本的考量。每增加一种独立加速器,就意味着额外的编程模型、驱动和维护成本。部分客户倾向于使用功能更强的 GPU 承担部分 NPU 工作,以减少软件栈复杂度。
未来,任务分配将不再拘泥于传统分工。模型推理仍主要由 GPU 承担,但任务编排和复杂控制流使 CPU 回归关键路径;端侧 AI 中,GPU 也开始分担部分神经网络计算。真正的竞争焦点在于如何通过软硬件协同,最小化数据移动成本,提升整体任务完成效率。
Agent 时代迫使计算系统重新分工。CPU、GPU 和 NPU 不再是孤立的存在,而是被迫坐在同一张桌子上,共同协作以应对日益复杂的 AI 工作负载。
参考链接:
https://omdia.tech.informa.com/blogs/2023/dec/server-market-will-be-worth-1956-billion-in-2027-according-to-omdias-data-center-server-tracker
https://nvidianews.nvidia.com/news/spectrum-x-ethernet-networking-xai-colossus
https://www.amd.com/en/blogs/2026/agentic-ai-changes-the-cpu-gpu-equation.html
声明:本文为 AI 前线原创,不代表平台观点,也不构成投资建议,未经许可禁止转载。
