大数跨境

模态缺失、噪声干扰怎么办?天津大学张长青:给多模态融合加上「可信度量尺」| CNCC 2026

模态缺失、噪声干扰怎么办?天津大学张长青:给多模态融合加上「可信度量尺」| CNCC 2026 AI科技评论
2026-10-23
2
导读:真正的挑战,是让模型保留有效信息、识别可靠证据,并适应新的任务。
真正的挑战,是让模型保留有效信息、识别可靠证据,并适应新的任务。

    作者丨张  璐

    编辑丨马晓宁


在具身智能、自动驾驶和智慧医疗等场景中,模型处理的数据维度远超图像、文本和语音。雷达、触觉、心电及各类传感器数据均可能成为决策依据。然而,多模态数据既有关联又存在不可替代性,且常面临模态缺失与噪声干扰等现实问题。
如何在融合信息时保留模态差异?当数据质量不一时,模型如何甄别可靠信息?若每遇新任务需重新训练,应用成本何以降低?
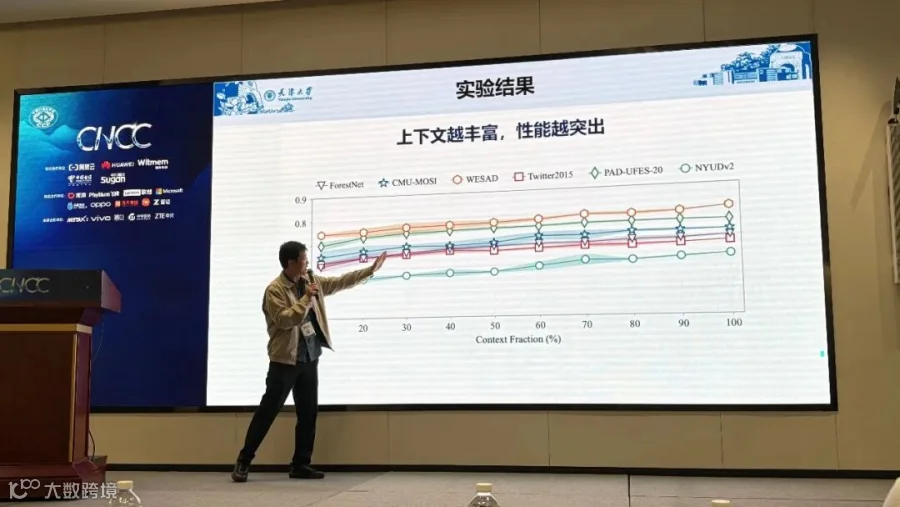
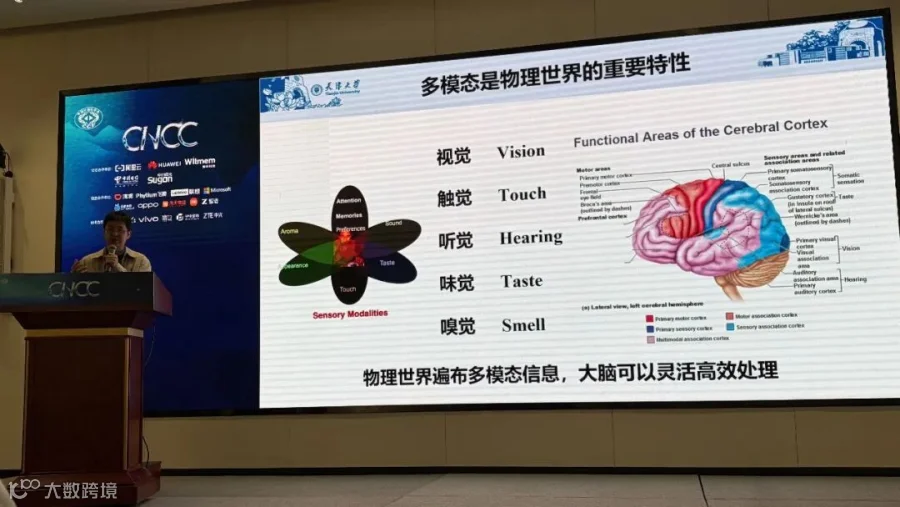
10月21日,在 CNCC 2026 首日 Tutorial 环节,天津大学人工智能学院教授张长青发表《广义多模态融合技术》报告,分享了团队在多模态表征、动态可信融合及通用预测基座方面的最新研究成果。
从保留模态特有信息,到基于证据评估不确定性,再到构建适应不同模态组合的基础模型,这些研究旨在解决核心问题:如何让多模态融合更好地适应真实世界的复杂性。

01


超越简单对齐:

如何兼顾模态的共性与个性?

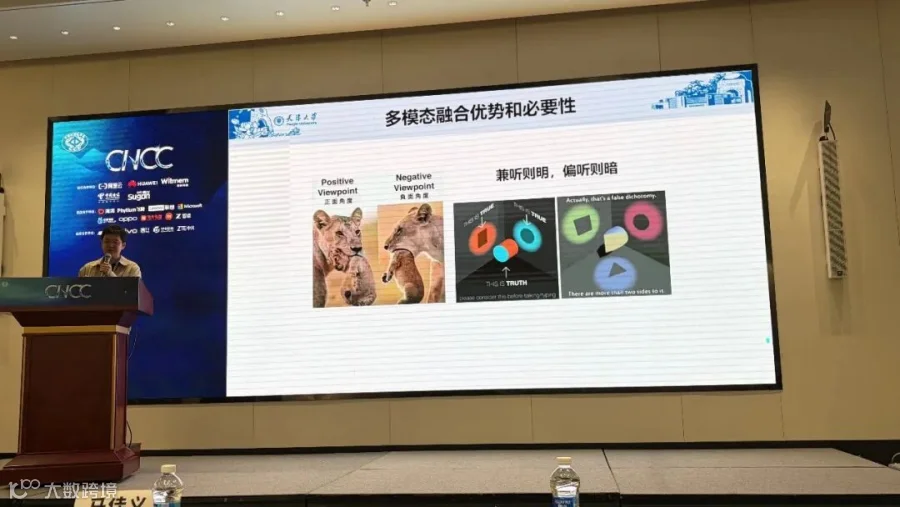
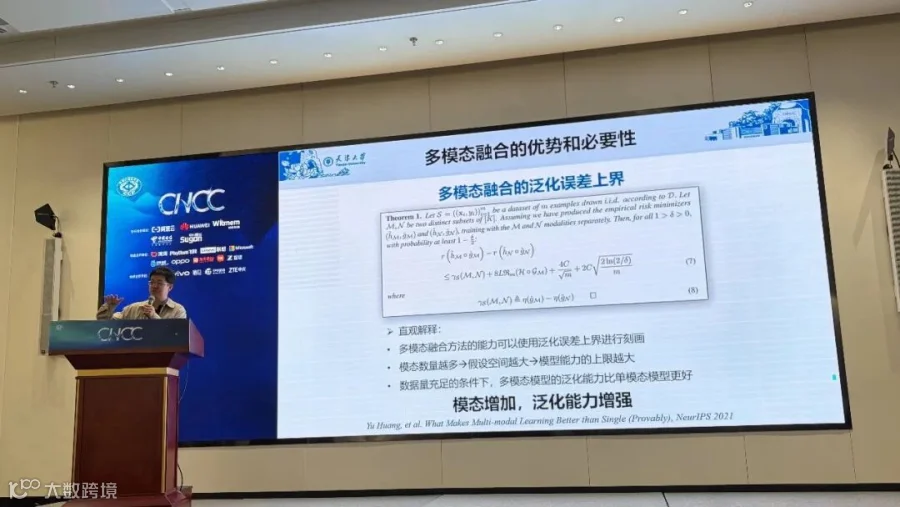
多模态融合的价值在于信息互补。单一模态仅能呈现部分特征,多模态结合有助于形成更全面的判断。但模态增加并不必然提升准确率,新增信息可能包含噪声或产生误导。因此,融合的关键不仅在于整合,更在于保留有效信息并抑制干扰。
张长青介绍了多模态表征的两种主流思路:联合表征(Joint Representation)与协同表征(Coordinated Representation)。前者将不同模态整合至共同表征,后者强调模态间关联。以典型相关分析(CCA)为例,其将模态映射到高相关性空间以利用共性。
然而,过度强调共享信息可能导致模态特有信息丢失。例如在医学诊断中,病原学检测识别病原体,CT影像显示病灶位置,两者互补且不可相互替代。因此,多模态表征需兼顾共性与个性,而非单纯追求一致性。
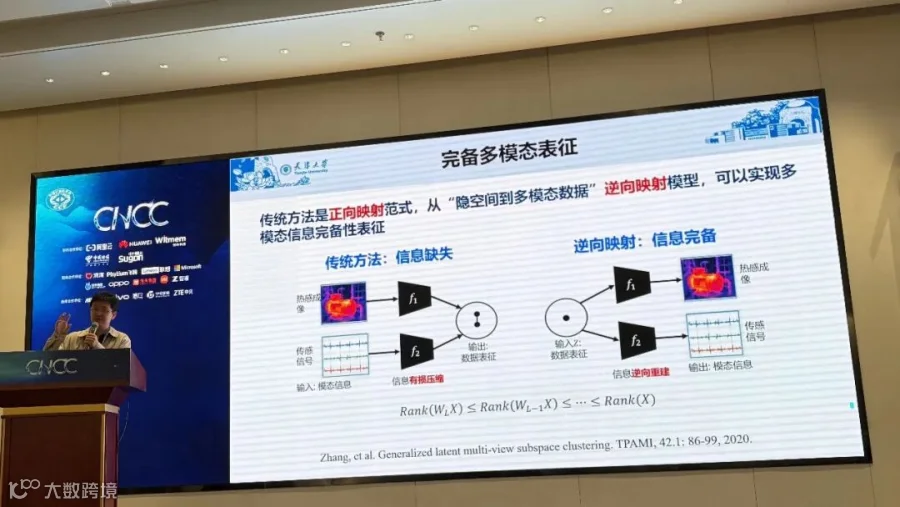
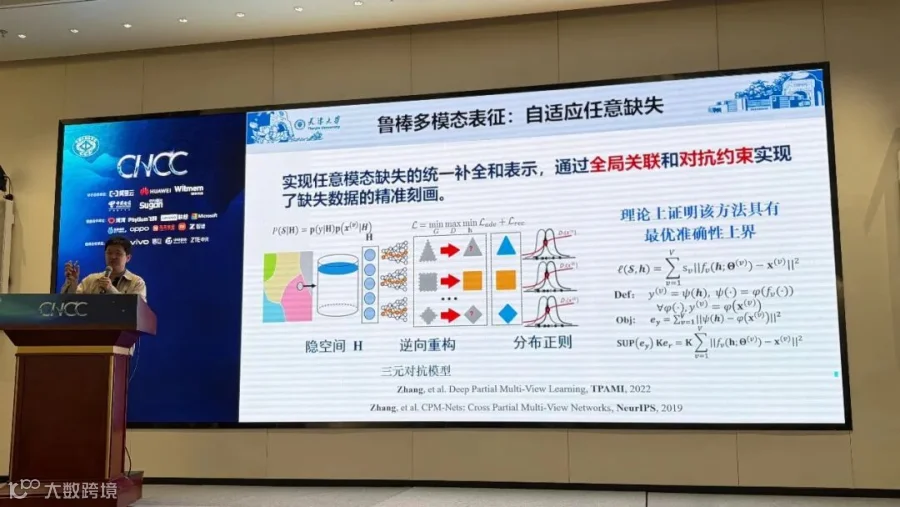
张长青团队提出新思路:不仅提取共同特征,还通过重构不同模态观测,学习容纳多种信息的潜在表征。
该方法将样本背后的潜在表征视为学习变量,通过不同映射机制重构各模态观测。相较于单纯映射到共同空间,这种方式从重构目标出发,更有效地保留了观测数据中的差异化信息。
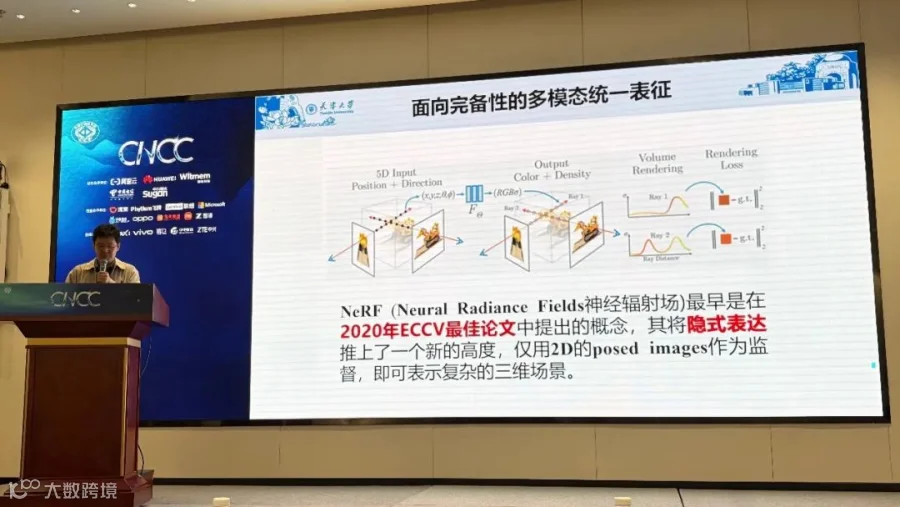
这一思路与神经辐射场(NeRF)有相似之处,即通过潜在表示解释多种观测,但具体任务机制不同。
该研究也致力于解决医疗、工业场景中的模态缺失问题。现实中患者检查项目各异,数据往往不完整。若算法强制补全所有缺失数据再预测,将面临高维补全困难及结果不可靠等挑战。
团队探索基于潜在表征的学习方法,利用现有可观测数据进行建模,无需对每种缺失情况进行人工补全,从而在模态缺失条件下有效利用已有信息。

02


从静态融合到动态可信决策:

模型如何判断信息是否可靠?

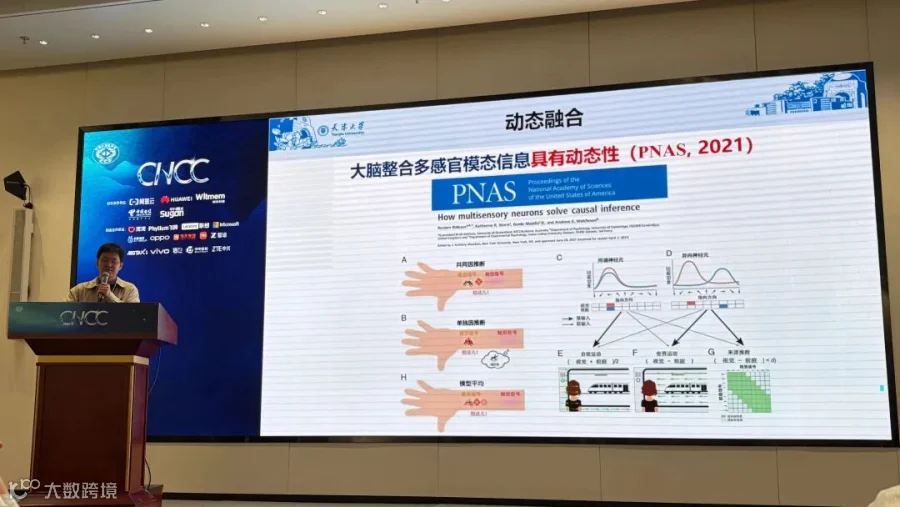
即使多模态均提供信息,其在具体任务中的价值亦随环境和样本动态变化。张长青以“打蚊子”为例:光线暗时依触觉拍打,光线足时先观察再行动。任务未变,但判断依据随可用信息调整。
在自动驾驶等场景中,可见光与热成像互补,但不同环境下有效性各异。若模型过度依赖某一模态,将无法充分利用其他信息。此前研究尝试依据光照等外部指标调整权重,但这不能完全代表图像对特定任务的判别价值。
张长青团队引入不确定性估计,提出可信多视图分类方法 TMC。该方法利用变分狄利克雷分布刻画类别概率,结合 Dempster–Shafer 证据理论融合不同视图证据,以估计预测不确定性。
相比单一分类结果,该方法还能回答:当前判断有多少证据支持?信息来源是否一致?证据是否足以支持可靠判断?这在信息质量不稳定场景中尤为重要,模型可根据证据质量调整融合结果。
在晶体结构识别应用中,不同观测角度信息量差异大。动态融合根据每次观测提供的证据更新判断,并在不确定性达标时决定是否继续采集数据。实验显示,该任务分类准确率从约58%—59%提升至939%左右。
此类研究关注点不仅是信息聚合,更是基于证据质量形成判断,并在适当时机停止数据收集。

03


Fusion Anything:

探索通用多模态预测基座
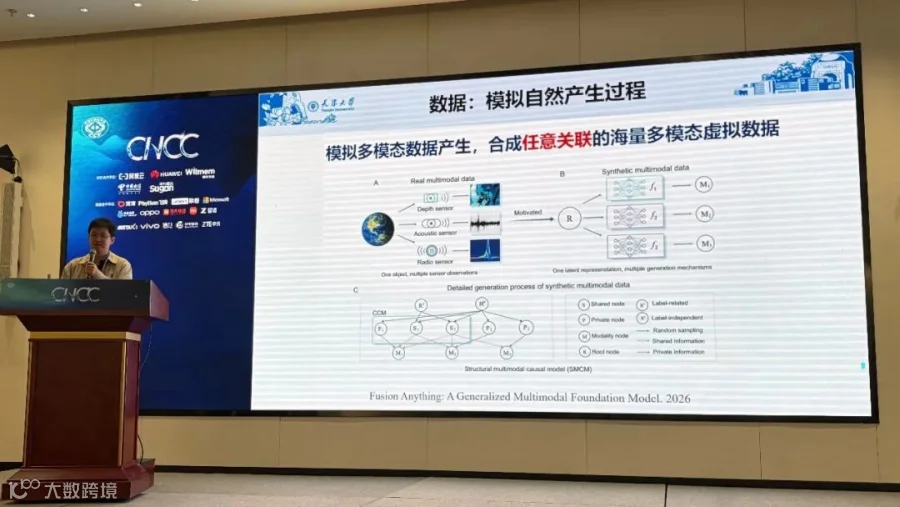
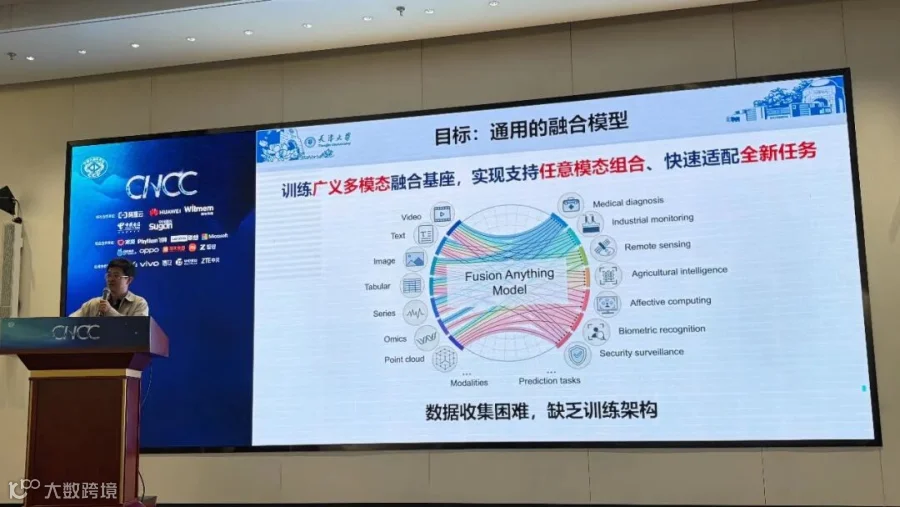
在前两部分基础上,张长青介绍了通用多模态预测基座——Fusion Anything Model(FAM)。相关论文《Fusion Anything: A Generalized Multimodal Foundation Model》提出更具普适性的问题:能否训练一个模型,不再局限于预指定模态组合和单一任务,而是利用上下文样例适应不同多模态预测任务?
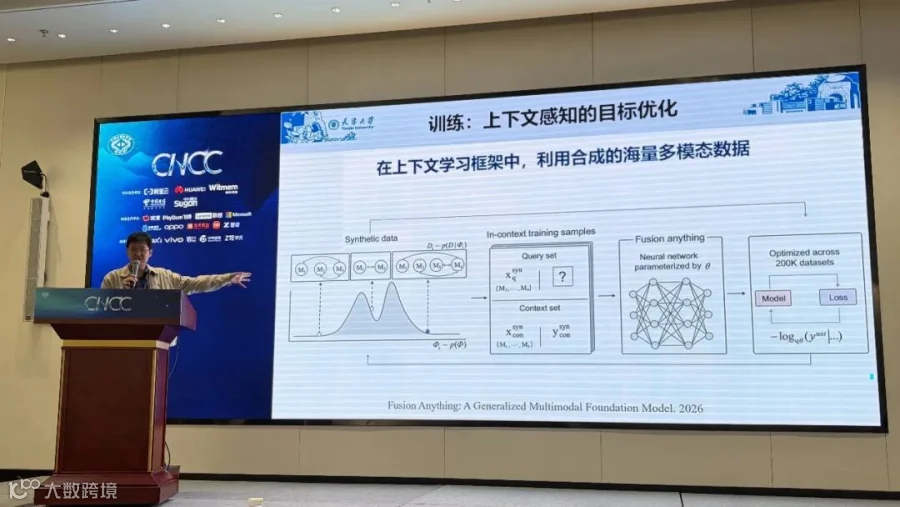
传统多模态模型针对特定数据类型和任务设计,迁移成本高。FAM 希望通过预训练学习可迁移的多模态关联模式,面对新任务时利用给定上下文样例完成预测,无需重新更新模型参数。
为解决真实世界多模态数据难以覆盖所有组合的问题,团队采用结构多模态因果模型(SMCMs)生成合成多模态预测任务,构造具有不同相关模式的数据。
FAM 架构包含三类注意力机制:
  • 模态内注意力(Intra-modality Attention):建模同一模态内部不同特征关系。
  • 跨模态注意力(Cross-modality Attention):建模同一样本中不同模态间关系。
  • 样本级注意力(Sample-level Attention):利用上下文样例信息,辅助模型根据已有样例预测新样本。
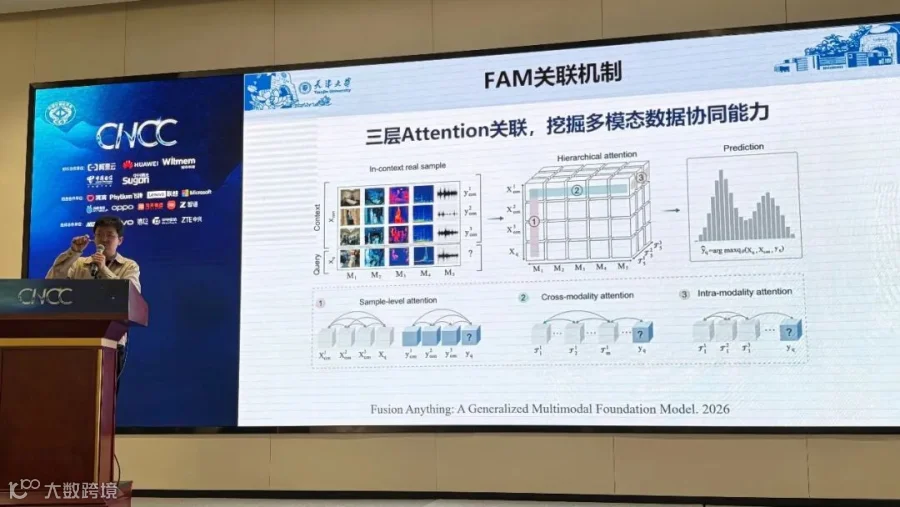
这三类机制分别关注模态内、模态间及样本间关联,共同支持多模态预测。需注意,FAM 推理阶段采用上下文学习(In-context Learning),虽无需参数微调,但仍需上下文样例提供任务信息。
评估显示,FAM 在18个真实数据集、12种模态和11类预测任务上表现具备竞争力,平均准确率较专用融合基线提高约6.9个百分点,但在不同数据集上表现存在差异。
在实际任务测试中,FAM 用于视触觉抓取成功率预测,表现与专用方法接近;在强化学习评分任务中,结合文本指令和视频观测,方案优于基线;在皮肤病诊断测试中,与 PanDerm 等方法进行了比较。这些结果展示了通用多模态预测模型的应用潜力,但不能直接推导其在所有场景均优于专用模型。
此外,团队展示了历史手稿识别测试,证明通用框架可整合视觉、前后文等辅助信息。Fusion Anything 的目标并非立即取代所有专用模型,而是降低新任务适配成本,提升多模态融合的迁移灵活性。
目前,该方向仍需深入研究模型后训练、垂域适配、模态编码器选择及在真实机器人系统中的可靠应用等问题。
综上所述,多模态融合研究涵盖三个层面:表征阶段兼顾共性与个性;决策阶段利用证据评估不确定性;通用模型层面适应新模态组合与任务。这些研究指向明确方向:让多模态模型更高效地利用信息,并减少重复设计训练成本。

CNCC 即将召开,欢迎参会的研究者、学生,以及关注计算机领域前沿进展的读者加入我们的 CNCC 交流社群。

在这里,你可以认识同行、交流研究,分享招生信息、科研合作、约饭、投稿、组队参会等,寻找潜在的合作伙伴。

大会期间,我们也会持续带来现场报道速递、嘉宾演讲解读、前沿方向梳理和论坛精华。

会场见,也在群里见。
上车,带你看遍全球 AI 顶会精华

可独家畅览:

专家演讲PPT

大会报告全文

热门论文解读

学术新星访谈

//

推荐阅读

超万人齐聚成都!CNCC2026今日开幕:不仅回答「做了什么」,更指引「往哪里走」


康奈尔大学Steven Waslander:从「堆数据」到「用记忆」,拆解 Agentic 仓库机器人的长期记忆难题 | IROS 2026

未经「AI科技评论」授权,严禁以任何方式在网页、论坛、社区进行转载!

公众号转载请先在「AI科技评论」后台留言取得授权,转载时需标注来源并插入本公众号名片。

【声明】内容源于网络
0
0
AI科技评论
聚焦AI前沿研究,关注AI工程落地。
内容 9007
粉丝 0
AI科技评论 聚焦AI前沿研究,关注AI工程落地。
总阅读286.0k
粉丝0
内容9.0k